
Apache Beam window cho dữ liệu web: event time và dữ liệu trễ
Apache Beam window cho dữ liệu web là cách chia dòng kết quả crawl thành các cửa sổ thời gian, ví dụ mỗi giờ một cửa sổ. Sau đó mỗi cửa sổ được tổng hợp riêng: bao nhiêu trang tải được, giá trung bình bao nhiêu. Câu hỏi then chốt là thời gian nào: lúc trang được tải, hay lúc bản ghi tới hệ thống xử lý. Hai mốc này khác nhau khi có bản ghi đến trễ, và kết quả tổng hợp khác theo. ProxyVN chạy Apache Beam 2.77.0 với DirectRunner ngày 03/11/2026, dùng TestStream để đưa vào các bản ghi đến trễ có kiểm soát, so ba cấu hình xử lý trễ và so gom theo giờ tải với gom theo giờ đến. Bài ghi lại kết quả từng cửa sổ.
Apache Beam window cho dữ liệu web: mục tiêu và phạm vi không lặp
Phần này chốt bài toán, đầu ra và ranh giới.
Bài toán
Một hệ thống crawl đẩy kết quả từng trang vào luồng xử lý. Báo cáo cần số trang tải được mỗi giờ theo từng tên miền. Một số máy crawl gửi kết quả chậm vì mạng hay vì hàng đợi tồn đọng. Bản ghi tải lúc 00:40 có khi tới hệ thống lúc 01:31. Báo cáo phải đếm nó vào giờ 00 hay giờ 01, và nếu đã chốt số giờ 00 rồi thì làm gì với bản ghi trễ.
Đầu ra nghiệm thu
Đầu ra gồm pipeline Beam gom theo cửa sổ một giờ trên event time, kết quả của cùng dữ liệu với ba cấu hình xử lý trễ, và so sánh với cách gom theo giờ đến. Mỗi cấu hình phải cho thấy rõ bản ghi trễ được đếm hay bị bỏ.
Không dựng crawler bằng Beam
Bài không dùng Beam để tải trang. Beam xử lý dữ liệu đã có: kết quả crawl đã được tạo ở nơi khác và đẩy vào. Phần tải trang, giới hạn tốc độ, xử lý lỗi HTTP nằm ngoài phạm vi.
Phiên bản đã khóa
Lab dùng apache-beam 2.77.0 trong Python 3.12, chạy DirectRunner cục bộ ở chế độ streaming với TestStream. Không có Dataflow, Flink hay Spark. DirectRunner dành cho thử nghiệm, hành vi cửa sổ và trigger giống các runner khác theo mô hình Beam, thời gian thì không.
Ai nên đọc
Người tổng hợp dữ liệu crawl theo thời gian và thấy số liệu giờ trước thay đổi khi chạy lại. Người đang dùng Beam và chưa rõ vì sao một số bản ghi biến mất khỏi kết quả. Người cần giải thích cho người dùng báo cáo vì sao số giờ 00 có hai phiên bản.
Batch và streaming trong Beam
Beam dùng cùng một mô hình cho xử lý theo lô và xử lý luồng. Pipeline viết một lần có thể chạy trên dữ liệu có sẵn hoặc dữ liệu đang tới. Khác biệt nằm ở chỗ dữ liệu luồng không bao giờ biết chắc đã đủ, nên cần watermark và trigger. Bài này tập trung vào chế độ luồng, nơi dữ liệu trễ là vấn đề thật.
Vì sao dùng TestStream
Dữ liệu trễ trong thực tế xảy ra ngẫu nhiên, khó lặp lại. TestStream cho phép đưa từng bản ghi vào kèm event time và tự điều khiển watermark, tức mốc mà hệ thống tin rằng dữ liệu trước đó đã tới đủ. Nhờ vậy, mỗi lần chạy lab cho cùng kết quả.
Phân biệt event time với processing time khi tổng hợp kết quả crawl bằng Beam với Apache Beam window cho dữ liệu web
Phần này giải thích các khái niệm.
Event time và processing time
Theo Beam Programming Guide, mỗi phần tử có một timestamp gắn với nó, thường là thời điểm sự kiện xảy ra. Đó là event time. Processing time là thời điểm phần tử được hệ thống xử lý. Với dữ liệu crawl, event time là lúc tải trang, processing time là lúc bản ghi tới pipeline.
Cửa sổ tính theo UTC
Cửa sổ cố định một giờ bắt đầu từ mốc giờ tròn theo UTC. Cửa sổ 00:00 tới 01:00 UTC là 07:00 tới 08:00 giờ Việt Nam. Báo cáo cho người Việt cần quy đổi khi hiển thị. Nếu cần cửa sổ theo ngày Việt Nam, FixedWindows có tham số offset để dịch điểm bắt đầu.
Cửa sổ cố định
FixedWindows chia trục thời gian thành các đoạn bằng nhau không chồng lấn. Với cửa sổ một giờ, bản ghi có event time 00:40 thuộc cửa sổ 00:00 tới 01:00, bất kể nó tới lúc nào. Gom theo khóa trong cửa sổ cho ra một kết quả cho mỗi cặp khóa và cửa sổ.
Watermark do nguồn ước lượng
Với nguồn thật như Kafka hay Pub/Sub, watermark do runner và nguồn ước lượng dựa trên timestamp của dữ liệu đã thấy. Ước lượng có thể sai: watermark tiến quá nhanh làm nhiều dữ liệu bị coi là trễ, tiến quá chậm làm kết quả đến muộn. TestStream cho phép đặt watermark chính xác, nên lab loại được yếu tố này.
Watermark
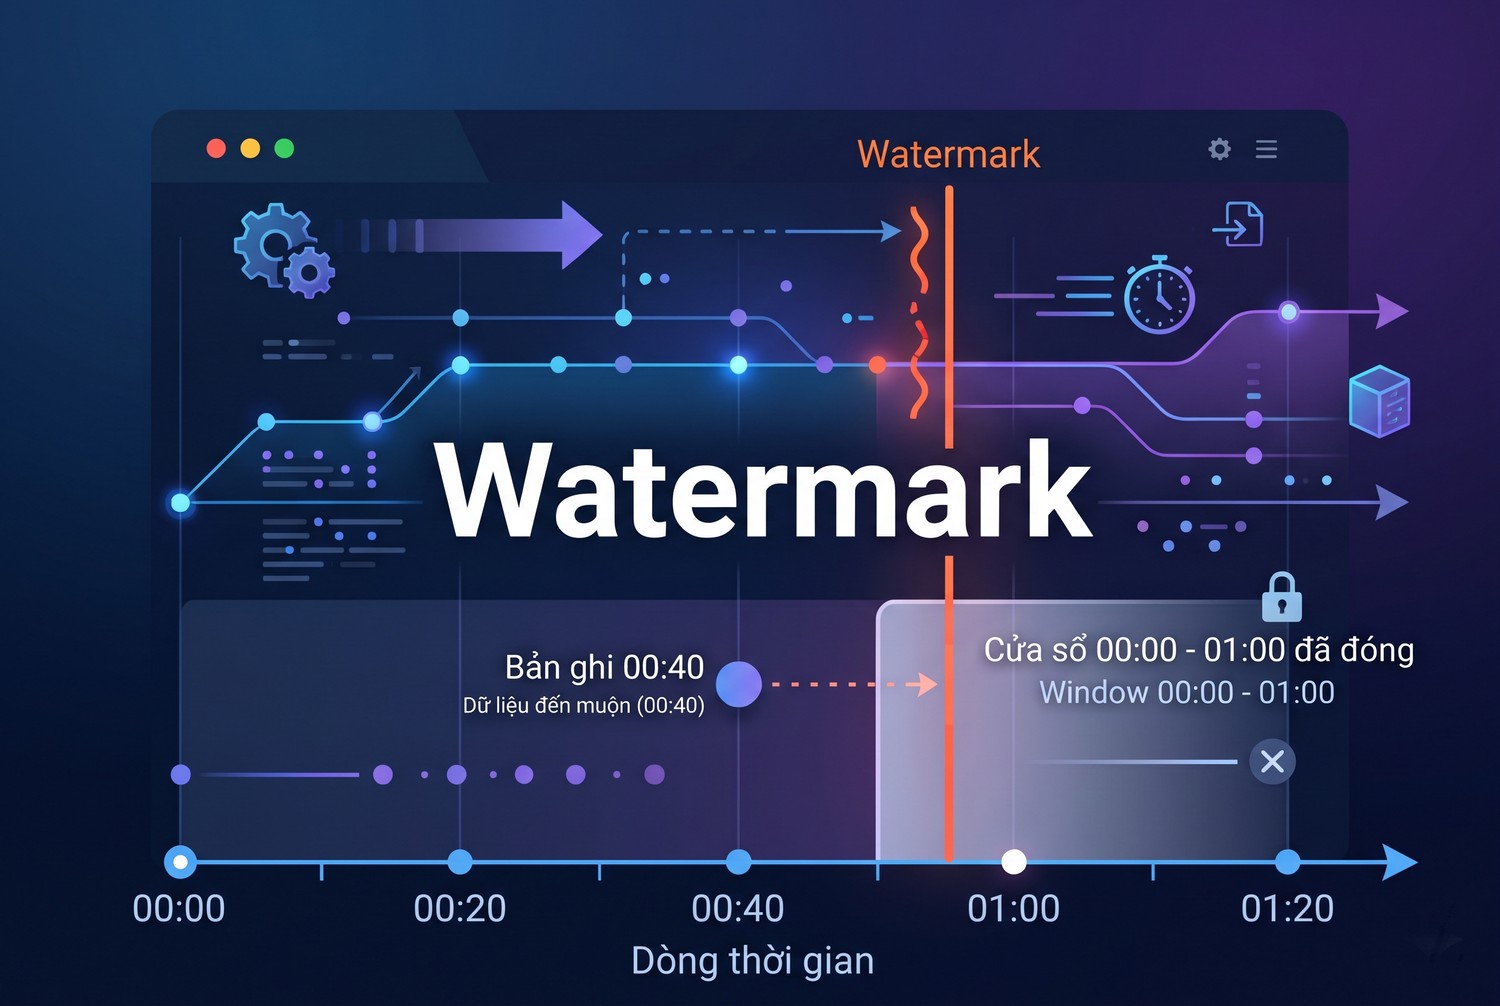
Watermark là ước lượng của hệ thống về tiến độ event time: mọi dữ liệu có event time trước watermark được coi là đã tới. Khi watermark vượt qua cuối một cửa sổ, cửa sổ đó được coi là đủ và có thể xuất kết quả.
Dữ liệu trễ
Bản ghi có event time thuộc một cửa sổ đã bị watermark vượt qua là dữ liệu trễ. Ví dụ, watermark đã ở 01:30, cửa sổ 00:00 tới 01:00 đã chốt, rồi bản ghi 00:40 mới tới. Beam phải quyết định đếm nó hay bỏ.
Trễ theo watermark, không theo đồng hồ
Bản ghi được coi là trễ dựa trên watermark, không dựa trên đồng hồ máy. Nếu watermark tiến chậm vì nguồn ít dữ liệu, một bản ghi tới muộn vài giờ theo đồng hồ vẫn có thể đúng hạn. Ngược lại, watermark tiến nhanh làm bản ghi chỉ chậm vài phút cũng thành trễ.
Allowed lateness
allowed_lateness là khoảng thời gian sau cuối cửa sổ mà Beam vẫn nhận dữ liệu trễ cho cửa sổ đó. Mặc định bằng 0: dữ liệu trễ bị bỏ. Đặt 2 giờ thì bản ghi tới khi watermark chưa vượt cuối cửa sổ cộng 2 giờ vẫn được tính.
Khóa và cửa sổ
Trong Beam, gom theo khóa diễn ra riêng trong từng cửa sổ. Cùng khóa shop-a ở hai cửa sổ khác nhau là hai nhóm độc lập. Vì vậy, dữ liệu trễ chỉ ảnh hưởng tới cửa sổ của nó, không làm thay đổi kết quả các cửa sổ khác.
Trigger và pane
Trigger quyết định khi nào xuất kết quả của một cửa sổ. AfterWatermark xuất khi watermark vượt cuối cửa sổ, pane đó gọi là đúng hạn. Thêm late bằng AfterCount(1) thì mỗi bản ghi trễ làm xuất thêm một pane trễ. Một cửa sổ có thể có nhiều pane.
Mặc định của Beam
Không khai báo gì, Beam dùng trigger mặc định xuất một lần khi watermark vượt cuối cửa sổ, allowed_lateness bằng 0, chế độ DISCARDING. Với dữ liệu không bao giờ trễ, mặc định này đủ. Với dữ liệu crawl từ nhiều máy, dữ liệu trễ là chuyện thường, mặc định sẽ làm mất số liệu.
Chế độ cộng dồn
DISCARDING nghĩa là mỗi pane chỉ chứa phần mới kể từ pane trước. ACCUMULATING nghĩa là mỗi pane chứa toàn bộ dữ liệu của cửa sổ tới thời điểm đó. Với đếm, DISCARDING cho số gia tăng, ACCUMULATING cho tổng mới nhất.
Dựng TestStream với bản ghi đến trễ cho Apache Beam window cho dữ liệu web
Phần này mô tả dữ liệu đưa vào.
Bản ghi đúng hạn
Ba bản ghi của shop-a với event time 00:10, 00:50 và 01:05 ngày 02/11 UTC được đưa vào đầu tiên. Hai bản đầu thuộc cửa sổ giờ 00, bản thứ ba thuộc cửa sổ giờ 01.
Watermark tới 01:30
Watermark
Watermark được đẩy tới 01:30. Cửa sổ 00:00 tới 01:00 đã qua, xuất pane đúng hạn với 2 trang.
Vì sao chọn 30 phút
Bản ghi 00:40 tới khi watermark ở 01:30, trễ 30 phút sau khi cửa sổ giờ 00 đóng. Con số này nằm trong ngưỡng 2 giờ của cấu hình thứ hai và ngoài ngưỡng 0 của cấu hình thứ nhất. Nhờ vậy, cùng một bản ghi cho hai kết quả khác nhau tùy cấu hình.
Bản ghi trễ thứ nhất
Bản ghi event time 00:40 được đưa vào sau khi watermark đã ở 01:30. Nó thuộc cửa sổ giờ 00, đã chốt 30 phút trước theo watermark.
Thứ tự đưa vào không quyết định kết quả
TestStream đưa bản ghi theo thứ tự định trước, nhưng Beam xếp bản ghi vào cửa sổ dựa trên event time, không theo thứ tự đến. Bản 00:40 đến sau bản 01:05 vẫn vào cửa sổ giờ 00. Thứ tự chỉ quyết định bản ghi là đúng hạn hay trễ so với watermark.
Watermark tới 02:30 và bản ghi trễ thứ hai
Watermark được đẩy tới 02:30, cửa sổ giờ 01 chốt với 1 trang. Rồi bản ghi event time 01:20 được đưa vào, trễ cho cửa sổ giờ 01. Cuối cùng watermark được đẩy tới vô cực để mọi cửa sổ đóng.
Một tên miền cho dễ đọc
Để kết quả dễ đọc, lab chỉ dùng một tên miền shop-a để mỗi cửa sổ có đúng một dòng kết quả. Với nhiều tên miền, mỗi cặp tên miền và cửa sổ có pane riêng, logic không đổi. Kết quả nhiều tên miền dài hơn nhưng không thêm điều gì mới về xử lý trễ.
Pipeline
(p | ts
   | beam.WindowInto(window.FixedWindows(3600),
       trigger=trigger.AfterWatermark(late=trigger.AfterCount(1)),
       accumulation_mode=accum, allowed_lateness=lateness)
   | beam.Map(lambda r: (r["domain"], 1))
   | beam.CombinePerKey(sum)
   | beam.ParDo(fmt))
Cửa sổ một giờ, trigger xuất đúng hạn và xuất thêm mỗi bản trễ, đếm theo tên miền. Hàm fmt in cửa sổ, số trang và thông tin pane.
Thông tin pane
PaneInfo có timing và index. Trong lab, timing bằng 1 là đúng hạn, bằng 2 là trễ. index là số thứ tự pane trong cửa sổ, bắt đầu từ 0. Đọc hai giá trị này cho biết một kết quả là con số đầu tiên hay một bản cập nhật.
Đếm thay cho tính giá
Lab đếm số trang thay vì tính giá trung bình, vì phép đếm dễ thấy khi thiếu hay thừa một bản ghi. Giá trung bình thiếu một bản ghi chỉ lệch một chút, khó nhận ra. Với dữ liệu thật, cùng cơ chế áp dụng cho mọi phép tổng hợp, chỉ là sai lệch khó thấy hơn.
Kết quả đúng phải là gì
Nếu đếm theo event time và nhận đủ dữ liệu trễ, cửa sổ giờ 00 có 3 trang, giờ 01 có 2 trang. Đây là con số mà báo cáo cuối cùng nên hiển thị.
Chạy ba cấu hình allowed_lateness và chế độ cộng dồn trong Apache Beam window cho dữ liệu web
Phần này đọc kết quả.
allowed_lateness bằng 0
Dữ liệu trễ bị bỏ
Cửa sổ |
Số trang |
Pane |
|---|---|---|
00:00 tới 01:00 |
2 |
đúng hạn, index 0 |
01:00 tới 02:00 |
1 |
đúng hạn, index 0 |
Hai bản ghi trễ không xuất hiện ở đâu cả. Cửa sổ giờ 00 dừng ở 2 trang thay vì 3, giờ 01 dừng ở 1 thay vì 2. Không có lỗi, không có cảnh báo.
Đếm bản ghi bị bỏ
Một số runner có chỉ số đếm phần tử trễ bị bỏ. DirectRunner trong lab không in ra con số này. Trong môi trường thật, nên theo dõi chỉ số đó nếu runner có, hoặc tự đếm bằng cách so tổng bản ghi đầu vào với tổng bản ghi trong mọi pane đầu ra.
Dữ liệu trễ bị bỏ lặng lẽ
Đây là hành vi mặc định. Với dữ liệu crawl có máy gửi chậm, báo cáo sẽ thiếu một phần số liệu mà không ai biết. Số thiếu phụ thuộc vào tỷ lệ bản ghi trễ, có thể nhỏ hôm nay, lớn hôm khác khi một máy crawl bị nghẽn.
Không cần đổi mã đếm
Ba cấu hình dùng cùng bước đếm CombinePerKey(sum). Chỉ tham số của WindowInto khác nhau. Cách Beam tách logic tính toán khỏi logic thời gian giúp đổi chính sách xử lý trễ mà không sửa phép tính. Đây là lợi thế lớn khi cần điều chỉnh theo dữ liệu thật.
allowed_lateness 2 giờ, DISCARDING
Cửa sổ |
Số trang |
Pane |
|---|---|---|
00:00 tới 01:00 |
2 |
đúng hạn, index 0 |
00:00 tới 01:00 |
1 |
trễ, index 1 |
01:00 tới 02:00 |
1 |
đúng hạn, index 0 |
01:00 tới 02:00 |
1 |
trễ, index 1 |
Mỗi cửa sổ có hai pane. Pane trễ chỉ chứa phần mới: 1 trang. Bên nhận kết quả phải cộng hai pane để ra tổng 3 và 2.
allowed_lateness 2 giờ, ACCUMULATING
Cửa sổ |
Số trang |
Pane |
|---|---|---|
00:00 tới 01:00 |
2 |
đúng hạn, index 0 |
00:00 tới 01:00 |
3 |
trễ, index 1 |
01:00 tới 02:00 |
1 |
đúng hạn, index 0 |
01:00 tới 02:00 |
2 |
trễ, index 1 |
Pane trễ chứa tổng mới: 3 và 2. Bên nhận chỉ cần ghi đè con số cũ bằng con số mới.
Pane trễ mang thông tin
Bên nhận có thể đọc timing của pane để biết kết quả là đúng hạn hay trễ. Báo cáo có thể hiển thị số giờ 00 kèm dấu đã cập nhật khi có pane trễ. Người đọc báo cáo biết số liệu vừa thay đổi và lý do, thay vì thấy con số tự nhiên khác đi.
Chọn chế độ theo bên nhận
Nếu kết quả ghi vào bảng có khóa là tên miền và cửa sổ, ACCUMULATING kèm upsert là đơn giản nhất: pane mới thay pane cũ. Nếu kết quả là luồng sự kiện cộng dồn ở phía sau, DISCARDING tránh đếm hai lần. Chọn sai sẽ ra số gấp đôi hoặc số thiếu.
Pane cuối cùng
Mọi pane trong lab có is_last bằng False ở chế độ streaming, vì cửa sổ vẫn mở để nhận dữ liệu trễ cho tới khi hết allowed_lateness. Ở phần batch, pane có is_last bằng True vì không còn dữ liệu nào tới. Bên nhận có thể dùng is_last để biết khi nào số liệu của cửa sổ đã chốt.
Bản trễ quá hạn
Lab chọn bản trễ nằm trong 2 giờ. Một bản ghi tới khi watermark đã vượt cuối cửa sổ cộng allowed_lateness sẽ bị bỏ, kể cả ở cấu hình 2 giờ. allowed_lateness không loại bỏ vấn đề, chỉ đặt ranh giới. Bản trễ hơn ranh giới cần một đường xử lý khác, ví dụ chạy lại lô theo ngày.
Chọn allowed_lateness bằng số đo
Đo độ trễ thật giữa thời điểm tải và thời điểm tới pipeline trong vài ngày. Phân vị 99 của độ trễ là điểm bắt đầu hợp lý cho allowed_lateness. Bản ghi trễ hơn thế hiếm, để cho lần chạy batch hằng ngày xử lý. Cách này cân bằng giữa đầy đủ và chi phí giữ trạng thái.
Giữ trạng thái tốn tài nguyên
Allowed lateness càng dài, runner càng phải giữ trạng thái của cửa sổ lâu sau khi cửa sổ đóng. Với hàng nghìn tên miền và cửa sổ một giờ, giữ trạng thái 2 ngày có thể tốn bộ nhớ đáng kể. Lab nhỏ không thấy được chi phí này.
Gom theo giờ tải và gom theo giờ đến trong Apache Beam window cho dữ liệu web
Phần này so hai cách gán thời gian cho cùng năm bản ghi.
Dữ liệu
Năm bản ghi có giờ tải và giờ đến: 00:10 tới lúc 00:12, 00:50 tới lúc 00:51, 01:05 tới lúc 01:06, 00:40 tới lúc 01:31, 01:20 tới lúc 02:31. Hai bản cuối là hai bản trễ ở phần trước.
Cùng năm bản ghi, hai cách nhìn
Phần batch dùng đúng năm bản ghi của phần streaming, kèm giờ đến giả định cho mỗi bản. Hai cách gán timestamp cho hai bức tranh khác nhau về cùng một tập dữ liệu. Không cách nào sai về kỹ thuật, nhưng chỉ một cách trả lời đúng câu hỏi trang được tải khi nào.
Gom theo giờ tải
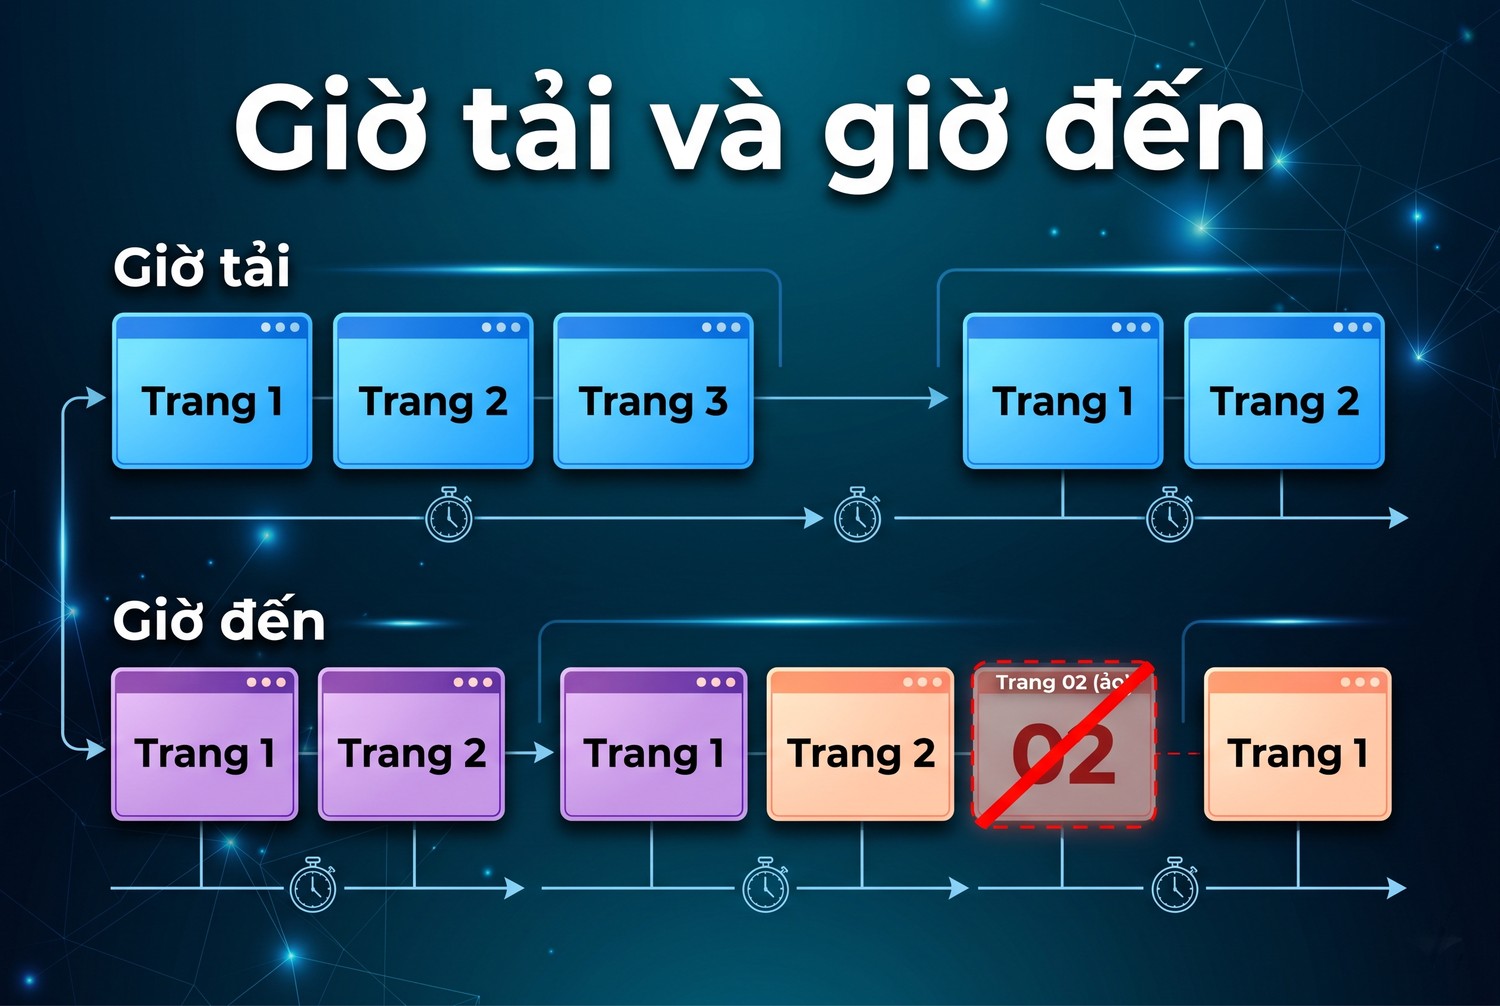
Gán timestamp bằng giờ tải, chạy ở chế độ batch. Cửa sổ giờ 00 có 3 trang, giờ 01 có 2 trang. Đúng với thực tế trang được tải lúc nào.
Gom theo giờ đến
Giờ tải và giờ đến
Gán timestamp bằng giờ đến. Cửa sổ giờ 00 có 2 trang, giờ 01 có 2 trang, giờ 02 có 1 trang. Có một cửa sổ giờ 02 không hề có trang nào được tải trong giờ đó.
Đọc khác biệt
Gom theo giờ đến phản ánh tải của hệ thống xử lý, không phản ánh hoạt động crawl. Báo cáo dùng nó sẽ cho thấy lượng trang tăng vào giờ 02, trong khi thật ra là một máy crawl gửi bù dữ liệu cũ. Với câu hỏi về website, gom theo giờ tải là đúng.
Gom theo giờ đến có chỗ dùng
Gom theo giờ đến không vô ích. Nó cho biết tải của pipeline theo thời gian: giờ nào nhận nhiều bản ghi, có cần thêm tài nguyên không. Câu hỏi về hệ thống xử lý dùng giờ đến, câu hỏi về website dùng giờ tải. Lỗi là dùng giờ đến để trả lời câu hỏi về website.
Batch cũng có event time
Phần so sánh này chạy ở chế độ batch, không có watermark, không có dữ liệu trễ, vì mọi dữ liệu có sẵn từ đầu. Batch luôn cho kết quả theo event time đầy đủ. Đây là lý do chạy lại một ngày dữ liệu bằng batch thường cho số khác với số streaming đã xuất lúc đó.
Hai pipeline song song
Một thiết kế phổ biến là chạy pipeline luồng cho số gần thời gian thực, và pipeline batch mỗi đêm cho số chốt. Báo cáo hiển thị số batch cho các ngày đã qua và số luồng cho hôm nay. Khác biệt giữa hai con số của cùng một giờ cho biết mức độ dữ liệu trễ.
Timestamp do nguồn gắn
Beam chỉ biết event time nếu bước đọc dữ liệu gắn timestamp từ trường thời điểm tải. Nếu bước đọc không gắn, Beam dùng thời điểm đọc, tức gần với processing time. Lab gắn bằng TimestampedValue. Pipeline thật cần gắn ngay ở bước đọc từ nguồn.
Đầu ra nghiệm thu: pipeline cửa sổ event time và xử lý dữ liệu trễ của Apache Beam window cho dữ liệu web
Phần cuối gom kết quả thành bộ bàn giao.
Bộ bàn giao
Bộ bàn giao gồm lab.py với TestStream, ba cấu hình streaming và phần so batch. Người nhận chạy lại với apache-beam 2.77.0, phải thấy allowed_lateness 0 cho 2 và 1, DISCARDING cho pane trễ bằng 1, ACCUMULATING cho pane trễ bằng 3 và 2, gom theo giờ đến có cửa sổ giờ 02.
Tiêu chí đạt
Timestamp là giờ tải trang. Dữ liệu trễ trong ngưỡng được đếm. Chế độ cộng dồn khớp với cách bên nhận ghi kết quả. Dữ liệu trễ quá ngưỡng có đường xử lý riêng.
Ghi pane vào kho
Khi ghi kết quả ACCUMULATING vào bảng, khóa nên là tên miền cộng thời điểm bắt đầu cửa sổ. Mỗi pane mới upsert lên dòng cũ. Thêm cột index của pane và thời điểm ghi giúp biết dòng đã được cập nhật bao nhiêu lần. Với DISCARDING, mỗi pane là một dòng mới, và báo cáo phải cộng.
Quy tắc cho tổng hợp dữ liệu crawl
Gắn timestamp từ thời điểm tải ngay khi đọc. Đặt allowed_lateness bằng độ trễ thực tế đo được của máy crawl, cộng dư. Dùng ACCUMULATING khi ghi kết quả bằng upsert theo khóa và cửa sổ. Chạy lại batch theo ngày để có số cuối cùng.
Khi nào cần proxy với Apache Beam window cho dữ liệu web
Beam xử lý dữ liệu đã tải, không gọi trang web, không cần proxy. Proxy thuộc về bước crawl. Có liên hệ gián tiếp: bản ghi trễ nhiều khi do máy crawl tải chậm qua mạng không ổn định, rồi gửi kết quả muộn.
Với website được phép thu thập, khi cần IP ổn định tại Việt Nam để máy crawl tải đều đặn, anh em có thể mua proxy tĩnh Việt Nam tại trang chủ ProxyVN. Proxy không sửa cấu hình cửa sổ và không cứu được bản ghi trễ đã bị bỏ. Vai trò hợp lệ của proxy được giải thích ở bài Web Scraping proxy là gì.
Máy crawl lệch giờ
Nếu đồng hồ một máy crawl chạy nhanh vài phút, bản ghi của nó mang event time ở tương lai so với các máy khác. Điều này có thể kéo watermark tiến sớm và làm bản ghi của máy khác bị coi là trễ. Đồng bộ thời gian trên mọi máy crawl là điều kiện để event time có nghĩa.
Thời điểm tải lấy từ đâu
Thời điểm tải nên lấy từ đồng hồ máy crawl ngay khi nhận phản hồi, quy về UTC. Không lấy từ header Date của trang, vì có thể là giờ của máy chủ cache. Nếu máy crawl đi qua proxy, đồng hồ vẫn là đồng hồ của máy crawl. Cách cấu hình proxy cho máy crawl đúng định dạng có trong bài định dạng proxy.
Cửa sổ trượt cho xu hướng
Cửa sổ cố định một giờ cho số từng giờ riêng. Muốn xem xu hướng mượt hơn, cửa sổ trượt dài một giờ, bước mười lăm phút cho mỗi bản ghi thuộc bốn cửa sổ chồng lên nhau. Dữ liệu trễ ảnh hưởng tới cả bốn cửa sổ. Lab không thử, nhưng cơ chế allowed_lateness áp dụng giống nhau.
Những gì lab chưa thử
Lab chưa chạy trên Dataflow, Flink hay Spark. Chưa thử cửa sổ trượt hay cửa sổ phiên. Chưa thử trigger sớm theo processing time. Chưa đo bộ nhớ khi giữ trạng thái với allowed_lateness lớn. Dữ liệu chỉ một tên miền, năm bản ghi, đủ để thấy logic, không đủ để đo hiệu năng.
Checklist Apache Beam window cho dữ liệu web
Checklist
- Timestamp là thời điểm tải trang, gắn ngay khi đọc.
- FixedWindows theo khoảng báo cáo cần.
- allowed_lateness theo độ trễ thực tế của máy crawl.
- Trigger AfterWatermark kèm late để xuất pane trễ.
- ACCUMULATING khi bên nhận upsert, DISCARDING khi bên nhận cộng dồn.
- Đọc timing và index của pane.
- Đường xử lý riêng cho dữ liệu trễ quá ngưỡng.
- Chạy lại batch theo ngày để có số chốt.
Câu hỏi thường gặp về Apache Beam window cho dữ liệu web
Event time khác processing time thế nào?
Event time là lúc trang được tải. Processing time là lúc bản ghi tới pipeline. Lab gom theo giờ đến tạo ra cửa sổ giờ 02 không có trang nào thật sự tải trong giờ đó.
Dữ liệu trễ bị bỏ khi nào?
Khi allowed_lateness bằng 0, mặc định. Lab thấy cửa sổ giờ 00 chỉ đếm 2 thay vì 3 trang.
allowed_lateness có giải quyết hết không?
Không. Bản trễ quá ngưỡng vẫn bị bỏ. Ngưỡng dài còn tốn tài nguyên giữ trạng thái.
DISCARDING và ACCUMULATING khác gì?
DISCARDING cho pane trễ chỉ chứa phần mới, lab ra 1. ACCUMULATING cho tổng mới, lab ra 3 và 2.
Vì sao số streaming khác số chạy lại?
Vì chạy lại bằng batch có đủ dữ liệu từ đầu, không có bản trễ bị bỏ.
Beam có cần proxy không?
Không. Proxy thuộc về bước crawl tạo ra dữ liệu.
Apache Beam window cho dữ liệu web và những điều cần nhớ
Apache Beam window cho dữ liệu web chỉ cho số đúng khi gom theo thời điểm tải và có chính sách rõ cho dữ liệu trễ. Lab trên Beam 2.77.0 cho thấy mặc định bỏ lặng lẽ bản trễ, allowed_lateness 2 giờ nhận lại chúng qua pane trễ, và chế độ cộng dồn quyết định pane đó là phần mới hay tổng mới. Gom theo giờ đến thì phản ánh hệ thống xử lý, không phản ánh website. Cần IP tĩnh ổn định cho máy crawl trước khi dùng Apache Beam window cho dữ liệu web, liên hệ Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam.


