
Thuê dịch vụ web scraping hay tự làm: Cách chọn đúng
Thuê dịch vụ web scraping là giao việc thu thập dữ liệu từ website cho một đơn vị hoặc người làm tự do, thay vì tự viết crawler hay tự dùng công cụ không cần lập trình. Doanh nghiệp cần dữ liệu giá đối thủ, danh sách sản phẩm, tin tuyển dụng, đánh giá khách hàng, thông tin bất động sản thường đứng trước ba lựa chọn: tự làm với đội kỹ thuật và proxy, dùng công cụ kéo thả như Octoparse, hoặc thuê ngoài. Mỗi hướng có chi phí, thời gian, mức kiểm soát và rủi ro khác nhau. Bài này ProxyVN giải thích thuê dịch vụ web scraping là gì, so sánh ba hướng bằng bảng cụ thể, liệt kê các câu hỏi cần hỏi khi thuê, và đưa mẫu yêu cầu dữ liệu để tránh giao nhận sai. Xem thêm dịch vụ tại ProxyVN.
Tổng quan về thuê dịch vụ web scraping
Web scraping là gì
Web scraping là việc dùng chương trình tự động truy cập trang web, trích xuất thông tin cần thiết và lưu lại dưới dạng có cấu trúc như bảng tính, cơ sở dữ liệu. Khái niệm và cách hoạt động, kể cả vai trò của proxy, có trong bài web scraping proxy là gì. Góc nhìn từ phía chủ website về việc bị thu thập nội dung có trong bài về content scraping của Cloudflare.
Thuê dịch vụ web scraping là gì
Thuê dịch vụ web scraping nghĩa là mua kết quả là dữ liệu, không mua công cụ. Bên cung cấp lo toàn bộ: viết chương trình, chạy máy chủ, mua proxy, vượt các cơ chế chống bot hợp lệ, làm sạch dữ liệu, giao tệp theo lịch. Bên thuê chỉ cần mô tả rõ cần dữ liệu gì, từ đâu, bao lâu một lần, định dạng nào.
Các hình thức thuê
- Dự án một lần: thu thập một bộ dữ liệu, giao một lần, ví dụ danh sách sản phẩm của mười website.
- Dịch vụ định kỳ: thu thập theo lịch hằng ngày, hằng tuần, ví dụ theo dõi giá đối thủ.
- Dữ liệu qua API: nhà cung cấp cho truy vấn dữ liệu qua API, trả kết quả theo yêu cầu.
- Bộ dữ liệu có sẵn: mua bộ dữ liệu đã thu thập sẵn của một ngành.
Ba hướng thu thập dữ liệu web
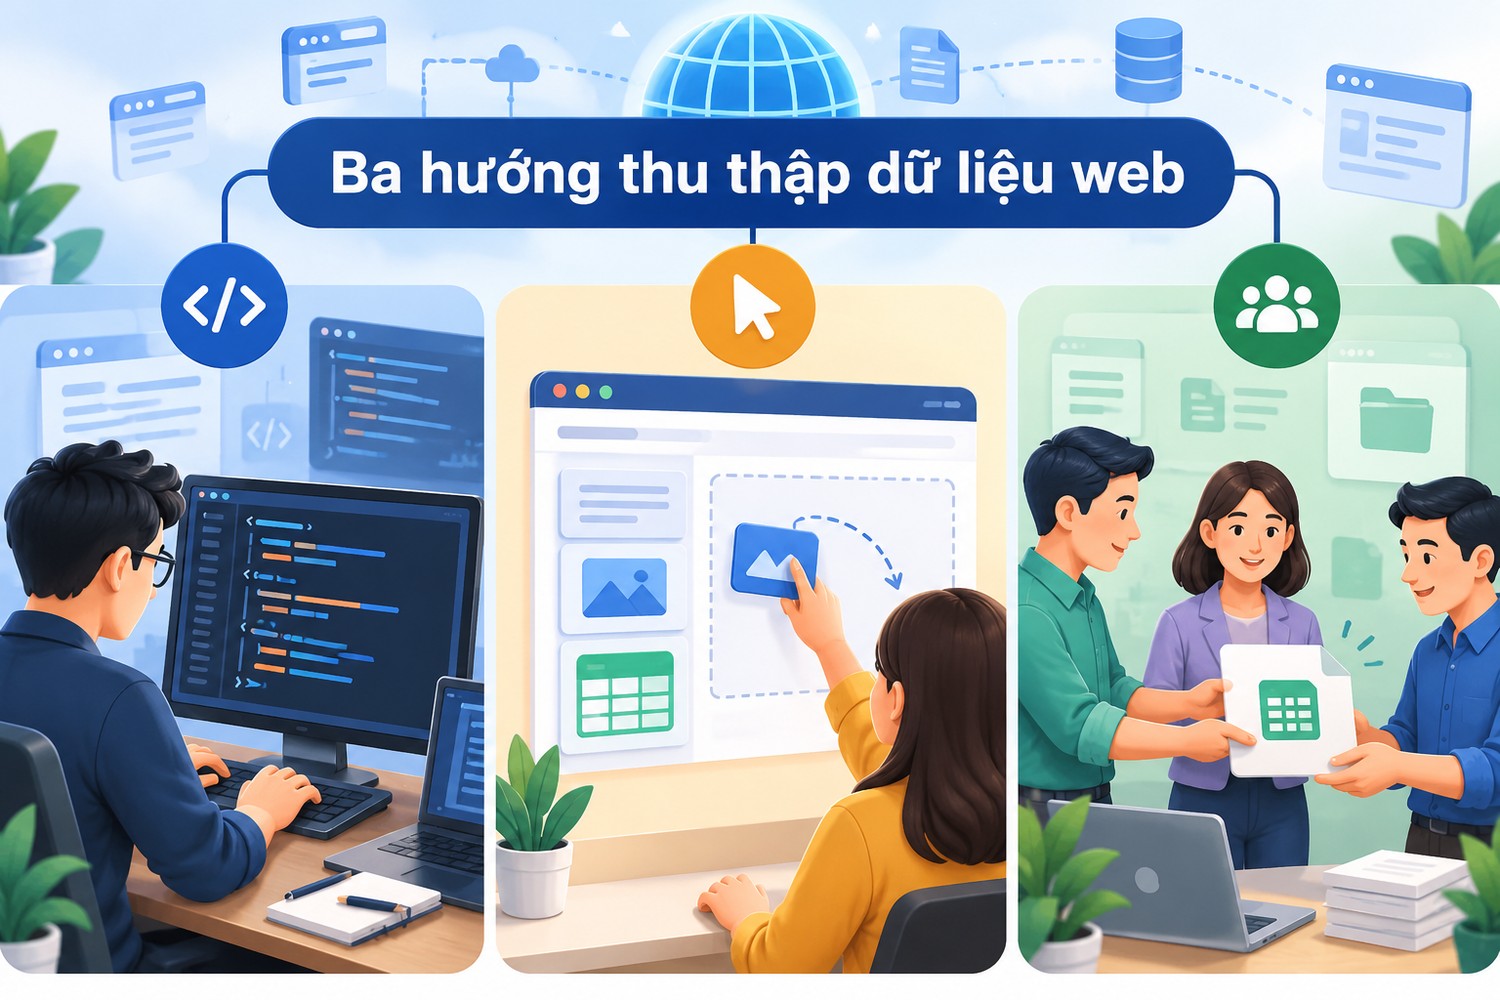
Ba hướng thu thập dữ liệu web
Hướng 1: tự viết crawler kèm proxy
Đội kỹ thuật viết chương trình bằng Python với Scrapy, Playwright, hoặc ngôn ngữ khác, chạy trên máy chủ của mình, dùng proxy để chia tải và tránh bị chặn theo IP. Thông tin về Scrapy có trên trang chủ Scrapy, cách dùng proxy với Scrapy có trong bài proxy Scrapy.
Ưu điểm: toàn quyền kiểm soát, chi phí lâu dài thấp khi khối lượng lớn, dữ liệu không qua tay bên thứ ba. Nhược điểm: cần người có kỹ năng, mất thời gian xây dựng, phải bảo trì khi trang đích đổi giao diện.
Hướng 2: công cụ không cần lập trình
Công cụ kéo thả như Octoparse, ParseHub, các tiện ích trình duyệt cho phép chọn dữ liệu trên trang bằng chuột, tự sinh quy trình thu thập. Có bản chạy trên đám mây, có tích hợp proxy. Hướng dẫn Octoparse có trong bài proxy Octoparse.
Ưu điểm: người không biết lập trình làm được, nhanh với trang đơn giản. Nhược điểm: khó với trang phức tạp, chống bot mạnh, phí thuê bao tăng theo khối lượng, phụ thuộc nền tảng.
Hướng 3: thuê dịch vụ
Giao toàn bộ cho đơn vị chuyên làm hoặc người làm tự do có kinh nghiệm.
Ưu điểm: không cần đội kỹ thuật, có dữ liệu nhanh, bên cung cấp chịu trách nhiệm bảo trì. Nhược điểm: chi phí cao hơn khi tính lâu dài, phụ thuộc bên ngoài, cần kiểm soát chất lượng và trách nhiệm pháp lý rõ ràng.
So sánh chi tiết ba hướng
Tiêu chí |
Tự viết crawler |
Công cụ không code |
Thuê dịch vụ |
|---|---|---|---|
Kỹ năng cần có |
Lập trình, mạng, proxy |
Cơ bản, làm quen công cụ |
Mô tả yêu cầu, nghiệm thu |
Thời gian có dữ liệu đầu tiên |
Vài ngày tới vài tuần |
Vài giờ tới vài ngày |
Vài ngày |
Chi phí ban đầu |
Cao, công lập trình |
Thấp |
Trung bình |
Chi phí khi chạy lâu dài |
Thấp tới trung bình |
Trung bình, tăng theo khối lượng |
Cao, trả theo tháng hoặc theo lượt |
Xử lý trang phức tạp, chống bot |
Tốt nếu đội giỏi |
Hạn chế |
Tốt nếu chọn đúng đơn vị |
Kiểm soát dữ liệu, logic |
Cao nhất |
Trung bình |
Thấp tới trung bình |
Bảo trì khi trang đổi giao diện |
Tự làm |
Tự sửa quy trình |
Bên cung cấp lo |
Rủi ro phụ thuộc |
Phụ thuộc người viết |
Phụ thuộc nền tảng |
Phụ thuộc nhà cung cấp |
Cách đọc bảng
Không có hướng nào tốt nhất cho mọi trường hợp. Dự án nhỏ, một lần, trang đơn giản: công cụ không code hoặc thuê người làm tự do. Nhu cầu dài hạn, khối lượng lớn, dữ liệu là lõi kinh doanh: tự xây đội và hạ tầng. Cần dữ liệu nhanh, không có đội kỹ thuật, khối lượng vừa: thuê dịch vụ.
Chi phí thật của từng hướng
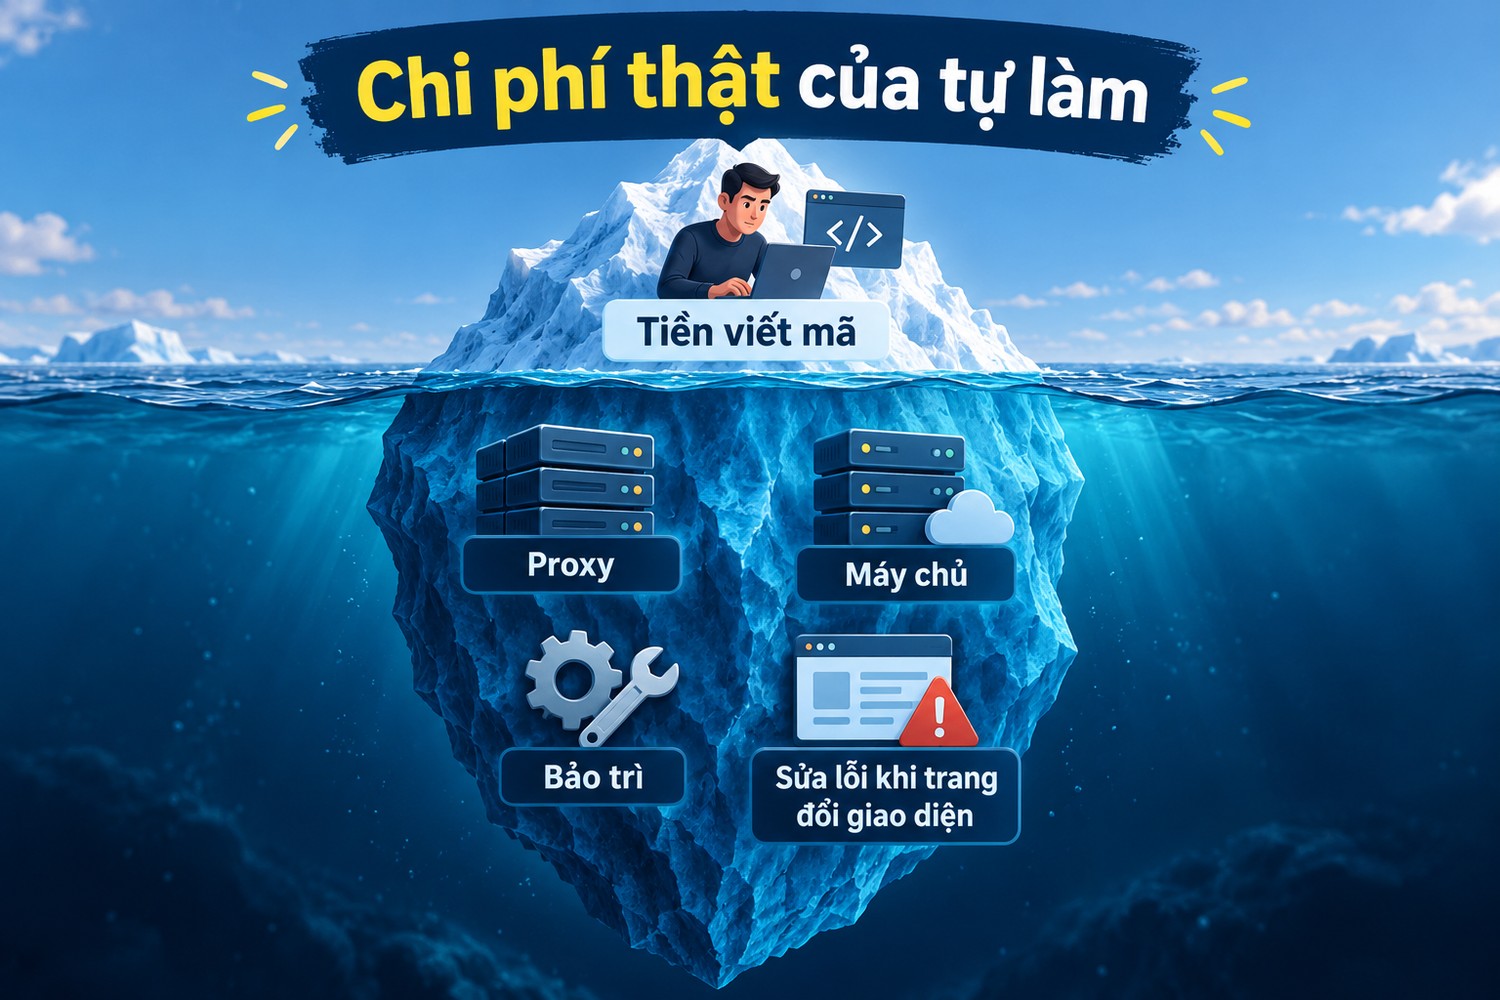
Chi phí thật của tự làm
Tự làm không chỉ là tiền viết mã
Chi phí tự làm gồm:
- Công lập trình ban đầu.
- Máy chủ chạy chương trình, lưu dữ liệu.
- Proxy: dân cư, datacenter, hoặc proxy xoay tuỳ trang đích.
- Dịch vụ giải CAPTCHA nếu cần và được phép.
- Công bảo trì: trang đích đổi giao diện vài tháng một lần, mỗi lần chương trình hỏng phải sửa.
- Công giám sát chất lượng dữ liệu.
Phần bảo trì thường bị đánh giá thấp nhất. Một crawler cho mười website có thể cần vài giờ sửa mỗi tháng.
Chi phí công cụ không code
Phí thuê bao theo tháng tăng theo số tác vụ, số trang, tính năng đám mây. Cộng thêm proxy nếu công cụ không bao gồm. Rẻ khi khối lượng nhỏ, đắt dần khi khối lượng lớn.
Chi phí thuê dịch vụ
Giá thường tính theo một trong các cách: trọn gói dự án, theo số bản ghi, theo số trang, theo tháng cho dịch vụ định kỳ. Dự án nhỏ một lần có thể chỉ vài triệu đồng, dịch vụ định kỳ cho nhiều website lớn có chống bot mạnh có thể hàng chục triệu mỗi tháng. Báo giá dao động lớn giữa các bên, nên lấy ít nhất ba báo giá với cùng một bản yêu cầu.
Tính tổng chi phí sở hữu
So sánh trên cùng khoảng thời gian, ví dụ mười hai tháng. Tự làm có chi phí ban đầu cao nhưng chi phí hằng tháng thấp. Thuê dịch vụ chi phí ban đầu thấp nhưng hằng tháng cao. Điểm hoà vốn phụ thuộc khối lượng và độ khó. Bài nên tự build hay thuê proxy phân tích bài toán tương tự cho riêng phần proxy.
Các loại dữ liệu doanh nghiệp Việt Nam hay thuê thu thập
Biết người khác thường thuê thu thập gì giúp hình dung dự án của mình và cách mô tả yêu cầu.
Giá và sản phẩm trên sàn thương mại điện tử
Giá, khuyến mãi, số lượt bán, đánh giá của sản phẩm cùng loại trên các sàn lớn. Dùng để định giá, chọn sản phẩm, theo dõi đối thủ. Khó vì các sàn có chống bot mạnh và giao diện thay đổi thường xuyên.
Tin bất động sản
Giá rao bán, cho thuê theo khu vực, diện tích, loại hình. Dùng để định giá, nghiên cứu thị trường. Cần làm sạch nhiều vì tin trùng lặp, giá ghi không thống nhất.
Tin tuyển dụng
Vị trí, mức lương, kỹ năng yêu cầu theo ngành, theo thành phố. Dùng cho nghiên cứu nhân sự, xây dựng thang lương, tìm khách hàng đang tuyển người.
Đánh giá và bình luận
Đánh giá sản phẩm, đánh giá địa điểm trên bản đồ, bình luận công khai. Dùng để phân tích cảm nhận khách hàng. Lưu ý không thu thập thông tin nhận diện cá nhân ngoài phạm vi cần thiết.
Kết quả tìm kiếm
Vị trí từ khoá, quảng cáo hiển thị, đoạn trích nổi bật theo vùng. Thường dùng API kết quả tìm kiếm thay vì tự cào. Với việc theo dõi thứ hạng, bài mua proxy cho SERP tracking giải thích các lựa chọn.
Khi nào nên thuê dịch vụ web scraping
- Không có lập trình viên, hoặc lập trình viên đang bận việc cốt lõi.
- Cần dữ liệu gấp trong vài ngày cho một quyết định kinh doanh.
- Trang đích có chống bot mạnh, cần kinh nghiệm chuyên sâu.
- Nhu cầu là dự án một lần, không đáng xây hạ tầng.
- Muốn thử nghiệm giá trị của dữ liệu trước khi đầu tư tự làm.
Khi nào nên tự làm
- Dữ liệu là lõi sản phẩm, cần kiểm soát logic, chất lượng, thời gian.
- Khối lượng lớn, chạy lâu dài, chi phí thuê ngoài vượt chi phí tự làm.
- Dữ liệu nhạy cảm về kinh doanh, không muốn bên ngoài biết mình theo dõi gì.
- Có đội kỹ thuật và sẵn sàng đầu tư bảo trì.
Khi tự làm, các công cụ hỗ trợ như API kết quả tìm kiếm, dịch vụ vượt chặn có thể thay một phần việc khó. Hai khái niệm này có trong bài SERP API và Web Unblocker.
Câu hỏi cần hỏi khi thuê dịch vụ web scraping
Về kỹ thuật
- Đã từng thu thập từ website này hoặc website tương tự chưa? Có mẫu dữ liệu không?
- Xử lý trang tải bằng JavaScript, cuộn vô hạn, đăng nhập thế nào?
- Dùng proxy loại gì, ở đâu? Tần suất truy cập bao nhiêu?
- Khi trang đổi giao diện, bao lâu thì sửa xong? Có cam kết không?
Về chất lượng dữ liệu
- Tỷ lệ bản ghi thiếu trường, sai định dạng chấp nhận được là bao nhiêu?
- Có kiểm tra trùng lặp, chuẩn hoá giá, ngày tháng, đơn vị không?
- Giao mẫu thử trước khi ký hợp đồng được không?
Về pháp lý và bảo mật
- Có kiểm tra điều khoản dịch vụ, tệp robots.txt của trang đích không?
- Có thu thập dữ liệu cá nhân không? Nếu có, xử lý thế nào?
- Dữ liệu của mình có được dùng cho khách khác không? Bao lâu thì xoá?
- Ai chịu trách nhiệm nếu có khiếu nại từ chủ website?
Về giao nhận
- Định dạng giao: CSV, Excel, JSON, cơ sở dữ liệu, API?
- Kênh giao: email, kho lưu trữ đám mây, máy chủ của mình?
- Lịch giao, thông báo khi chậm, khi lỗi?
Mẫu yêu cầu dữ liệu (spec) khi thuê
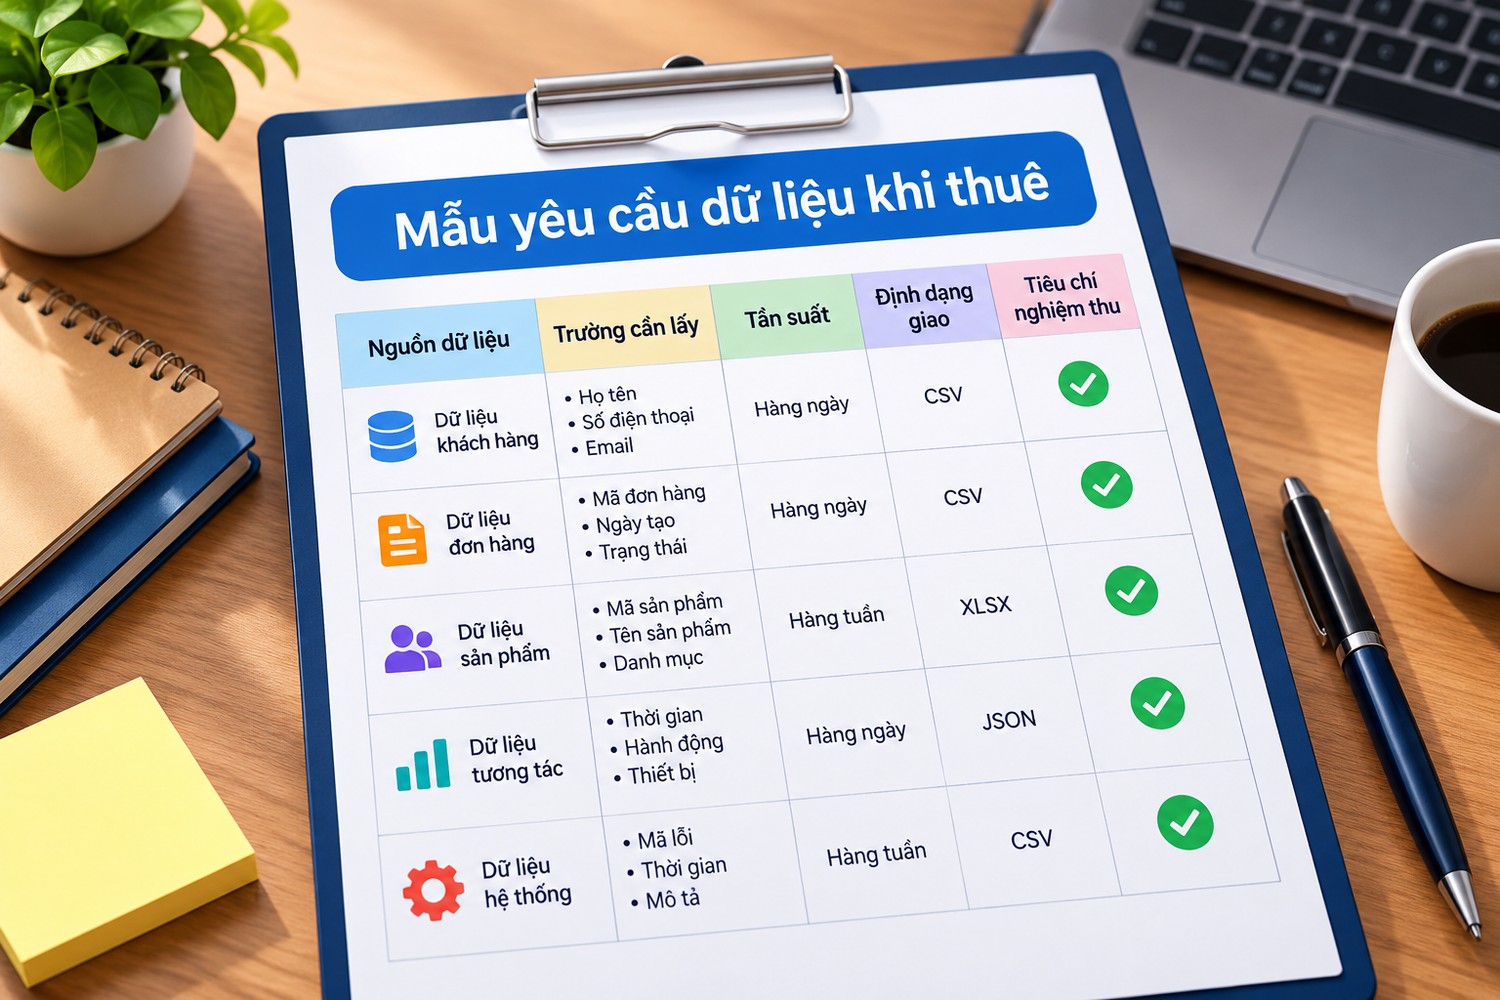
Mẫu yêu cầu dữ liệu khi thuê
Một bản yêu cầu rõ ràng giúp báo giá chính xác, giao nhận đúng, ít tranh cãi. Dưới đây là khung gợi ý.
Mục đích
Một hai câu nói dữ liệu dùng để làm gì. Ví dụ: theo dõi giá bán lẻ của 500 sản phẩm điện gia dụng trên năm website để điều chỉnh giá hằng tuần. Mục đích giúp bên cung cấp đề xuất cách làm phù hợp.
Nguồn dữ liệu
Danh sách website, trang danh mục, hoặc danh sách địa chỉ sản phẩm cụ thể. Ghi rõ có cần đăng nhập không, có lấy theo khu vực không.
Các trường cần lấy
Trường |
Mô tả |
Bắt buộc |
Định dạng |
|---|---|---|---|
Tên sản phẩm |
Tên hiển thị trên trang |
Có |
Văn bản |
Giá bán |
Giá sau khuyến mãi |
Có |
Số nguyên, đồng |
Giá gốc |
Giá trước khuyến mãi nếu có |
Không |
Số nguyên, đồng |
Tình trạng |
Còn hàng hoặc hết hàng |
Có |
Một trong hai giá trị |
Địa chỉ trang |
URL của sản phẩm |
Có |
URL đầy đủ |
Thời điểm lấy |
Ngày giờ thu thập |
Có |
Ngày giờ chuẩn |
Tần suất và khối lượng
Bao lâu một lần, khoảng bao nhiêu trang, bao nhiêu bản ghi mỗi lần. Có cần lấy vào giờ cụ thể không.
Định dạng và kênh giao
Tệp CSV mã hoá UTF-8, tên tệp theo ngày, đặt vào thư mục đám mây chia sẻ. Hoặc ghi vào bảng của cơ sở dữ liệu.
Tiêu chí nghiệm thu
- Tối thiểu bao nhiêu phần trăm sản phẩm trong danh sách có dữ liệu.
- Tỷ lệ lỗi định dạng tối đa.
- Thời hạn giao sau mỗi lần chạy.
- Cách xử lý khi một website không lấy được: báo trong bao lâu, bù thế nào.
Pháp lý
Cam kết chỉ thu thập dữ liệu công khai, không thu thập dữ liệu cá nhân ngoài phạm vi đã thống nhất, không vượt cơ chế đăng nhập trái phép, xoá dữ liệu khi kết thúc hợp đồng.
Quy trình làm việc khi thuê dịch vụ web scraping
Chọn được bên cung cấp mới là bước đầu. Quy trình làm việc rõ ràng quyết định dự án có suôn sẻ hay không.
Bước 1: gửi bản yêu cầu và nhận báo giá
Gửi cùng một bản yêu cầu cho ít nhất ba bên. So sánh không chỉ giá mà cả cách họ hiểu yêu cầu: bên nào hỏi lại các điểm chưa rõ thường là bên có kinh nghiệm.
Bước 2: chạy thử có trả phí
Đề nghị chạy thử với một phần nhỏ, ví dụ một website hoặc một trăm sản phẩm, có trả phí. Chạy thử cho thấy chất lượng thật, tốc độ phản hồi, cách xử lý vấn đề. Đừng ký hợp đồng dài hạn trước khi có mẫu dữ liệu thật.
Bước 3: ký hợp đồng với cam kết dịch vụ
Hợp đồng nêu rõ phạm vi, tần suất, tiêu chí nghiệm thu, thời gian sửa khi trang đích đổi giao diện, quyền sở hữu dữ liệu, bảo mật, trách nhiệm pháp lý, điều kiện chấm dứt. Với dịch vụ định kỳ, có điều khoản giảm phí khi không đạt cam kết.
Bước 4: theo dõi và nghiệm thu từng kỳ
Mỗi lần nhận dữ liệu, chạy kiểm tra tự động theo tiêu chí đã thống nhất. Ghi lại lỗi, gửi phản hồi sớm. Họp định kỳ hằng tháng để rà soát.
Bước 5: kế hoạch dự phòng
Lưu bản yêu cầu, mẫu dữ liệu, danh sách nguồn ở phía mình. Nếu phải đổi nhà cung cấp hoặc tự làm, có sẵn mọi thứ để chuyển giao nhanh.
Kiểm tra chất lượng dữ liệu nhận về
Dữ liệu sai còn tệ hơn không có dữ liệu, vì dẫn tới quyết định sai. Vài kiểm tra đơn giản phát hiện phần lớn vấn đề.
Đếm và so sánh
So số bản ghi với kỳ trước. Giảm đột ngột thường do một website lấy không được. Tăng đột ngột có thể do trùng lặp.
Kiểm tra trường trống và giá trị lạ
Đếm tỷ lệ trường bắt buộc bị trống. Kiểm tra giá bằng không, giá âm, giá lớn bất thường, ngày tháng sai định dạng.
Đối chiếu ngẫu nhiên
Mỗi kỳ chọn ngẫu nhiên vài chục bản ghi, mở trang gốc, so dữ liệu. Đây là cách duy nhất phát hiện lỗi lấy nhầm trường, ví dụ lấy giá gốc thay cho giá khuyến mãi.
Kiểm tra theo vùng
Nếu dữ liệu phụ thuộc vị trí như giá theo tỉnh, đối chiếu bằng trình duyệt sạch kết hợp IP đúng vùng. Dữ liệu sai vùng thường do proxy của bên cung cấp có vị trí không đúng.
Dấu hiệu bên cung cấp dịch vụ không đáng tin
- Cam kết lấy được mọi website, mọi loại dữ liệu, kể cả dữ liệu sau đăng nhập của người khác.
- Sẵn sàng bán dữ liệu cá nhân như số điện thoại, email hàng loạt.
- Không có mẫu dữ liệu, không chịu chạy thử.
- Không ký hợp đồng, không xuất hoá đơn với dự án định kỳ giá trị lớn.
- Không trả lời được câu hỏi cơ bản về cách xử lý khi trang đích chặn.
- Giá thấp bất thường so với các báo giá khác cho cùng yêu cầu.
Gặp các dấu hiệu này, nên dừng lại. Rủi ro pháp lý và rủi ro dữ liệu sai lớn hơn nhiều so với khoản tiết kiệm.
Rủi ro pháp lý khi thu thập dữ liệu web
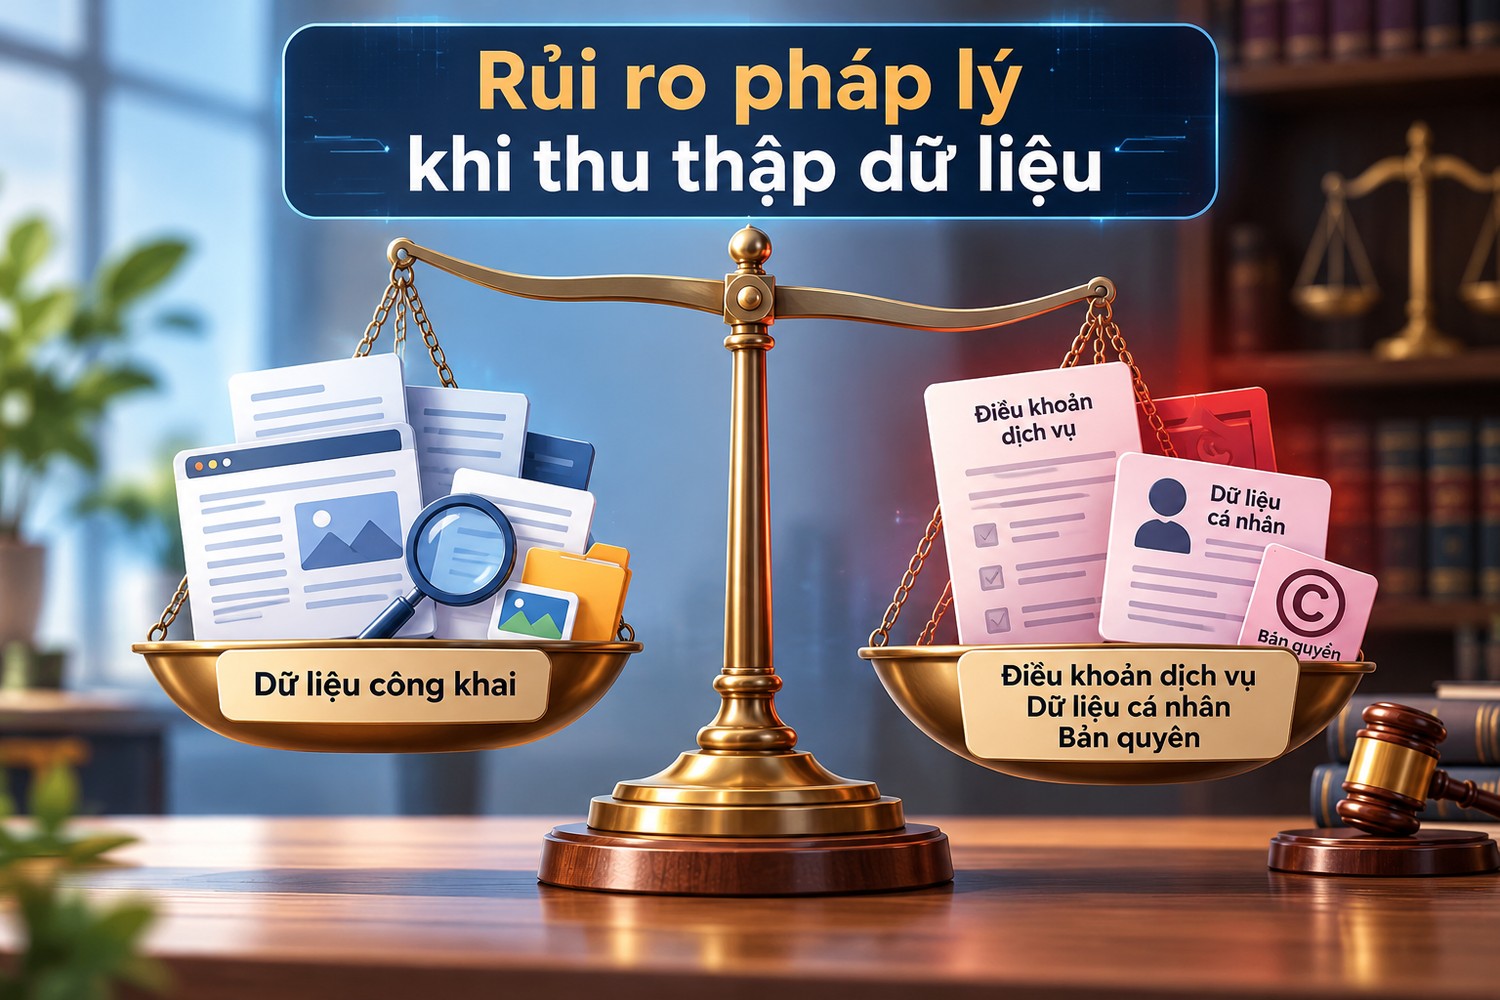
Rủi ro pháp lý khi thu thập dữ liệu
Dù tự làm hay thuê, người dùng dữ liệu vẫn chịu một phần trách nhiệm. Hiểu các rủi ro chính giúp đặt yêu cầu đúng.
Điều khoản dịch vụ của website
Nhiều website cấm thu thập tự động trong điều khoản. Vi phạm điều khoản có thể dẫn tới bị chặn, bị khởi kiện dân sự ở một số trường hợp. Đọc điều khoản của trang đích trước khi quyết định.
Tệp robots.txt
robots.txt là tệp website dùng để nói với trình thu thập phần nào được và không được truy cập. Chuẩn được mô tả trong RFC 9309, giới thiệu dễ hiểu có trong tài liệu robots.txt của Google Search Central. robots.txt không phải luật, nhưng tôn trọng nó là thực hành tốt và là bằng chứng thiện chí.
Dữ liệu cá nhân
Thu thập họ tên, số điện thoại, email, ảnh của cá nhân chịu sự điều chỉnh của quy định bảo vệ dữ liệu cá nhân. Việt Nam có quy định riêng về bảo vệ dữ liệu cá nhân. Không thu thập, mua bán dữ liệu cá nhân khi không có cơ sở pháp lý.
Bản quyền nội dung
Bài viết, ảnh, mô tả sản phẩm có thể được bảo hộ bản quyền. Thu thập để phân tích nội bộ khác với đăng lại công khai. Không sao chép nội dung của người khác lên website của mình.
Gây quá tải cho website
Gửi quá nhiều yêu cầu làm chậm hoặc sập website của người khác có thể bị coi là tấn công. Đặt tốc độ hợp lý, chạy vào giờ thấp điểm, giới hạn số kết nối đồng thời.
Vai trò của proxy trong dự án web scraping
Vì sao cần proxy
Website giới hạn số yêu cầu từ một IP. Thu thập khối lượng lớn từ một IP sẽ bị chặn. Proxy chia yêu cầu qua nhiều IP, giữ tốc độ mỗi IP ở mức hợp lý.
Loại proxy theo trang đích
- Trang ít chống bot: proxy datacenter, giá rẻ, tốc độ cao.
- Trang chống bot mạnh, thương mại điện tử lớn: proxy dân cư, proxy xoay.
- Cần dữ liệu theo vùng: proxy đúng quốc gia, đúng tỉnh.
Khi thuê dịch vụ
Bên cung cấp thường tự lo proxy, chi phí proxy nằm trong báo giá. Hỏi rõ để biết họ dùng proxy hợp pháp, không dùng mạng máy tính bị chiếm quyền. Khi tự làm, anh em cần proxy Việt Nam dân cư, datacenter hoặc proxy xoay cho dự án thu thập dữ liệu có thể mua proxy tại ProxyVN.
Kết hợp các hướng
Nhiều doanh nghiệp không chọn một hướng duy nhất.
Thuê trước, tự làm sau
Thuê dịch vụ để có dữ liệu ngay và kiểm chứng giá trị. Khi chắc dữ liệu đem lại lợi ích, xây đội nội bộ tiếp quản, dùng spec đã hoàn thiện làm yêu cầu.
Tự làm phần dễ, thuê phần khó
Đội nội bộ thu thập các trang đơn giản. Các trang chống bot mạnh, cần hạ tầng phức tạp thì thuê ngoài hoặc dùng API của bên thứ ba.
Công cụ không code cho thử nghiệm
Nhân viên kinh doanh, marketing dùng công cụ không code để thử ý tưởng nhanh. Ý tưởng nào chứng minh được giá trị thì chuyển cho đội kỹ thuật hoặc đơn vị thuê ngoài làm bài bản.
Câu hỏi thường gặp về thuê dịch vụ web scraping
Thuê dịch vụ web scraping là gì
Là giao việc thu thập dữ liệu từ website cho đơn vị hoặc người làm tự do, nhận về dữ liệu đã làm sạch theo định dạng thống nhất, thay vì tự viết chương trình hay tự dùng công cụ.
Giá dịch vụ web scraping bao nhiêu
Tuỳ số website, độ khó chống bot, khối lượng, tần suất. Dự án nhỏ một lần có giá thấp, dịch vụ định kỳ cho nhiều website lớn có giá cao. Lấy nhiều báo giá với cùng một bản yêu cầu để so sánh.
Thuê người làm tự do hay thuê công ty
Người làm tự do phù hợp dự án nhỏ, một lần, giá tốt. Công ty phù hợp dịch vụ định kỳ, cần cam kết bảo trì, hợp đồng rõ ràng, xuất hoá đơn.
Web scraping có hợp pháp không
Thu thập dữ liệu công khai cho mục đích hợp lý, tôn trọng điều khoản, không thu thập dữ liệu cá nhân trái phép, không gây quá tải thường được chấp nhận. Mỗi trường hợp cụ thể nên hỏi ý kiến pháp lý.
Có cần proxy khi thuê dịch vụ không
Thường không, bên cung cấp tự lo. Chỉ cần proxy khi tự làm hoặc khi dùng công cụ không code không có proxy đi kèm.
Tổng kết
Thuê dịch vụ web scraping phù hợp khi cần dữ liệu nhanh, không có đội kỹ thuật, trang đích khó, hoặc dự án một lần. Tự viết crawler kèm proxy hợp khi dữ liệu là lõi kinh doanh, khối lượng lớn, chạy lâu dài. Công cụ không code hợp cho trang đơn giản và thử nghiệm nhanh. Dù chọn hướng nào, viết bản yêu cầu dữ liệu rõ ràng, hỏi kỹ về chất lượng, bảo trì, pháp lý, tôn trọng điều khoản và dữ liệu cá nhân. Cần proxy cho dự án thu thập dữ liệu tự làm, anh em liên hệ Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam để được tư vấn.


