
thu thập RSS và Atom bằng Python có sổ cập nhật
thu thập RSS và Atom bằng Python giúp dùng feed được nguồn công bố thay vì tải lại toàn bộ trang bài. Công việc vẫn cần giữ định danh, múi giờ và lịch sử sửa nội dung. Bài này dùng hai fixture, tách ID theo nguồn và kiểm bản cũ được cập nhật mà không tạo thêm một bài giả. ProxyVN hướng dẫn cách kiểm trên dữ liệu mẫu.
thu thập RSS và Atom bằng Python theo nguồn công bố
Feed là một cách nguồn công bố danh sách mục để phần mềm đọc. Nó có thể chứa tóm tắt, nội dung hoặc liên kết tùy thiết kế nguồn. Không mặc định feed luôn giữ toàn bộ lịch sử hay luôn có đầy đủ thân bài như trang HTML.
Nếu nhu cầu chỉ là theo dõi bài mới trong phạm vi nguồn hỗ trợ, feed có thể giảm việc xử lý giao diện trang. Nhưng quyền sử dụng nội dung, phạm vi truy cập và điều kiện nguồn vẫn cần được giữ. Việc có feed công khai không tự cấp quyền tái bản toàn bộ bài.
Bộ lab tạo một RSS có guid lab-1 và một Atom có id urn:lab:1. Đây là hai nguồn giả lập riêng để kiểm nhận dạng. Bài không thu email tác giả, không gửi tải định kỳ đến website thật và không công bố quota của một dịch vụ cụ thể.
Tách tải feed với đọc cấu trúc
HTTP client chịu trách nhiệm nhận byte, status và header. Parser XML đọc cấu trúc đã tải. Sổ trạng thái quyết định một item là mới, đã biết hay được cập nhật. Ba bước nên có đầu vào và output riêng để dễ kiểm.
Một response 200 có thể là HTML lỗi thay vì feed XML. Kiểm loại dữ liệu và root phù hợp trước khi đưa vào nhánh RSS hoặc Atom. Không coi parser XML thất bại là bằng chứng proxy không hỗ trợ feed.
Nếu dùng thư viện feed chuyên dụng, khóa phiên bản và kiểm cách nó biểu diễn ID cùng ngày giờ. Nếu dùng ElementTree cho fixture nhỏ như bài, ghi rõ chưa xây parser mọi extension của feed. Một nhánh đọc hai mẫu không thay thế thư viện tổng quát.
thu thập RSS và Atom bằng Python với hai fixture riêng
RSS và Atom có cấu trúc khác nhau dù cùng mô tả các mục cập nhật. Bộ thử phải giữ hai nhánh nhận dạng thay vì tìm mọi thẻ tên item hoặc entry bằng cách bỏ ngữ cảnh. Namespace đặc biệt quan trọng với Atom.
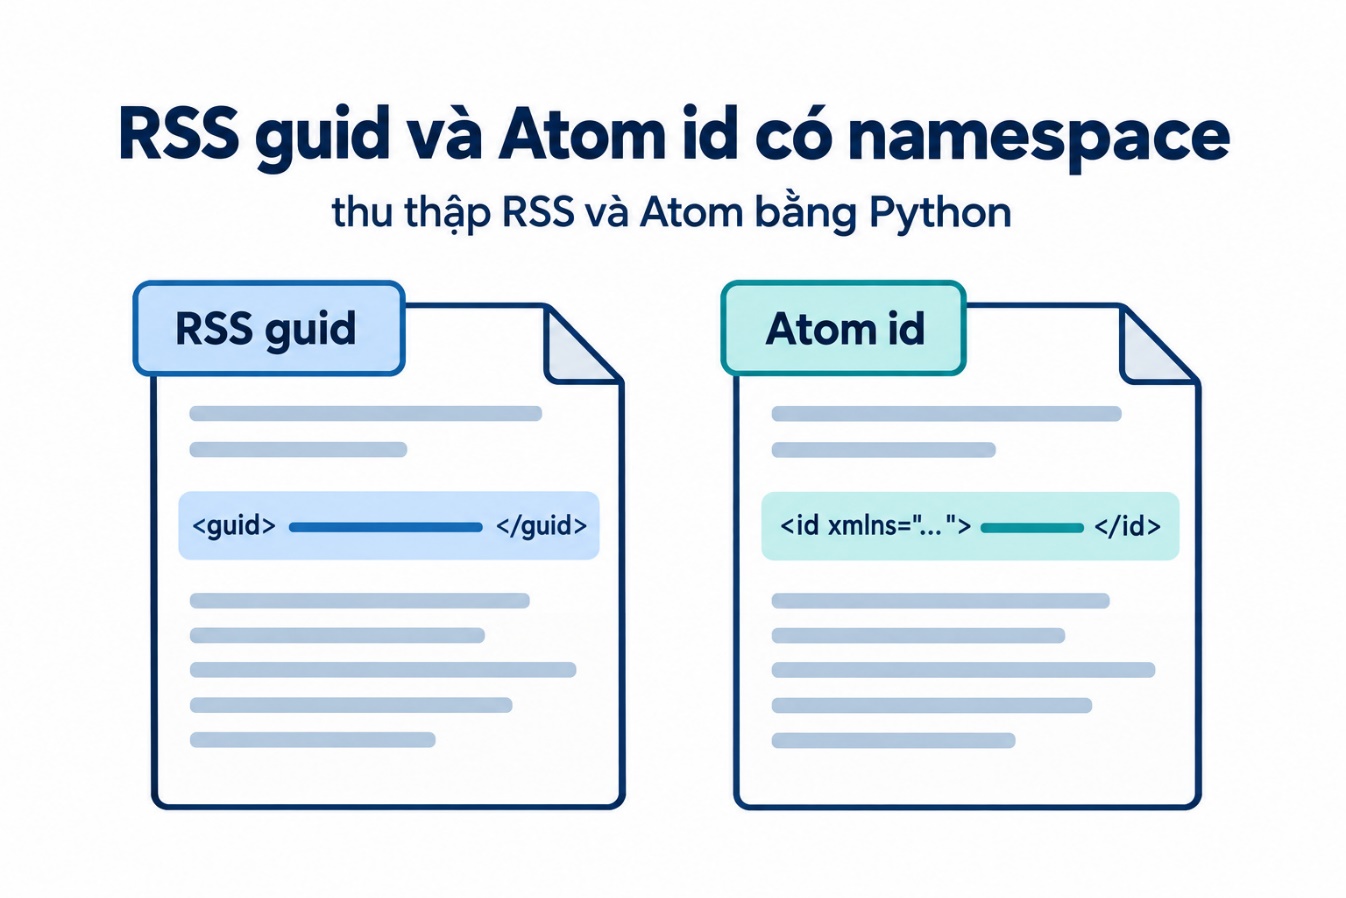
RSS guid và Atom id có namespace
Đọc ID trong RSS
RSS fixture có channel chứa item và guid với isPermaLink false. Giá trị này dùng làm định danh theo nguồn, không phải URL bắt buộc phải tải. Nếu script biến mọi guid thành request, nó có thể tạo truy cập không có ý nghĩa hoặc ngoài phạm vi công việc.
Đặc tả RSS 2.0 là nguồn đối chiếu các phần tử. Với một nguồn thật, cần kiểm nó có guid ổn định hay dùng trường khác. Không tạo một quy tắc chung rằng mọi RSS item luôn có cùng bộ trường.
Khi guid thiếu, định nghĩa fallback theo nguồn và ghi mức tin cậy. Dùng link hoặc hash nội dung có thể hữu ích trong một số tác vụ nhưng có giới hạn riêng. Đổi title không nên tự động tạo bài mới chỉ vì title được chọn làm khóa tạm.
Đọc ID trong Atom có namespace
Atom fixture dùng namespace chuẩn trên feed và entry. Với ElementTree, đường tìm cần namespace tương ứng; tìm entry trần có thể trả rỗng dù tài liệu đúng. Ca này giúp phân biệt lỗi truy vấn cây với nguồn không có item.
import xml.etree.ElementTree as ET
rss = ET.fromstring("""<rss version="2.0"><channel><item>
<guid isPermaLink="false">lab-1</guid><title>One</title>
</item></channel></rss>""")
atom = ET.fromstring("""<feed xmlns="http://www.w3.org/2005/Atom">
<entry><id>urn:lab:1</id><title>One revised</title>
<updated>2026-10-27T00:00:00Z</updated></entry></feed>""")
ns = {'a': 'http://www.w3.org/2005/Atom'}
assert rss.findtext('channel/item/guid') == 'lab-1'
assert atom.findtext('a:entry/a:id', namespaces=ns) == 'urn:lab:1'
Ví dụ chỉ đọc các trường trong hai fixture đã biết. RFC 4287 cung cấp chuẩn Atom rộng hơn, gồm các ranh giới nội dung và metadata. Khi nguồn dùng extension, cần thêm xử lý có tài liệu và bộ mẫu tương ứng.
ID của Atom trong ví dụ là URN, không phải địa chỉ trang. Giữ nó như định danh và lấy link theo đúng trường nếu tác vụ cần URL. Phân biệt ID với vị trí tải giúp sổ trạng thái không phụ thuộc việc một URL bài được chuyển hướng.
thu thập RSS và Atom bằng Python với khóa theo nguồn
Sổ chống trùng nên có phạm vi nguồn để hai feed không vô tình chiếm cùng khóa. Một guid ngắn như 123 có thể xuất hiện ở nhiều website. Dùng cặp source_id và entry_id giúp giữ ranh giới ngay cả khi giá trị ID giống nhau.
Source ID cần ổn định hơn tên hiển thị
Tên feed có thể được đổi để phục vụ giao diện. Nếu dùng title làm source_id, lần đổi tên có thể tạo một nguồn mới giả. Chọn mã nguồn nội bộ ổn định, giữ URL feed hiện tại và lịch sử chuyển đổi theo chính sách dự án.
URL feed cũng có thể chuyển hướng hoặc đổi đường dẫn. Việc nối nguồn cũ với nguồn mới cần bằng chứng và quyết định quản trị, không tự động chỉ vì hai tên gần giống. Giữ trạng thái chuyển đổi để không tải lại lịch sử ngoài ý muốn.
Với nhiều chuyên mục của cùng website, xác định chúng là các nguồn độc lập hay các kênh cùng chia sẻ định danh bài. Quy tắc này ảnh hưởng chống trùng. Một nguồn nội bộ ổn định và một khóa bài gốc có thể là hai trường khác nhau cần giữ.
Hash nội dung giúp nhận biết cập nhật
Sau khi tìm được khóa, so những trường được dự án xem là nội dung cần theo dõi. Nếu hash các trường đó đổi, ghi một phiên bản mới của item hoặc cập nhật có lịch sử. Không tạo ID mới chỉ vì mô tả được sửa.
Hash nên tính trên một cấu trúc chuẩn hóa có version, không trên repr dict tùy tiện. Chọn thứ tự trường và cách serialize rõ ràng. Nếu thêm một trường vào thuật toán hash, phải biết đó là thay đổi phương pháp chứ không kết luận mọi bài đồng loạt được nguồn sửa.
Một item không đổi vẫn có thể xuất hiện trong nhiều lần poll. Ghi last_seen nếu cần quan sát nhưng không tăng số bài mới. Tách first_seen, last_seen và thời điểm nội dung thay đổi giúp dashboard không nhầm lưu lượng feed với sản lượng bài.
thu thập RSS và Atom bằng Python với ngày giờ
Ngày xuất bản, ngày cập nhật và thời điểm crawler nhìn thấy là các mốc khác nhau. Feed có thể công bố một số mốc nhưng không có mốc còn lại. Đừng dùng thời gian chạy script để lấp tất cả cột ngày cho tiện xuất bảng.
Ngày xuất bản cập nhật và quan sát
Mốc |
Ý nghĩa trong pipeline |
Cách giữ |
|---|---|---|
published |
Nguồn công bố thời điểm xuất bản |
Raw và giá trị parse được |
updated |
Nguồn công bố lần sửa |
Không thay bằng poll time |
first_seen |
Lần đầu hệ thống quan sát |
Timestamp của công việc |
last_seen |
Lần gần nhất item còn xuất hiện |
Cập nhật theo lượt poll |
Giữ timezone thay vì tạo giờ ngây thơ
Một timestamp có múi giờ nên được parse thành giá trị aware phù hợp. Khi chuẩn hóa về UTC, giữ chuỗi gốc nếu cần đối chiếu. Không bỏ offset rồi coi giờ còn lại là giờ địa phương của máy crawler.
RSS và Atom có cách biểu diễn thời gian theo đặc tả tương ứng. Với Python, chọn hàm parse theo định dạng được hỗ trợ và kiểm ca lỗi. email.utils là nguồn đối chiếu cho một số định dạng ngày kiểu email thường gặp ở RSS.
Nếu ngày thiếu timezone hoặc không parse được, ghi trạng thái thay vì đoán theo vị trí proxy. IP ra mạng không xác định timezone mà nguồn định dùng trong một chuỗi thiếu thông tin. Quy tắc suy luận theo nguồn, nếu cần, phải được ghi riêng và có nhãn.
Thứ tự thời gian không thay cho định danh
Hai item có thể cùng timestamp hoặc được cập nhật với ngày cũ. Nếu chỉ dùng “lớn hơn ngày cuối” để lấy mới, pipeline có thể bỏ sót. Sổ ID cùng trạng thái nội dung giúp xử lý những mục xuất hiện lại trong cửa sổ feed.
Khi feed chỉ giữ một cửa sổ ngắn, bỏ poll lâu có thể khiến một số mục không còn xuất hiện. Đừng coi không thấy item trong feed hiện tại là bằng chứng nó đã bị xóa khỏi website. Nếu cần lịch sử đầy đủ, dùng phương thức nguồn hỗ trợ và ghi giới hạn thu thập.
Một bài được sửa có thể giữ published cũ và updated mới. Hợp đồng xử lý cần biết trường nào dùng để báo cập nhật, nhưng khóa vẫn dựa trên định danh. Không tạo bài mới từ mỗi lần updated đổi nếu mục tiêu là theo dõi phiên bản của cùng một bài.
thu thập RSS và Atom bằng Python với nội dung và liên kết
Feed có thể đưa tóm tắt hoặc nội dung khác độ dài trang bài. Pipeline cần phân biệt loại dữ liệu đã nhận. Không gắn nhãn full_text cho description chỉ vì nó chứa nhiều chữ hoặc có vài thẻ HTML.
Giữ raw payload và bản hiển thị riêng
Một trường nội dung có thể chứa HTML hoặc text theo cấu trúc feed. Khi chuyển sang chuỗi hiển thị, cần xử lý đúng lớp và giữ bản gốc cho truy vết. Không unescape lặp lại mọi chuỗi vì có thể đổi nội dung literal mà nguồn muốn giữ.
Nếu đưa HTML từ feed lên giao diện, áp quy trình hiển thị an toàn của ứng dụng. Parser feed không tự chứng nhận nội dung đó phù hợp để chèn trực tiếp. Với tác vụ chỉ phân tích text, có thể trích chữ theo quy tắc riêng và giữ phương pháp trong metadata.
Tài liệu ElementTree giúp kiểm cách duyệt namespace và phần tử. Ví dụ fixture nhỏ không xử lý mọi loại nội dung nhúng. Khi cần extension hoặc kiểu text khác, thêm mẫu trước khi mở rộng code.
Link bài và enclosure có mục đích khác
Link bài thường phục vụ mở nội dung nguồn, còn enclosure có thể là tài nguyên đính kèm theo feed. Không tải mọi URL tìm được mà không xét vai trò. Công việc chỉ thu metadata có thể không cần tải ảnh, âm thanh hoặc tệp lớn.
Nếu có URL tương đối, resolve theo ngữ cảnh phù hợp với feed và thư viện. Lưu URL gốc cùng URL đã chuẩn hóa nếu dự án cần đối chiếu. Một phép nối chuỗi đơn giản có thể làm sai đường dẫn cha hoặc fragment.
Khi link thay đổi nhưng ID giữ nguyên, quyết định đó là cập nhật vị trí của cùng item theo hợp đồng nguồn. Đừng xóa lịch sử URL trước nếu nó cần cho provenance. Việc một đường dẫn chuyển hướng không làm định danh bài tự mất ý nghĩa.
thu thập RSS và Atom bằng Python với HTTP có điều kiện
Polling cần tôn trọng chính sách nguồn và tránh tải lặp không cần thiết. Nếu nguồn hỗ trợ validator HTTP, client có thể dùng request có điều kiện theo tài liệu và phản hồi thực. Đây là lớp tối ưu tải feed, khác với sổ chống trùng item.
HTTP validator và sổ item
Phân biệt 304 với feed rỗng
Response 304 không phải một XML feed mới chứa không item. Nó chỉ có ý nghĩa trong điều kiện HTTP tương ứng và cần dùng trạng thái đã lưu theo hợp đồng client. Không đưa body rỗng của 304 vào parser rồi đánh dấu nguồn đã xóa toàn bộ bài.
Validator của feed thuộc representation feed được lấy, không phải ID từng item. Một feed không đổi vẫn có thể được poll nhiều lần, còn sổ item không nên phát sinh record mới. Tách cache HTTP và ledger giúp hai lớp không ghi đè ý nghĩa của nhau.
Nếu validator không còn hợp lệ hoặc nguồn đổi, xử lý response thực và cập nhật trạng thái theo kết quả. Không giả định mọi website gửi ETag hoặc Last-Modified. Khi không có, vẫn cần lịch poll có giới hạn và sổ chống trùng phía ứng dụng.
Retry có giới hạn và không tăng tải theo lỗi parser
Lỗi tạm ở mạng khác lỗi XML cố định của một snapshot. Retry cùng byte hỏng liên tục sẽ không sửa cú pháp. Giữ hash payload và lý do để quyết định chờ nguồn sửa, dùng adapter có kiểm hoặc chuyển người vận hành xem.
Nếu nguồn báo hạn chế truy cập, tuân theo chính sách và thông tin phản hồi phù hợp. Không đổi proxy để vượt hạn mức hoặc tiếp tục ngoài quyền. Bài này không hứa proxy làm tăng quota của một feed hoặc API.
Trước khi mua proxy cho tầng tải, xác định nhu cầu tuyến thật sự của nguồn được phép. Parser RSS/Atom và ledger có thể chạy offline trên fixture để kiểm trước. Bộ thử không đánh giá gateway ProxyVN hoặc lịch polling production.
thu thập RSS và Atom bằng Python với checkpoint
Checkpoint cần được cập nhật sau khi các item đã được xử lý theo mức hoàn tất yêu cầu. Nếu lưu validator mới trước khi commit dữ liệu, lần sau có thể nhận 304 trong khi item chưa vào kho. Thiết kế giao dịch cần nối hai trạng thái này phù hợp với hệ thống lưu.
Một lượt poll nên có trạng thái riêng
Ghi mã lượt, source_id, thời điểm bắt đầu, status tải và kết quả parse. Sau đó ghi số item mới, thay đổi, không đổi và lỗi. Tổng các nhóm cần khớp số item đã xử lý theo chính sách, không chỉ có một cột “thành công”.
Nếu một item lỗi trong feed tốt, quyết định giữ phần còn lại hay dừng cả lượt theo yêu cầu dữ liệu. Cờ partial phải còn nhìn thấy trong báo cáo. Không bỏ item lỗi rồi cập nhật checkpoint như thể mọi dữ liệu đã được nhận đủ.
Khi tiến trình crash, lần chạy sau cần xử lý lặp an toàn bằng khóa theo nguồn và ID. Sổ phiên bản giúp không tạo thêm bài mới chỉ vì cùng item được gửi lại. Kiểm ca chạy cùng fixture hai lần trước khi đưa vào lịch định kỳ.
Lưu lịch sử thay vì ghi đè mất dấu
Nếu mục tiêu theo dõi sửa bài, giữ phiên bản nội dung hoặc ít nhất hash cùng thời điểm quan sát thay đổi. Chỉ ghi giá trị cuối sẽ mất khả năng trả lời một bài đã được sửa khi nào theo quan sát hệ thống. Thời điểm quan sát vẫn không nhất thiết là lúc nguồn thực sửa.
Lịch sử cần có chính sách lưu và quyền đọc phù hợp. Không giữ email tác giả hoặc dữ liệu không cần cho nhiệm vụ chỉ vì feed có công bố. Bộ ví dụ dùng ID, title và thời gian nên không cần thông tin liên hệ cá nhân.
Khi đổi quy tắc chuẩn hóa nội dung để tính hash, đặt version mới. Nếu không, một lần triển khai có thể làm mọi item bị đánh là sửa dù nguồn không đổi. Báo cáo cần phân biệt cập nhật nguồn và tái xử lý do thay phương pháp.
thu thập RSS và Atom bằng Python và ma trận nghiệm thu
Bộ nghiệm thu cần kiểm ID, namespace, ngày giờ và hành vi cập nhật. Hai fixture nhỏ giúp người nhận chạy nhanh trước khi thêm nguồn thật. Kết quả phải gắn với những trường đã thử, không gọi đó là hỗ trợ mọi feed ngoài Internet.
Ma trận item mới sửa và không đổi
Các ca cấu trúc tối thiểu
RSS guid có isPermaLink false phải được giữ như ID. Atom entry có namespace cần được tìm đúng. Hai source có cùng ID ngắn phải tạo hai khóa riêng. Item thiếu ID cần nhánh fallback hoặc trạng thái từ chối theo hợp đồng đã định.
Ca ngày giờ gồm timestamp có offset, giá trị thiếu và giá trị sai định dạng. Kiểm UTC sau chuẩn hóa nếu đó là output yêu cầu, giữ raw để đối chiếu. Không lấy timezone của máy hoặc tuyến proxy làm lời giải cho mọi chuỗi thiếu múi giờ.
Ca feed có thứ tự item đổi nhưng nội dung không đổi phải không tạo bài mới. Ca một ID cũ có title hoặc body sửa cần đi vào nhóm cập nhật theo trường được theo dõi. Ca poll lại cùng snapshot cần vào nhóm không đổi.
Phạm vi đã kiểm và phần cần mở rộng
Trong bộ thử cục bộ, hai fixture xác nhận đường đọc guid RSS và id Atom có namespace. Sổ theo nguồn có thể kiểm bằng các lần upsert tự tạo mà không gửi request bên ngoài. Các nhánh conditional GET, extension phức tạp và feed production cần ca riêng trước khi triển khai.
Nếu dự án dùng thư viện feed khác, chạy cùng expected output để kiểm hình dạng dữ liệu. Các thư viện có thể chuẩn hóa ngày hoặc ID theo cách khác nhau. Không lấy một dictionary nhìn giống fixture làm bằng chứng mọi trường đã giữ đúng ngữ nghĩa.
Giữ fixture, version parser, schema ledger và báo cáo theo từng lượt. Khi nguồn đổi cấu trúc, bộ mẫu cũ cho biết phần nào bị hồi quy và phần nào cần adapter mới. Một hệ thống cập nhật ổn định cần giữ được sự khác biệt giữa item mới, item sửa và lần quan sát lặp.
thu thập RSS và Atom bằng Python qua một lượt cập nhật mẫu
Sổ lab cho phép nhìn rõ khác biệt giữa lần xuất hiện và phiên bản nội dung. Bốn thao tác tự tạo tạo hai khóa item và ba phiên bản cần giữ. Không có request mạng trong ca này; nó chỉ kiểm quyết định upsert sau khi parser đã trả dữ liệu.
Lần đầu và lần lặp không đổi
Lần đầu nguồn rss-lab gửi ID lab-1 với title One, sổ trả trạng thái new. Hệ thống tạo một khóa và một phiên bản. Đây là thời điểm first_seen của bộ quan sát nếu ứng dụng có ghi, không nhất thiết là lúc bài được xuất bản ở nguồn.
Lần thứ hai cùng nguồn, cùng ID và cùng payload tạo trạng thái unchanged. Khóa và số phiên bản không tăng. Có thể cập nhật last_seen riêng nếu mục tiêu cần theo dõi hiện diện, nhưng không nên cộng lượt đó vào số bài mới.
Lần thứ ba giữ ID nhưng title đổi thành One revised, sổ trả updated. Nó vẫn là một item theo hợp đồng lab, có phiên bản nội dung mới. Nếu pipeline tạo một bài mới ở bước này, kiểm xem khóa có bị phụ thuộc title hoặc hash body thay vì ID không.
Lần thứ tư nguồn atom-lab dùng cùng chuỗi ID ngắn lab-1 với payload mới. Vì source_id khác, trạng thái là new và tổng khóa thành hai. Ca này chứng minh phạm vi nguồn cần được giữ ngay cả khi payload giống một phiên bản đã thấy ở nơi khác.
Đọc số lượng đúng đơn vị
Sau bốn thao tác, tổng số lượt quan sát là bốn, tổng item là hai và tổng phiên bản được giữ là ba. Ba số phục vụ ba câu hỏi khác nhau. Gọi tất cả là “số bài thu thập” sẽ khiến báo cáo phóng đại sản lượng hoặc bỏ mất lịch sử sửa.
Sổ lab chưa có cơ sở dữ liệu giao dịch hoặc nhiều worker. Nếu triển khai song song, cần ràng buộc duy nhất hoặc thao tác upsert phù hợp với hệ thống lưu. Hai worker cùng thấy item mới có thể tạo record lặp nếu chỉ kiểm dict hoặc SELECT trước khi INSERT.
Checkpoint nên được commit cùng mức hoàn tất dữ liệu mà ứng dụng cần. Nếu lưu trạng thái đã xử lý trước khi ghi output, crash có thể gây bỏ sót. Nếu ghi output trước nhưng checkpoint chưa xong, lần sau cần khóa idempotent để không nhân đôi dữ liệu.
Một thời điểm có hai cách biểu diễn
Trong phép thử ngày giờ, chuỗi RSS có giờ 07:00 với offset cộng bảy tương ứng 00:00 UTC cùng ngày. Chuỗi Atom dùng Z đã chỉ UTC. Sau parse đúng, hai giá trị aware phải so bằng nhau theo thời điểm dù chuỗi gốc khác.
Nếu chỉ so chuỗi hoặc bỏ phần offset, hệ thống có thể đánh chúng là cách nhau bảy giờ. Điều này ảnh hưởng thứ tự cập nhật và báo cáo theo ngày. Giữ raw timestamp giúp người nhận kiểm được phép chuyển thay vì chỉ nhìn một giá trị cuối.
Ca thiếu timezone không được giải bằng cách lấy cộng bảy cho mọi nguồn. Một số nguồn có quy ước riêng, một số dữ liệu là lỗi. Nếu có adapter suy luận, ghi nguồn quy ước và trạng thái inferred để khác với thời gian được nguồn công bố đủ thông tin.
Feed biến mất item không đồng nghĩa xóa bài
Một feed có thể chỉ giữ các mục gần đây. Khi item cũ không còn trong lần poll, sổ nên ghi không xuất hiện trong cửa sổ hiện tại theo thiết kế, không tự phát một lệnh xóa nội dung. Muốn xác nhận xóa cần tín hiệu phù hợp từ nguồn hoặc một quy trình đối soát riêng được phép.
Không gọi lại mọi URL cũ ở mỗi lượt poll chỉ để kiểm hiện diện nếu nhiệm vụ không yêu cầu. Điều đó có thể làm mất lợi ích dùng feed và tăng tải nguồn. Chọn chu kỳ đối soát theo nhu cầu, chính sách nguồn và dữ liệu thực của dự án.
Nếu một item được đưa trở lại feed với ID cũ và nội dung không đổi, sổ nên vẫn nhận ra nó. Đây là lý do giữ ledger lâu hơn cửa sổ feed theo chính sách phù hợp. Xóa mọi khóa không thấy ở lần poll gần nhất sẽ làm bài cũ liên tục thành bài mới.
Nâng schema mà không làm mất lịch sử
Khi thêm một trường mới như category vào output, xác định nó có tham gia hash nội dung hay chỉ là metadata phụ. Nếu đưa vào hash, các item có thể được tái phân loại là thay đổi phương pháp. Ghi version để báo cáo không khẳng định nguồn đã sửa toàn bộ bài.
Một quá trình migration nên đọc snapshot hoặc record raw còn được phép giữ để tính lại. Không suy dữ liệu mới từ title hoặc URL nếu nguồn chưa công bố. Trường thiếu có thể giữ null và trạng thái cho đến khi được thu theo quy trình phù hợp.
Trước khi đổi ledger chính, chạy các lượt lab theo cả schema cũ và mới. Kiểm khóa vẫn đúng, số phiên bản có thể giải thích và các field thời gian không bị ghi đè. Những ca nhỏ này giúp phát hiện lỗi tích hợp trước khi lịch poll chạy tự động nhiều lần.
Khóa theo nguồn và ID giữ đúng danh tính; hash nội dung cùng lịch sử giúp nhận biết bài cũ đã được sửa.
Anh em hãy lưu dữ liệu mẫu cùng cấu hình và kết quả đối chiếu để lần cập nhật sau có cơ sở kiểm lại. Tham khảo thêm tại Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam. Bắt đầu từ phạm vi nhỏ và tiêu chí rõ ràng khi triển khai thu thập RSS và Atom bằng Python.


