
readability-lxml trích nội dung bài viết có đối chứng
readability-lxml trích nội dung bài viết hoạt động trên HTML đã tải và dùng heuristic để chọn phần bài chính. Vì vậy output cần được kiểm theo loại trang, không chỉ theo việc có chữ. Bài này so trang tin, trang sản phẩm và trang rỗng, giữ nguồn cùng URL ảnh rồi ghi rõ những ca công cụ chưa đáp ứng. ProxyVN hướng dẫn cách kiểm trên dữ liệu mẫu.
readability-lxml trích nội dung bài viết từ snapshot
readability-lxml nhận một tài liệu HTML và tạo phần nội dung được chọn cùng thông tin tiêu đề theo API. Nó không phải HTTP proxy và cũng không tự bảo đảm snapshot đầu vào là bài cần lấy. Bước tải và bước chọn nội dung nên có bằng chứng riêng.
Nếu client nhận HTML đăng nhập, thuật toán vẫn có thể trả một vùng chữ hợp lệ về cấu trúc. Vì vậy phải giữ status, URL cuối và loại response trước khi đánh giá parser. Không xem output không rỗng là xác nhận truy cập đúng trang.
README python-readability là nguồn đối chiếu cách dùng Document. Ví dụ của bài dùng tệp tự tạo đã được lưu, không fetch lại website cho mỗi lựa chọn. Cách tổ chức này giúp so output trên cùng byte đầu vào.
Heuristic không phải nhãn thể loại của website
Thuật toán chọn vùng theo các tín hiệu của cấu trúc và nội dung, không tự hiểu mọi mục tiêu nghiệp vụ. Một trang sản phẩm có thể vẫn được trả về một phần body. Điều đó không chứng minh nó đã trở thành một bài tin hoặc được chuẩn hóa thành dữ liệu Product.
Nếu tác vụ chỉ nhận bài viết, cần bước phân loại hoặc điều kiện chấp nhận ngoài phép gọi summary. Nếu tác vụ có nhiều loại trang, chọn nhánh xử lý phù hợp. Không ép mọi output về cùng schema main_text rồi bỏ qua loại input.
Bộ mẫu trong bài có trang tin chứa marker, trang sản phẩm ngắn và trang rỗng. Các nhãn được biết trước vì dữ liệu tự tạo. Chúng phục vụ đối chứng chức năng và giới hạn, không tạo một benchmark độ chính xác trên nhiều website thật.
readability-lxml trích nội dung bài viết với HTML và text
summary trả phần HTML được chọn theo công cụ, không phải luôn là chuỗi văn bản thuần. Nếu downstream cần text, cần bước lấy chữ từ HTML đó. Nếu cần giữ ảnh hoặc liên kết, đừng chuyển thành text quá sớm rồi cố tìm lại các URL đã mất.
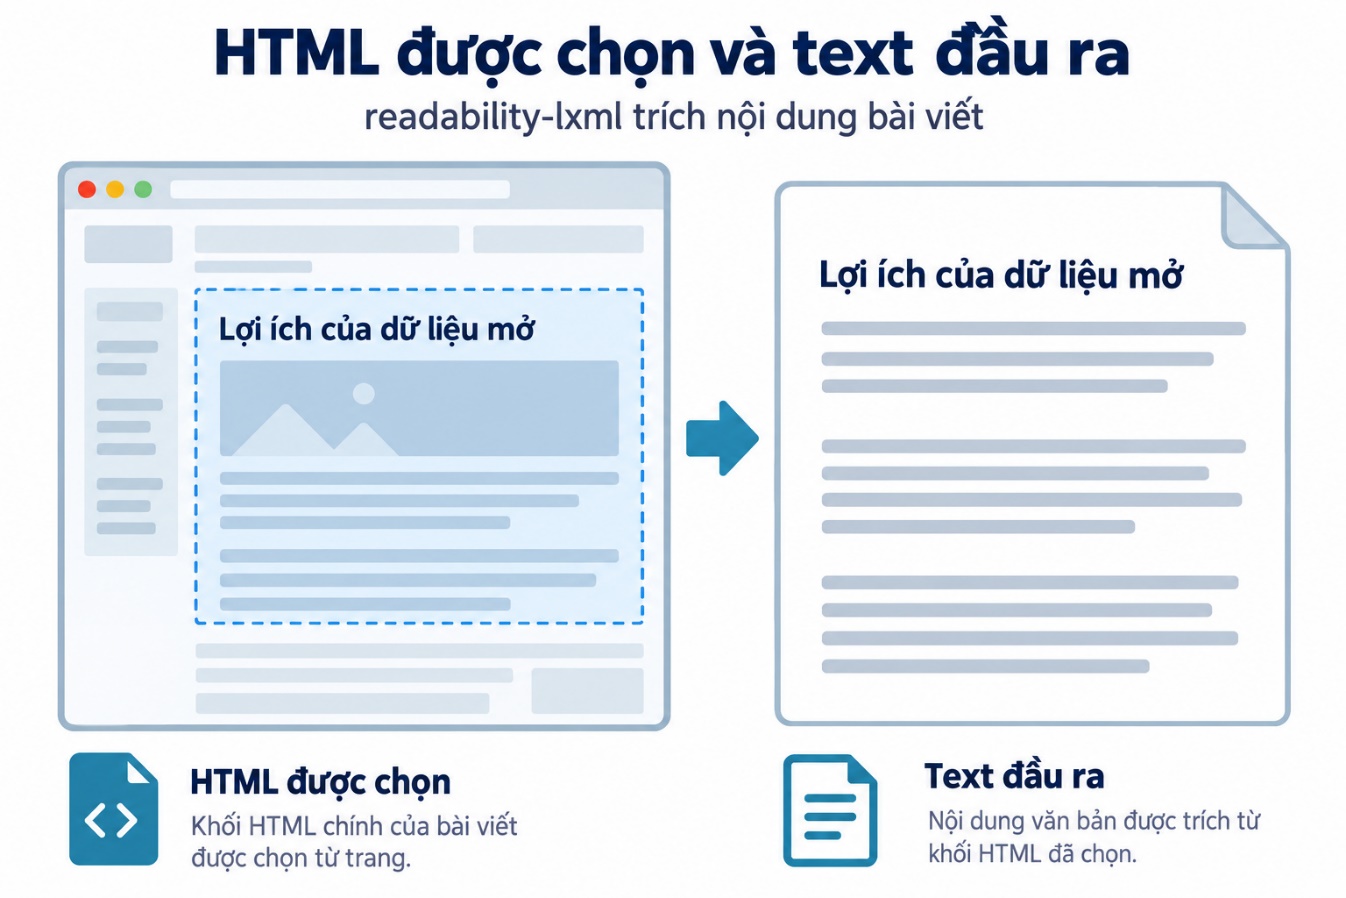
HTML được chọn và text đầu ra
Ví dụ đọc tệp và giữ hai dạng đầu ra
Đoạn mã cần news.html là fixture trang tin đã chuẩn bị. title, article_html và article_text được lưu thành các trường riêng để không nhầm ngữ nghĩa. URL nguồn là metadata của snapshot, không phải request do Document tự gửi.
from pathlib import Path
from readability import Document
from lxml import html as LH
import json
source_url = 'http://lab.invalid/news'
raw = Path('news.html').read_text(encoding='utf-8')
document = Document(raw)
article_html = document.summary()
tree = LH.fromstring(article_html)
paragraphs = [el.text_content().strip() for el in tree.xpath('//h1|//p')]
row = {'source_url': source_url,
       'title': document.short_title(),
       'article_html': article_html,
       'article_text': '\n'.join(text for text in paragraphs if text)}
Path('readability.jsonl').write_text(
    json.dumps(row, ensure_ascii=False) + '\n', encoding='utf-8')
Trường HTML hỗ trợ xem lại cấu trúc được chọn, còn text thuận tiện cho tìm kiếm hoặc xử lý ngôn ngữ. Hai trường không phải bản sao byte của response HTTP. Nếu cần raw hash, giữ byte snapshot trước decode ở schema riêng.
Tài liệu lxml.html giúp đối chiếu thao tác cây và text_content. Một phép lấy chữ có thể làm mất dấu phân cách giữa các phần tử nếu không có quy tắc phù hợp. Kiểm output theo đoạn, không chỉ tổng ký tự.
Chọn tiêu đề theo expected output
title và short_title có thể phục vụ cách diễn giải khác của thư viện. Chọn API theo tác vụ và giữ tên trường rõ. Không tự đổi giữa chúng chỉ vì một tiêu đề ở nguồn cụ thể nhìn đẹp hơn mà không cập nhật bộ kiểm.
Trong fixture, tiêu đề Laboratory water station update là nhãn để so. Nếu output thêm tên website hoặc mất phần tên bài, kiểm cấu trúc head và heading đầu vào. Một thay đổi title có thể do nguồn hoặc do thuật toán, cần snapshot để phân biệt.
Không điền tác giả hoặc ngày vào output chỉ vì schema bài viết thường có chúng. Ví dụ này tập trung title và phần nội dung. Nếu dự án cần metadata thêm, xây bước có nguồn và kiểm riêng thay vì suy từ tên tệp hoặc thời điểm chạy.
readability-lxml trích nội dung bài viết và URL ảnh
Một phần HTML được chọn có thể còn img với src tương đối. Nếu lưu snippet ngoài ngữ cảnh trang gốc, đường dẫn đó không tự trỏ đúng tài nguyên. Cần giữ nguồn và chuẩn hóa URL theo hợp đồng trước khi dùng downstream.
Resolve tham chiếu khác với tải ảnh
Trong fixture, một img dùng /images/lab.png. Bộ trích giữ tham chiếu đó trong HTML đã chọn. Chuẩn hóa nó thành URL có scheme và host chỉ tạo một địa chỉ theo ngữ cảnh, không chứng minh ảnh tồn tại hoặc đã được tải.
from urllib.parse import urljoin
image_urls = [urljoin(source_url, value)
              for value in tree.xpath('//img/@src')]
assert image_urls == ['http://lab.invalid/images/lab.png']
Đoạn assertion chỉ áp dụng fixture có đúng ảnh đã định. Với nguồn thật, có thể có srcset, lazy loading hoặc cấu trúc khác cần hỗ trợ. Không công bố đã lấy đủ ảnh chỉ từ một XPath img/@src.
urllib.parse của Python là nguồn đối chiếu urljoin. Khi tài liệu có base URL hoặc URL cuối sau chuyển hướng, chọn ngữ cảnh phù hợp theo pipeline. Không nối đường dẫn bằng phép cộng chuỗi vì có thể sai thư mục hoặc fragment.
Giữ quyền và mục tiêu tài nguyên riêng
Tác vụ trích nội dung có thể chỉ cần danh sách URL ảnh để truy vết. Nó không tự yêu cầu tải hoặc tái sử dụng ảnh. Nếu dự án cần lưu ảnh, xác định quyền, scope và cách kiểm file ở bước khác.
Một URL ảnh ngoài host bài có thể là CDN hợp lệ nhưng vẫn cần chính sách tải đã định. Không để parser tự mở rộng crawl đến mọi đích xuất hiện trong output. Giữ danh sách tham chiếu và danh sách đã tải là hai trường hoặc bảng khác nhau.
Nếu output dùng để hiển thị trên ứng dụng, xử lý HTML theo cơ chế an toàn của sản phẩm. summary không nên được coi là ranh giới bảo vệ tổng quát cho HTML không tin cậy. Đây là một điều kiện tích hợp khác với việc chọn đúng main text.
readability-lxml trích nội dung bài viết với ba loại trang
Phản ví dụ giúp nhìn rõ vùng mà heuristic không quyết định thay ứng dụng. Một trang tin dài và một sản phẩm ngắn có thể đều trả HTML không rỗng. Bộ kiểm cần dựa trên nhãn mục tiêu, không chỉ một phép bool(summary).
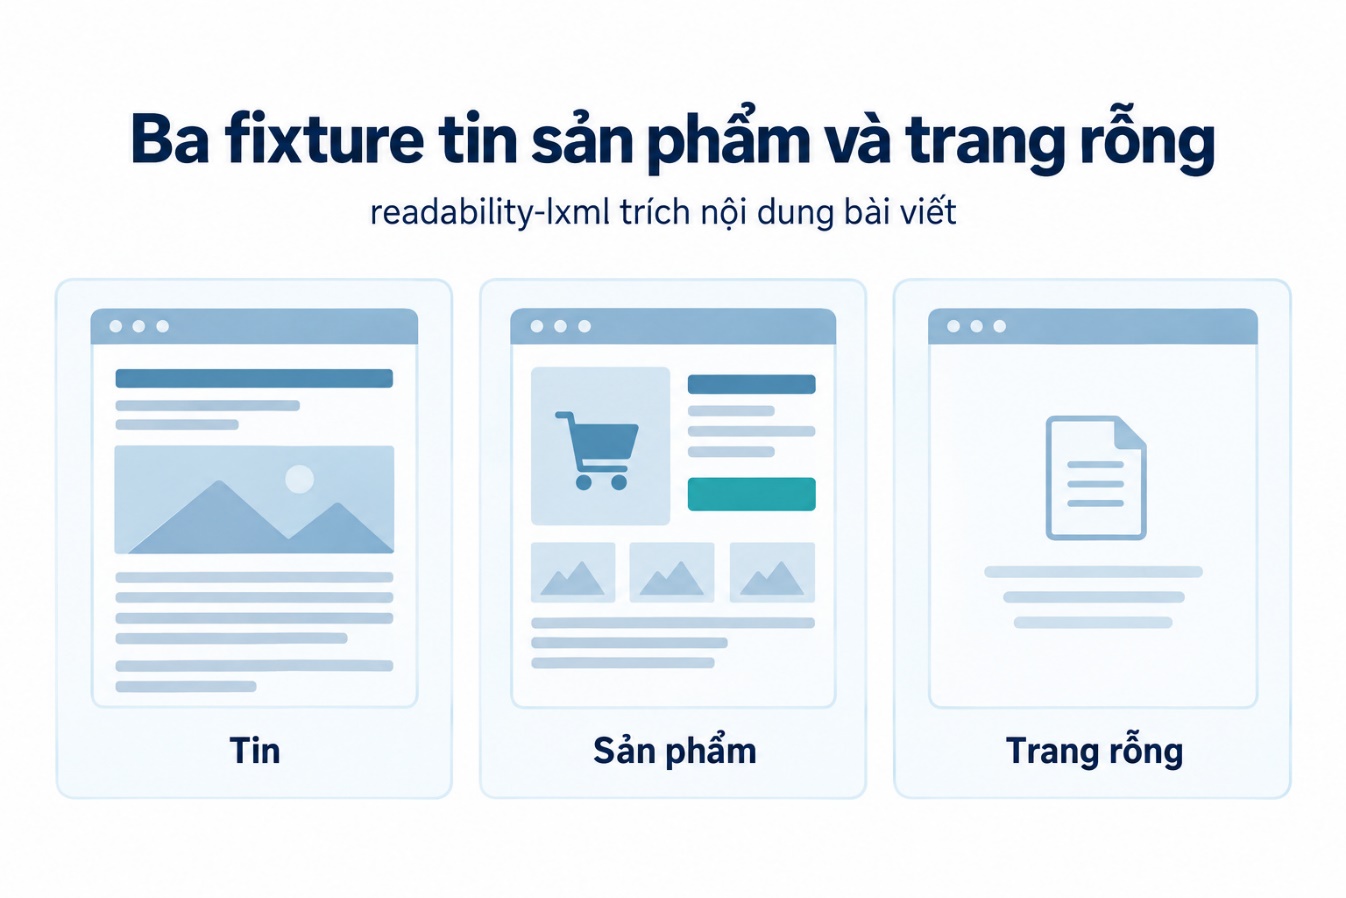
Ba fixture tin sản phẩm và trang rỗng
Fixture |
Kết quả đã quan sát |
Cách diễn giải |
|---|---|---|
Trang tin có marker |
Giữ marker và bỏ footer marker |
Đạt hai điều kiện hẹp |
Trang sản phẩm ngắn |
Vẫn trả body có chữ và nút |
Chưa phải bộ trích Product |
Trang rỗng |
Body được tạo nhưng không có text |
Cần trạng thái không có nội dung |
Trang tin có marker và footer nhiễu
Mẫu tin chứa sensor-lab-482 trong phần bài và FOOTER-NOISE-991 ở footer. Output đã giữ marker bài và không giữ marker footer trong phép thử. Text của đúng mẫu có bảy trăm bảy mươi sáu ký tự theo bộ đếm dùng trong lab.
Hai assertion này không chứng minh mọi câu đều giữ nguyên hoặc mọi loại nhiễu đều được loại. Để đánh giá toàn bài, cần bảng nhãn theo đoạn. Con số ký tự chỉ là dấu vết của fixture và version đã chạy, không phải chỉ số chất lượng tổng quát.
Ảnh tương đối trong phần bài còn được giữ ở output HTML của mẫu. Bộ thử không tải ảnh và không đo đầy đủ media. Nếu mục tiêu cần ảnh hoặc chú thích, thêm expected output riêng trước khi nhận nhánh đó đã được hỗ trợ.
Trang sản phẩm và trang rỗng
Ở mẫu sản phẩm, summary vẫn có tên Lab cup, giá và nút Buy trong body. Đây là quan sát của heuristic, không phải lỗi tự động của thư viện. Nếu ứng dụng chỉ nhận bài tin, bước phân loại cần từ chối hoặc chuyển nhánh theo nhãn nguồn.
Ở mẫu rỗng, wrapper HTML được trả nhưng text trống. Một kiểm tra chuỗi HTML không rỗng sẽ cho kết luận sai về có nội dung. Dùng text sau parse cùng điều kiện chất lượng phù hợp để xác định trạng thái.
Không lấy ngưỡng ký tự tự chọn làm chân lý về bài viết. Một thông báo ngắn có thể là dữ liệu mục tiêu hợp lệ, còn một trang menu dài có thể là nhiễu. Ngưỡng cần được hiệu chỉnh theo tập nguồn và mục tiêu, giữ các ca biên trong báo cáo.
readability-lxml trích nội dung bài viết và sai số cần đo
Chất lượng nên được đánh giá theo phần cần giữ và phần cần bỏ. So một lần với giao diện bằng mắt có ích nhưng khó tái lập nếu không giữ nhãn. Tập fixture có nguồn rõ giúp kiểm hồi quy khi đổi version.
Nội dung thiếu khác với nhiễu còn sót
Mất một đoạn kết có thể làm sai kết luận bài dù text còn dài. Giữ footer có thể làm bộ tìm kiếm hoặc chống trùng bị ảnh hưởng dù phần bài không mất. Hai loại lỗi cần cột riêng để người sửa chọn hướng phù hợp.
Nếu chỉ tối ưu output ngắn, hệ thống có thể loại quá nhiều nội dung. Nếu chỉ tối ưu giữ nhiều chữ, nó có thể trả toàn trang. Bảng nhãn theo vùng và những ví dụ thất bại giúp tránh tối ưu một đại lượng thay thế không phản ánh tác vụ.
Không sao chép điểm benchmark của một corpus khác rồi nhận đó là độ chính xác trên dữ liệu người dùng. Nếu cần tỷ lệ, thực hiện phép tính trên tập nhãn đại diện và mô tả phương pháp. Bộ ba trang tự tạo của bài chỉ kiểm cơ chế cùng giới hạn cụ thể.
Đo mapping nguồn sau khi chuẩn hóa
Record cần giữ URL, hash snapshot, phương pháp và version. Nếu một bước gộp đoạn làm mất vị trí, cân nhắc lưu thêm danh sách đoạn hoặc vùng nguồn theo nhu cầu. Không tự gán tọa độ DOM giả mà công cụ chưa cung cấp.
Một hash của article_text không thay thế hash raw HTML. Cùng HTML có thể tạo text khác khi nâng parser; hai HTML khác cũng có thể tạo cùng text. Hai định danh cần tên và vai trò riêng trong schema để việc đối soát không nhầm lớp.
Nếu text đi qua normalization Unicode hoặc bỏ khoảng trắng, ghi version của bước đó. Một khóa chống trùng được tính trước và sau làm sạch có thể khác. Giữ raw output cho phép tính lại mà không gửi request mới ra nguồn.
readability-lxml trích nội dung bài viết trong pipeline
Pipeline nên có các trạng thái tải, nhận diện trang, trích, kiểm và xuất. Mỗi bước giữ lỗi có ý nghĩa thay vì đổi mọi exception thành text rỗng. Trạng thái giúp người vận hành biết cần tải lại hay sửa parser.
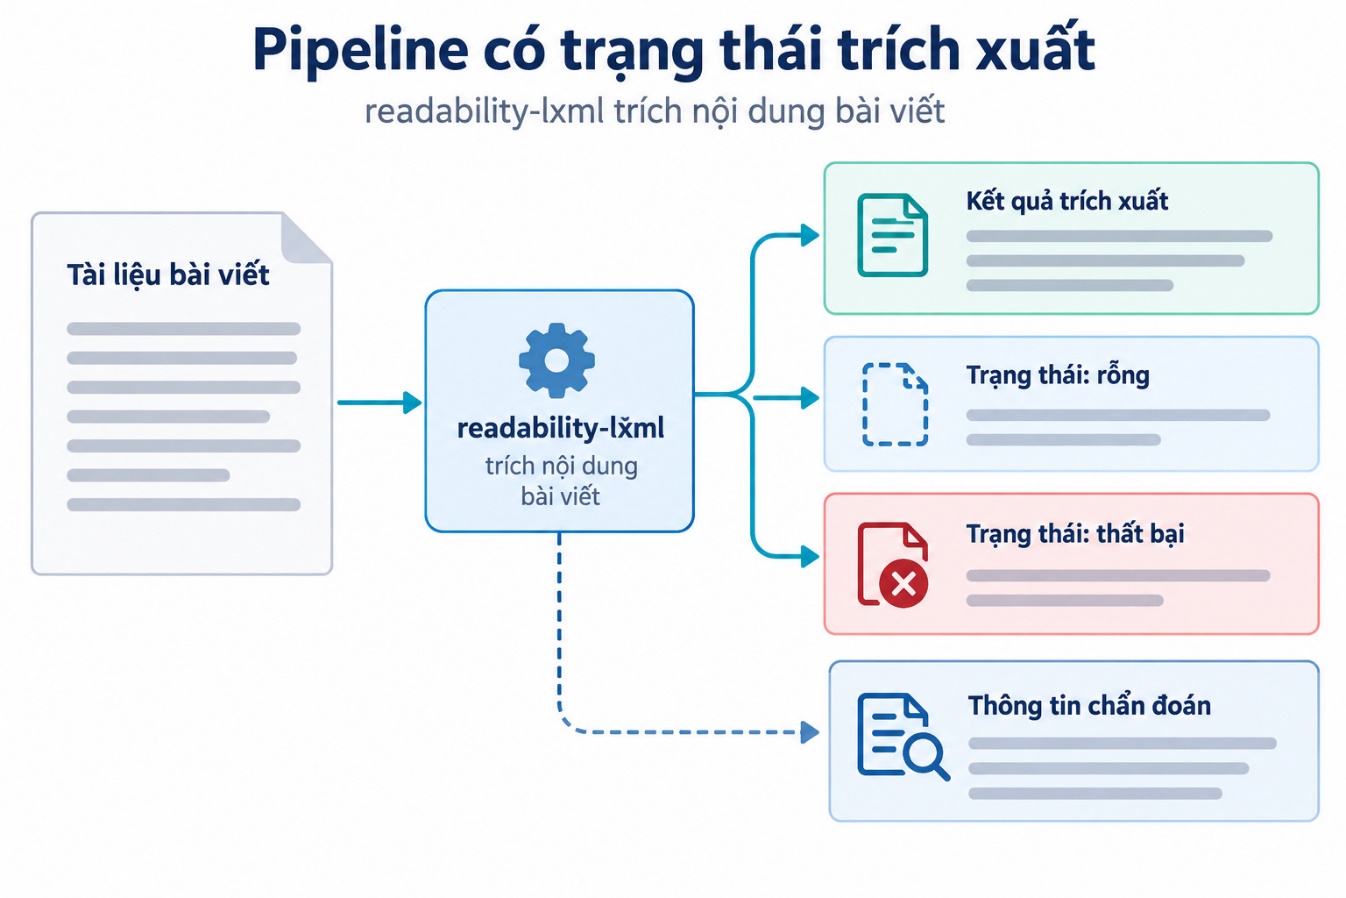
Pipeline có trạng thái trích xuất
Kiểm response trước Document
Ghi status và URL cuối theo chính sách lưu của dự án. Nếu nguồn trả trang xác thực hoặc hạn chế truy cập, xử lý theo quyền và điều kiện nguồn. Không dùng kết quả text từ trang đó để nhận một bài mục tiêu đã được thu.
Nếu HTML cần JavaScript để có bài, xác định nhu cầu render theo tác vụ. Một snapshot tĩnh thiếu nội dung không phải bằng chứng readability đã xóa nó. So raw HTML để tìm điểm đầu tiên dữ liệu không còn khớp kỳ vọng.
Khi mua proxy cho HTTP client, nghiệm thu tuyến và response riêng. Bộ readability chạy offline trên snapshot có thể được kiểm trước khi thay mạng. Bài không tuyên bố một sản phẩm proxy giúp heuristic trích chính xác hơn.
Xuất JSONL với trạng thái rõ
Một record đạt nên có text cùng provenance theo schema. Record rỗng hoặc loại trang ngoài phạm vi cần trạng thái riêng. Nếu chọn quarantine, giữ lý do đủ để tái hiện mà không đưa thông tin nhạy cảm vào log không cần thiết.
Đọc lại JSONL bằng thư viện JSON để kiểm text, HTML và URL ảnh giữ đúng kiểu. Một list URL bị biến thành chuỗi repr sẽ làm downstream khó xử lý. json của Python là nguồn đối chiếu cho serialize và parse trong ví dụ.
Không cho tệp đang ghi dở xuất hiện như output cuối nếu pipeline yêu cầu hoàn tất theo batch. Dùng tệp tạm và manifest theo thiết kế lưu. Một vài dòng đầu đọc được không chứng minh toàn batch đã được xử lý đủ.
readability-lxml trích nội dung bài viết khi nguồn đổi
Website thay bố cục có thể làm heuristic chọn vùng khác. Giữ snapshot cũ và mới giúp phân biệt thay đổi nguồn với hồi quy thư viện. Đừng chỉ sửa một regex sau khi thấy một ca lỗi rồi áp lên mọi nguồn.
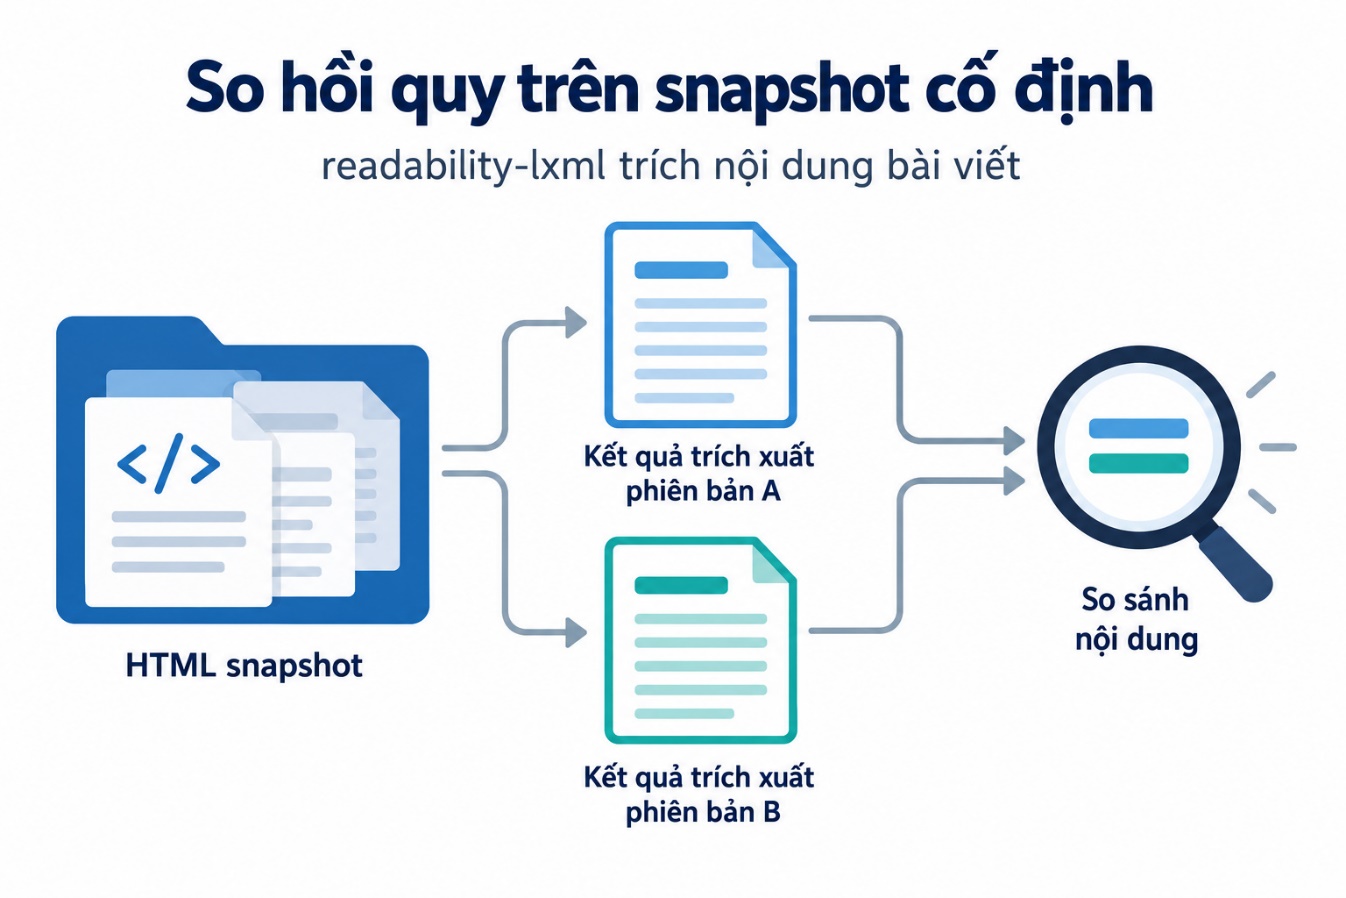
So hồi quy trên snapshot cố định
Chạy cùng fixture qua hai version
Khóa version package và dependency liên quan trong môi trường kiểm. Với mỗi snapshot, so title, main text, URL ảnh và trạng thái loại trang. Không chỉ so tổng ký tự vì một đoạn mất và một đoạn nhiễu thêm có thể bù chiều dài cho nhau.
Các ca không đạt trước đó vẫn nên có mặt để kiểm cách ứng dụng xử lý giới hạn. Nếu một version mới trả text cho trang rỗng hoặc nhận thêm menu, bộ kiểm cần phát hiện. Một nâng cấp không chỉ được đánh giá bằng ca đẹp nhất.
Nếu thêm quy tắc theo nguồn, đặt method version riêng để không lẫn với hành vi gốc của readability. Người nhận cần biết output được tạo bởi thư viện thuần hay một adapter đã sửa DOM. Giữ diff hoặc mô tả phép sửa trong hồ sơ tái hiện.
Điều kiện bàn giao
Gói bàn giao nên có ba fixture, kỳ vọng theo từng loại, version và mẫu JSONL đã đọc lại. Các ca marker và footer của bài là bằng chứng hẹp đã chạy. Những cấu trúc như bảng, trang nhiều cột hoặc lazy image chưa được nghiệm thu chỉ từ mẫu đó.
Khi muốn dùng trên nguồn mới, lấy một tập nhỏ có quyền sử dụng và gán nhãn trước. Kiểm những đoạn quan trọng và phản ví dụ ngoài mục tiêu. Không gọi một thư viện “trích được mọi bài” chỉ vì script không ném lỗi trên nhiều URL.
Giữ kết quả và giới hạn bên cạnh mã giúp người vận hành biết khi nào cần chuyển nhánh trích khác. Một fallback hoặc parser chuyên dữ liệu có thể phù hợp cho trang sản phẩm. Quyết định đó cần được kiểm theo loại dữ liệu, không phải một cách làm output luôn không rỗng.
readability-lxml trích nội dung bài viết giữ ranh giới đoạn
Một điểm cần kiểm ngay trong fixture là cách đổi HTML thành text. Gọi text_content trên toàn cây có thể nối phần kết của heading với phần đầu đoạn nếu HTML không có khoảng trắng giữa các thẻ. Khi đó từ bị dính dù nội dung ký tự nhìn như gần đủ.
Quan sát sự khác nhau giữa hai cách lấy chữ
Bản text_content trực tiếp trong phép thử có bảy trăm bảy mươi sáu ký tự. Bản lấy các block h1 và p rồi nối bằng xuống dòng giữ ranh giới của fixture. Đây là một thay đổi hậu xử lý có mục tiêu, không phải chứng cứ heuristic tự chọn vùng khác.
Trong mã ví dụ, danh sách paragraphs được tạo trước khi ghi article_text. XPath chỉ bao phủ h1 và p vì fixture chính được thiết kế theo cấu trúc đó. Nếu nguồn mục tiêu có h2, list hoặc bảng, bộ serialize cần được mở rộng cùng expected output, không mặc định đoạn mã đã giữ mọi cấu trúc.
Không nối mọi text node bằng xuống dòng vì một thẻ em hoặc a nằm giữa câu sẽ tạo ngắt dòng ngoài ý muốn. Text node và block có vai trò khác nhau. Chọn ranh giới theo cấu trúc cần giữ rồi kiểm câu có liên kết hoặc chữ nhấn mạnh trong bộ mẫu.
Một phép join bằng dấu cách trên mọi node cũng có thể thêm khoảng trắng trước dấu câu hoặc giữa các phần từ theo input. Do đó không có một phép nối ngắn phù hợp mọi HTML. Bài giữ adapter nhỏ cho fixture và nêu rõ việc cần kiểm khi áp dụng nguồn khác.
Kiểm chữ dính thay vì chỉ đếm ký tự
Đặt assertion cho ranh giới cuối title và đầu đoạn để phát hiện chữ dính. Với fixture, hai phần phải được phân cách theo hợp đồng output. Một hash hoặc số ký tự thay đổi chỉ báo có khác biệt, chưa giải thích khác biệt đó là tốt hay xấu.
Giữ cả article_html và danh sách block giúp người nhận xác định bước gây lỗi. Nếu HTML đã thiếu đoạn, điều tra extraction. Nếu HTML có đủ nhưng text bị dính, sửa serializer. Nếu text đúng mà JSONL đọc lại sai, điều tra bước ghi hoặc đọc tệp.
Trong downstream tìm kiếm, chữ dính có thể làm tokenization khác và giảm khả năng tìm đúng cụm. Trong trích dẫn, mất xuống dòng có thể làm lẫn heading với câu. Một lỗi nhỏ ở ranh giới văn bản có thể ảnh hưởng tác vụ dù tổng số ký tự chỉ chênh vài đơn vị.
Không lấy việc thêm ba dấu phân cách trong một fixture làm quy tắc sửa mọi trang. Giữ logic theo block và kiểm cấu trúc cụ thể. Những con số quan sát chỉ mô tả input đã biết, không tạo công thức phụ thuộc chiều dài cho nguồn mới.
readability-lxml trích nội dung bài viết với bộ hồi quy nhỏ
Bộ hồi quy nên giữ phản ví dụ mà người vận hành có thể hiểu trong vài phút. Nó không cần hàng trăm URL mới để bắt một lỗi serializer. Một fixture tin, một sản phẩm và một trang rỗng đã giúp tách nhiều giả định quan trọng.
Ghi expected output theo vai trò
Trang tin có expected title, marker bài, footer bị loại và đường ảnh tham chiếu. Trang sản phẩm có nhãn ngoài mục tiêu nếu pipeline chỉ nhận bài. Trang rỗng cần trạng thái không có text thay vì dựa vào chuỗi wrapper HTML.
Không buộc output của sản phẩm thành rỗng để làm bộ trích có vẻ phân loại giỏi hơn. Thư viện có thể trả body theo heuristic; ứng dụng mới quyết định có chấp nhận không. Bộ test nên phản ánh ranh giới trách nhiệm này để không sửa thuật toán sai chỗ.
Thêm ca có cùng bài nhưng menu khác giúp kiểm độ nhạy với template. Thêm ca có một đoạn ngắn quan trọng ở cuối để nhìn nguy cơ mất nội dung. Các ca này cần nhãn trước khi chạy, tránh chỉ bổ sung những mẫu mà công cụ trả đẹp.
Nếu nguồn có ngôn ngữ khác, giữ một số mẫu theo ngôn ngữ đó. Đừng dùng corpus tiếng Anh để nhận kết luận đầy đủ cho bài tiếng Việt. Các dấu hiệu cấu trúc và độ dài có thể khác theo dữ liệu dù API gọi không đổi.
Tổ chức báo cáo để người tiếp nhận kiểm được
Một dòng báo cáo nên có fixture_id, source snapshot hash, version, profile và trạng thái. Phần lỗi ghi ngắn loại sai cùng trường liên quan. Đính kèm snippet nhỏ nhất đủ đối chiếu, không đưa toàn bộ nội dung riêng tư vào báo cáo dùng chung.
Đếm ca pass không thay cho mô tả những gì assertion đã kiểm. Ca marker pass có phạm vi hẹp hơn ca so toàn bộ các đoạn có nhãn. Tên ca cần phản ánh điều đó, chẳng hạn giữ marker và bỏ footer, thay vì gọi chung là trích chính xác.
Khi một nâng cấp làm output thay đổi, giữ bản khác biệt để người biên tập đọc. Có thể đó là cải thiện giữ thêm một đoạn đúng hoặc hồi quy lẫn menu. Không tự cập nhật expected theo output mới rồi báo mọi test đã đạt mà chưa đánh giá ý nghĩa.
Chỉ sau khi các ca chức năng được giải thích mới đánh giá thời gian và tài nguyên. Tối ưu một serializer sai có thể làm lỗi lan nhanh hơn vào nhiều record. Snapshot nhỏ có nhãn là điểm bắt đầu phù hợp để giữ tính đúng trong các lần cải tiến tiếp theo.
Lưu hai snapshot cho việc điều tra
raw_html là tài liệu trước thuật toán, còn selected_html là phần summary đã chọn. Giữ tên hai trường khác nhau giúp người nhận không nhầm vùng output với nguyên bản nguồn. Khi một câu mất, tìm nó trong raw trước rồi mới xem selected và text.
Nếu câu không có trong raw, lỗi có thể thuộc bước tải hoặc loại snapshot. Nếu có ở raw nhưng mất ở selected, điều tra heuristic. Nếu còn ở selected mà mất ở text, điều tra XPath hoặc serializer. Cách lần theo ranh giới tránh một vòng đổi proxy cho lỗi xử lý nội dung.
Không cần lưu mọi bản trung gian vô thời hạn. Chọn chính sách theo nhu cầu truy vết và quyền dữ liệu, giữ hash cùng manifest khi phù hợp. Một gói tái hiện tự tạo thường đủ cho lỗi chữ dính mà không phải chia sẻ HTML của tài khoản thật.
Nhận biết đường dẫn ảnh chưa được nghiệm thu
Danh sách URL sau urljoin vẫn chỉ là tham chiếu. Nếu một ảnh trả lỗi khi tải riêng, đó là ca ở bước thu tài nguyên, không tự làm sai assertion parser đã giữ src. Báo hai trạng thái riêng để người dùng biết cần sửa phần nào.
Nếu pipeline không có nhiệm vụ tải ảnh, đừng tạo request để làm cột trạng thái trông đầy hơn. Giữ URL và nguồn của nó là đủ theo phạm vi đó. Khi yêu cầu thay đổi, thêm bước tải có quyền và bộ kiểm MIME, byte cùng mapping ảnh theo một hợp đồng riêng.
summary có chữ không đồng nghĩa đó là bài cần lấy; hãy kiểm loại trang, phần bị mất và provenance của output.
Anh em hãy lưu dữ liệu mẫu cùng cấu hình và kết quả đối chiếu để lần cập nhật sau có cơ sở kiểm lại. Tham khảo thêm tại Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam. Bắt đầu từ phạm vi nhỏ và tiêu chí rõ ràng khi triển khai readability-lxml trích nội dung bài viết.


