
Proxy Glassdoor nghiên cứu tuyển dụng: nguồn hợp lệ, schema lương
Proxy Glassdoor nghiên cứu tuyển dụng là cách đội nhân sự xem thông tin việc làm, mức lương theo đúng khu vực mà không trộn lẫn với IP làm việc hằng ngày. Proxy không mở khoá phần nội dung cần đăng nhập. Bài này, ProxyVN đi qua phạm vi dữ liệu công khai, nguồn lương hợp lệ, cách lập schema lương theo thời điểm và ví dụ Python có kiểm tra robots.txt.
Proxy Glassdoor nghiên cứu tuyển dụng dùng vào việc gì
Nghiên cứu tuyển dụng là việc trả lời vài câu hỏi rất cụ thể. Một vị trí kỹ sư dữ liệu ở thị trường Mỹ đang được trả khoảng bao nhiêu? Doanh nghiệp cùng ngành mô tả công việc ra sao? Mức lương đăng tuyển thay đổi thế nào sau sáu tháng? Glassdoor là một trong những nơi người làm nhân sự hay mở ra để tham khảo những câu hỏi đó.
Proxy đóng vai trò hẹp hơn nhiều so với cách các bài quảng cáo thường mô tả. Nó giúp anh em xem trang từ một địa điểm mạng khác, tách lưu lượng nghiên cứu khỏi mạng công ty và giữ một điểm ra ổn định khi so sánh nhiều lần. Nó không biến dữ liệu bị giới hạn thành dữ liệu được phép lấy.
Ba nhóm người hay cần dạng nghiên cứu này
Nhóm đầu tiên là phòng nhân sự của doanh nghiệp Việt Nam tuyển người làm từ xa cho khách hàng nước ngoài. Họ cần biết mặt bằng lương ở thị trường của khách để đưa ra đề nghị hợp lý. Nhóm thứ hai là công ty tư vấn nhân sự, cần báo cáo so sánh lương theo ngành và theo thời điểm cho khách hàng.
Nhóm thứ ba là chính người đi làm, muốn biết mức đề nghị mình nhận được có thấp hơn mặt bằng hay không. Với nhóm này, xem tay vài trang là đủ, không cần công cụ tự động nào. Ba nhóm có quy mô khác nhau nhưng chung một yêu cầu: số liệu phải có nguồn và có ngày ghi nhận rõ ràng.
Proxy giải quyết phần nào của bài toán
Phần proxy giải quyết được là điểm xuất phát của kết nối. Một số trang việc làm hiển thị gợi ý địa điểm, đơn vị tiền tệ hoặc tên miền quốc gia khác nhau tùy IP người xem. Khi cần mô tả lại đúng những gì một ứng viên ở Mỹ nhìn thấy, IP Mỹ cho bối cảnh gần hơn IP Việt Nam.
Phần proxy không giải quyết được là quyền truy cập dữ liệu. Nội dung nằm sau đăng nhập, sau bước đóng góp đánh giá hoặc bị điều khoản cấm thu thập vẫn giữ nguyên trạng thái đó dù đổi bao nhiêu IP. Proxy đổi nơi kết nối xuất phát, không đổi quyền của anh em với dữ liệu.
Ý định riêng của bài so với hướng dẫn proxy chung
Blog ProxyVN đã có bài proxy nghiên cứu thị trường nói về thu thập dữ liệu theo khu vực ở mức tổng quan. Bài này đi hẹp vào dữ liệu tuyển dụng và lương. Trọng tâm là cách chọn nguồn, cách lưu số liệu sao cho so sánh được theo thời gian, chứ không phải cách cấu hình proxy cho mọi website.
Tóm lại, proxy Glassdoor nghiên cứu tuyển dụng hữu ích khi anh em cần đúng góc nhìn khu vực và cần tách mạng. Giá trị thật của dự án nằm ở nguồn dữ liệu và cách lưu trữ, hai phần chiếm phần lớn bài viết.
Ranh giới dữ liệu khi dùng proxy Glassdoor nghiên cứu tuyển dụng
Trước khi viết dòng code nào, anh em cần biết rõ phần nào của Glassdoor được xem, phần nào được lưu và phần nào không được đụng tới bằng công cụ tự động. Ranh giới này đến từ hai văn bản: điều khoản sử dụng và tệp robots.txt. Hai văn bản có vai trò khác nhau nên cần đọc cả hai.
Ba vùng dữ liệu
Điều khoản sử dụng nói gì về thu thập tự động
Điều khoản sử dụng của Glassdoor mà ProxyVN đối chiếu ngày 23/10/2026 có một mục liệt kê các hành vi người dùng không được làm. Trong đó có việc đưa phần mềm hoặc tác nhân tự động vào dịch vụ để cào, tách hoặc khai thác dữ liệu khi chưa có văn bản cho phép của Glassdoor. Điều khoản cũng hạn chế việc nhúng, sao chép nguyên phần dịch vụ sang website khác.
Điều này có nghĩa một bot tự động đi qua trang lương, trang đánh giá của Glassdoor để gom dữ liệu là hành vi điều khoản không cho phép. Dùng proxy hay không dùng proxy không thay đổi kết luận đó. Nếu doanh nghiệp cần dữ liệu Glassdoor ở quy mô lớn, con đường đúng là liên hệ Glassdoor để có thoả thuận bằng văn bản.
robots.txt chỉ là một lớp tín hiệu
Tệp robots.txt của glassdoor.com ngày 23/10/2026 có hàng trăm dòng, chặn nhiều đường dẫn như trang tìm kiếm có tham số, trang phân trang của đánh giá và lương. Chuẩn RFC 9309 về Robots Exclusion Protocol mô tả robots.txt là cách chủ website báo cho trình thu thập biết đường dẫn nào không nên truy cập. Chuẩn này cũng nói rõ robots.txt không phải cơ chế phân quyền.
Vì vậy, một đường dẫn không bị chặn trong robots.txt chưa có nghĩa là được phép cào. Điều khoản sử dụng vẫn là văn bản ràng buộc người dùng dịch vụ. Với Glassdoor, khi điều khoản đã cấm thu thập tự động, anh em không cần tranh luận về từng dòng Allow hay Disallow nữa.
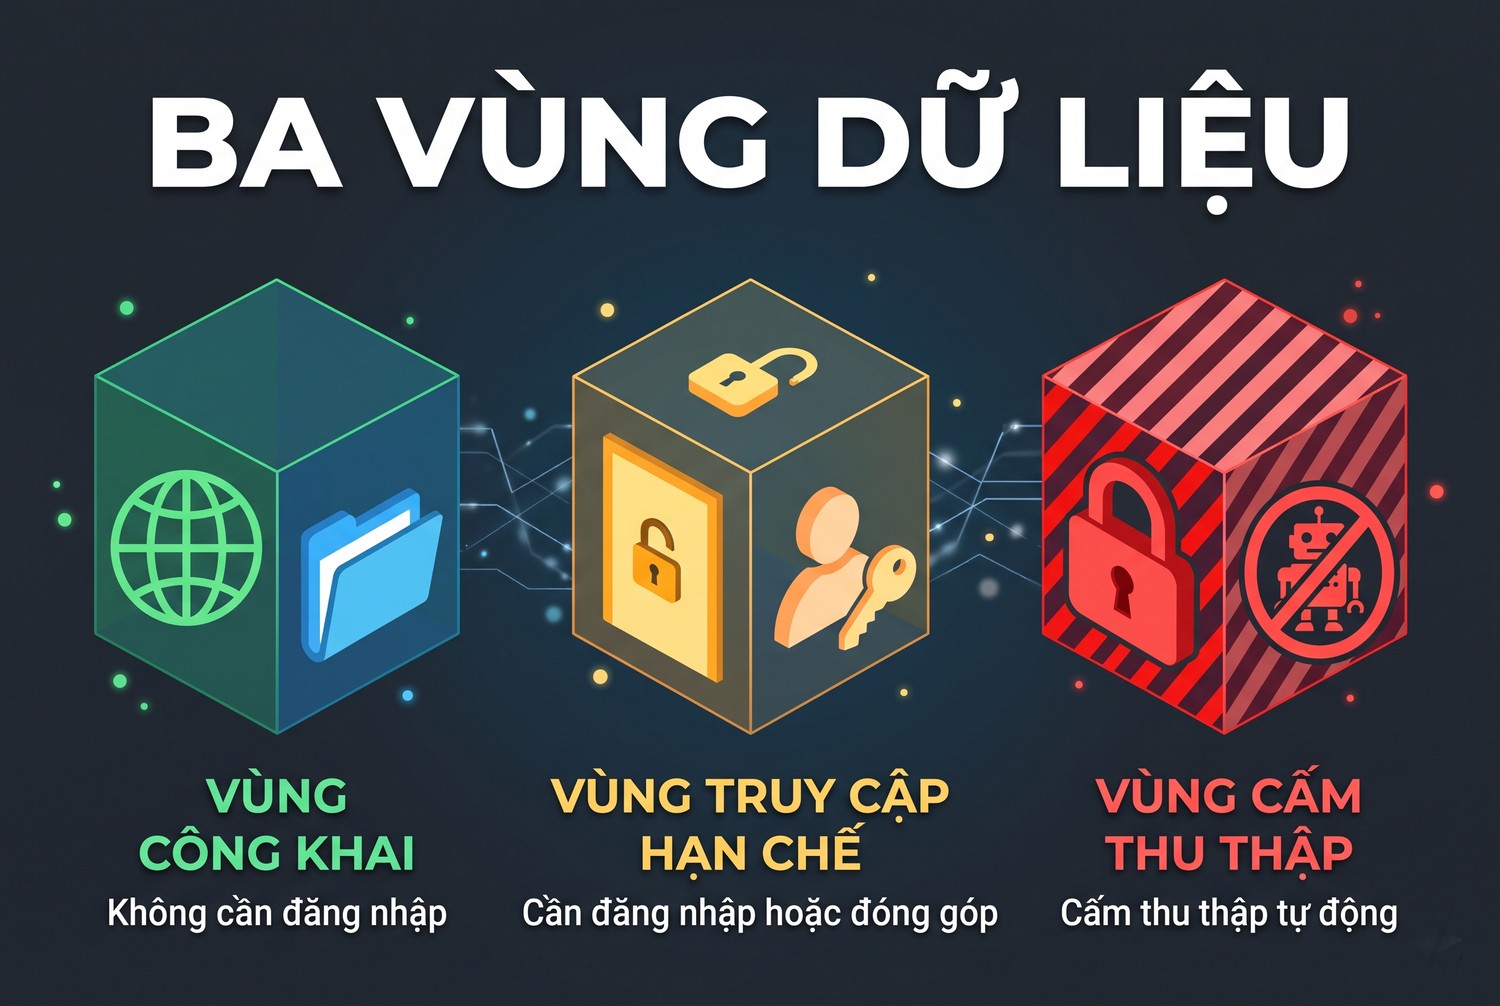
Ba vùng dữ liệu cần phân biệt
Để làm việc gọn, ProxyVN chia nội dung liên quan tới tuyển dụng thành ba vùng. Mỗi vùng có cách xử lý riêng và không được trộn lẫn trong cùng một quy trình. Danh sách dưới đây áp dụng cho Glassdoor và cũng dùng được khi anh em đánh giá các trang việc làm khác.
- Vùng xem tay công khai: trang người dùng mở được bằng trình duyệt mà không cần đăng nhập. Được xem, được ghi chú số liệu tổng hợp kèm nguồn, không sao chép nguyên văn đánh giá.
- Vùng cần đăng nhập hoặc đóng góp: Glassdoor có thể yêu cầu tạo tài khoản hoặc đóng góp nội dung trước khi cho xem tiếp. Bài này không hướng dẫn né bước đó dưới bất kỳ hình thức nào.
- Vùng cấm tự động: mọi thao tác cào, tách, khai thác dữ liệu bằng công cụ khi chưa có văn bản cho phép. Proxy không được dùng để vào vùng này.
Kết lại, ranh giới của proxy Glassdoor nghiên cứu tuyển dụng khá rõ: xem tay phần công khai, ghi chú có nguồn, không tự động hoá trên Glassdoor. Phần tự động hoá trong bài sẽ chạy trên các nguồn khác, là nội dung của phần tiếp theo.
Nguồn dữ liệu lương hợp lệ thay cho việc crawl Glassdoor
Khi đã gạt việc cào Glassdoor ra khỏi kế hoạch, câu hỏi tiếp theo là lấy số liệu lương ở đâu để có cỡ mẫu đủ lớn. Câu trả lời là kết hợp nhiều nguồn, mỗi nguồn có điểm mạnh và giới hạn riêng. Không nguồn nào một mình đủ tốt, nhưng ghép lại thì cho bức tranh đáng tin hơn một trang tổng hợp duy nhất.
Tin tuyển dụng trên website của chính doanh nghiệp
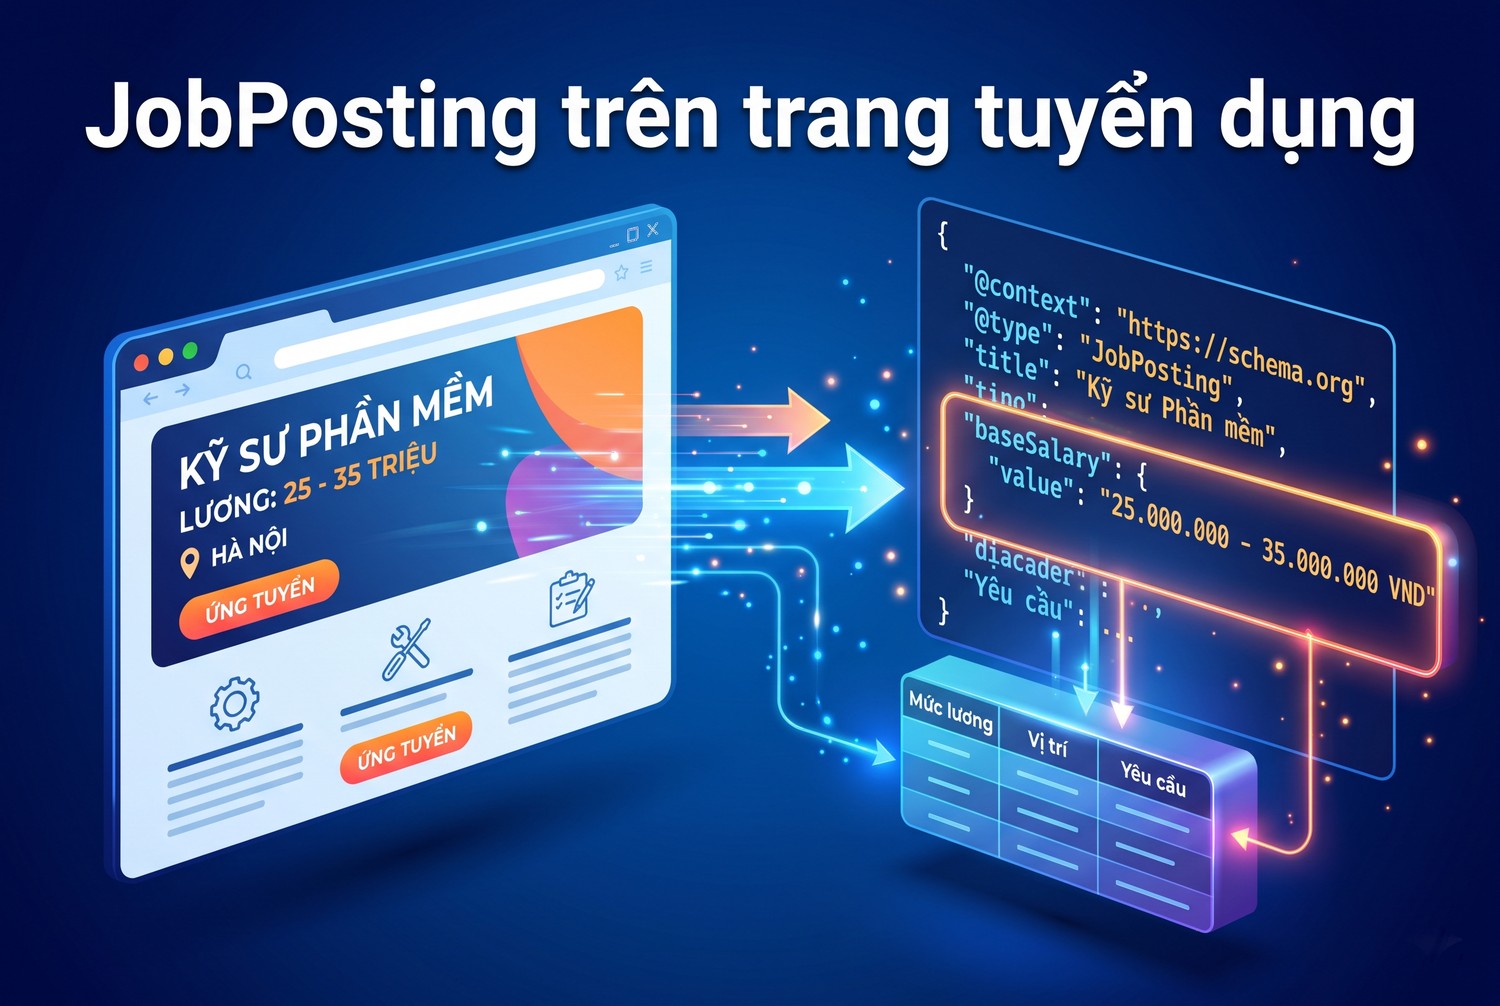
Nhiều doanh nghiệp đăng tin tuyển dụng trên trang nghề nghiệp của mình và đánh dấu bằng dữ liệu có cấu trúc. Tài liệu JobPosting của Google Search Central mô tả các thuộc tính như title, datePosted, validThrough, jobLocation và baseSalary. Thuộc tính baseSalary chứa tiền tệ, giá trị hoặc khoảng giá trị và đơn vị như HOUR, MONTH, YEAR.
Đây là nguồn rất phù hợp cho nghiên cứu vì doanh nghiệp tự công bố, có ngày đăng và có đơn vị rõ ràng. Anh em vẫn cần đọc điều khoản và robots.txt của từng website trước khi đưa vào danh sách thu thập. Nhiều trang nghề nghiệp chạy trên nền tảng tuyển dụng bên thứ ba, nên điều khoản có thể thuộc về nền tảng đó.
Số liệu thống kê chính thức
Ở thị trường Mỹ, Cục Thống kê Lao động (BLS) công bố khảo sát việc làm và tiền lương theo nghề OEWS, có chia theo bang và vùng đô thị. Số liệu này đi theo năm khảo sát, nên không bắt kịp biến động từng tháng. Bù lại, phương pháp được công bố công khai và cỡ mẫu lớn hơn nhiều so với dữ liệu tự khai.
Với thị trường Việt Nam, anh em nên tìm báo cáo thống kê lao động của cơ quan nhà nước và báo cáo lương thường niên do các công ty tuyển dụng phát hành. Khi trích dẫn báo cáo, ghi rõ tên tổ chức, kỳ khảo sát và trang số. Số liệu thống kê đóng vai trò mốc tham chiếu để kiểm tra các con số từ tin tuyển dụng có bị lệch quá xa hay không.
Ghi chú tay từ Glassdoor và kênh có thoả thuận
Glassdoor vẫn có ích ở vai trò nguồn đối chiếu. Người nghiên cứu mở trang bằng trình duyệt, đọc khoảng lương tổng hợp và ghi lại con số kèm đường dẫn, ngày xem. Đây là cách làm của một người đọc bình thường, không phải thu thập tự động.
Dữ liệu tự khai trên Glassdoor phản ánh những người chọn đóng góp, nên có thể lệch về một số nhóm. Khi đưa vào báo cáo, anh em đánh dấu rõ nguồn này là dữ liệu tự khai. Nếu doanh nghiệp cần nhiều hơn mức ghi chú tay, cách đúng là liên hệ Glassdoor hoặc mua dữ liệu từ đơn vị có giấy phép phân phối.
Bảng dưới tóm tắt các nguồn, cách lấy và giới hạn chính của từng nguồn. Anh em có thể dùng bảng này làm phụ lục phương pháp cho báo cáo gửi khách hàng.
Nguồn |
Cách lấy |
Điểm mạnh |
Giới hạn |
|---|---|---|---|
JobPosting trên web doanh nghiệp |
Tự động, sau khi kiểm tra điều khoản và robots.txt |
Có ngày đăng, đơn vị lương rõ |
Không phải tin nào cũng ghi lương |
Thống kê chính thức |
Tải báo cáo hoặc bảng dữ liệu công bố |
Phương pháp công khai, cỡ mẫu lớn |
Cập nhật theo năm, chậm hơn thị trường |
Glassdoor xem tay |
Đọc bằng trình duyệt, ghi chú có nguồn |
Có góc nhìn người lao động |
Tự khai, cấm thu thập tự động |
Dữ liệu có giấy phép |
Hợp đồng với đơn vị phân phối |
Quy mô lớn, có hỗ trợ pháp lý |
Có chi phí, phụ thuộc điều khoản hợp đồng |
Nhìn chung, nguồn hợp lệ cho dự án proxy Glassdoor nghiên cứu tuyển dụng không thiếu. Việc khó hơn là lưu chúng về cùng một cấu trúc để so sánh được với nhau.
Lập schema mức lương và thời điểm cho proxy Glassdoor nghiên cứu tuyển dụng
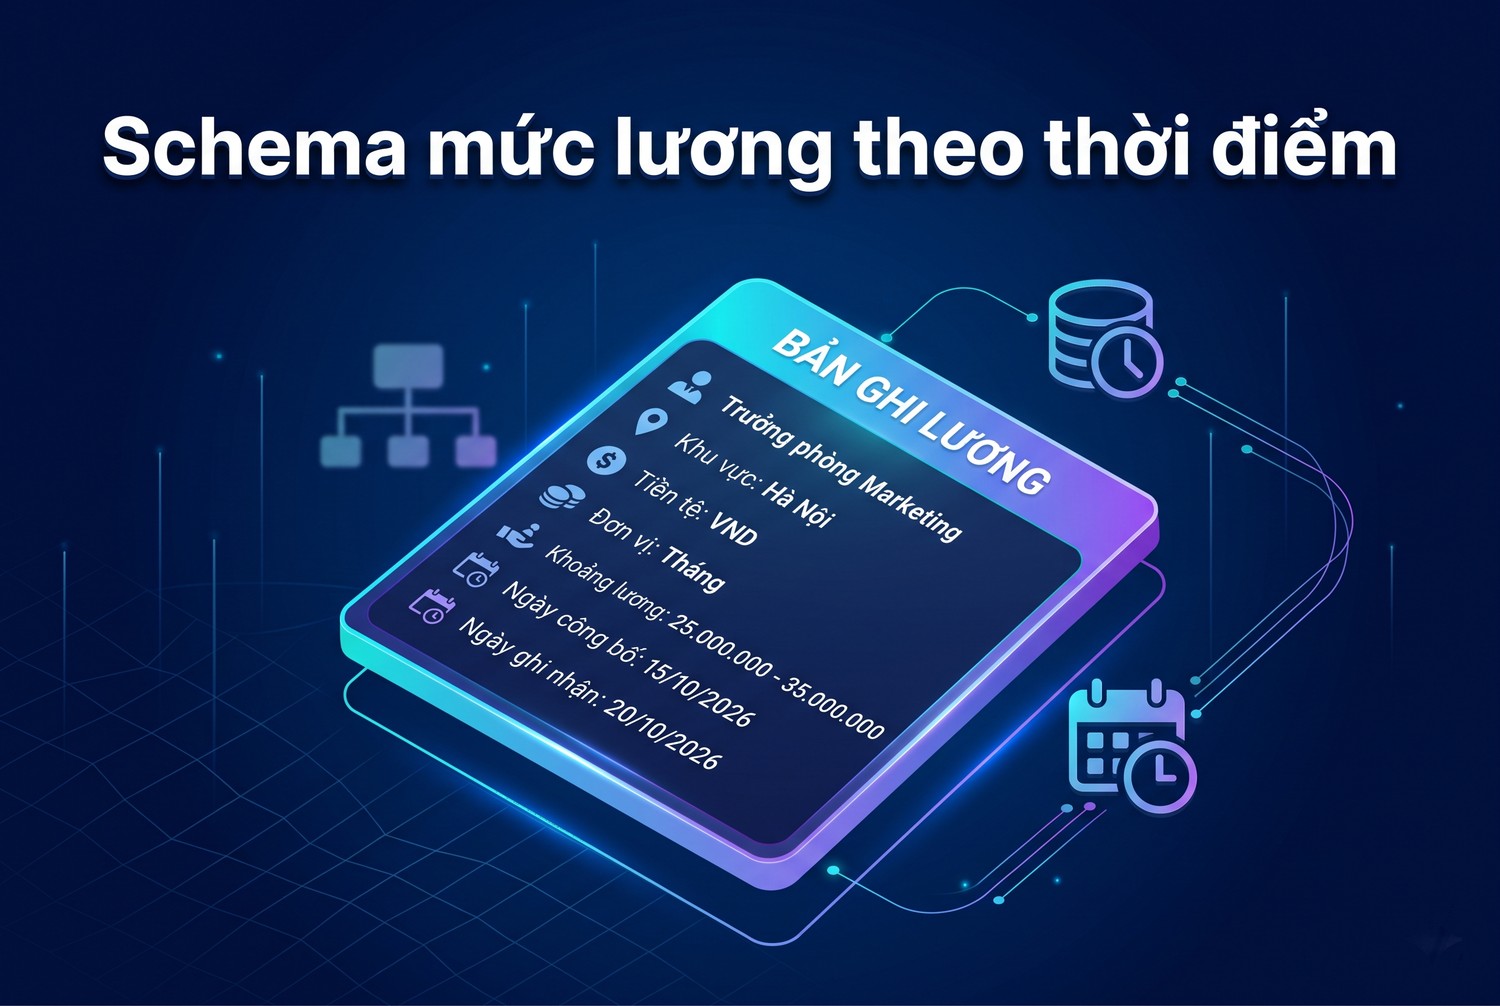
Lương chỉ có ý nghĩa khi đi kèm bối cảnh: chức danh nào, ở đâu, đơn vị gì, công bố lúc nào và ghi nhận lúc nào. Thiếu một trường, hai con số tưởng giống nhau lại không so được. Phần này đưa ra một schema đủ dùng cho dự án nhỏ, có thể mở rộng về sau.
Schema mức lương theo thời điểm
Các trường bắt buộc của một bản ghi lương
Mỗi bản ghi tương ứng một quan sát lương từ một nguồn, tại một thời điểm. Danh sách dưới đây là bộ trường tối thiểu ProxyVN đề xuất. Tên trường bằng tiếng Anh để dễ đưa vào cơ sở dữ liệu và công cụ phân tích.
- job_title_raw và job_title_norm: chức danh gốc như nguồn ghi và chức danh đã chuẩn hoá về bộ nhãn nội bộ.
- location: thành phố, bang hoặc quốc gia; ghi cả trạng thái làm từ xa nếu nguồn có nêu.
- currency và unit: mã tiền tệ ba chữ cái và đơn vị trả lương HOUR, DAY, WEEK, MONTH, YEAR.
- amount_min và amount_max: khoảng lương; nếu nguồn chỉ có một giá trị thì hai trường bằng nhau.
- source_type và source_url: loại nguồn và đường dẫn cụ thể đã xem.
- posted_date và observed_at: ngày nguồn công bố và thời điểm anh em ghi nhận.
- proxy_exit: điểm ra mạng khi ghi nhận, ví dụ VN, US hoặc direct.
Vì sao cần tách ngày công bố và ngày ghi nhận
Đây là chi tiết hay bị bỏ qua nhất. Một tin tuyển dụng đăng tháng 3 nhưng anh em ghi nhận tháng 10 thì phản ánh thị trường tháng 3, không phải tháng 10. Báo cáo thống kê công bố năm nay thường dùng dữ liệu khảo sát của kỳ trước. Nếu chỉ lưu một trường ngày, biểu đồ xu hướng sẽ lệch mà không ai nhận ra.
Trường observed_at còn giúp kiểm tra lại. Khi khách hàng hỏi vì sao con số khác với trang họ đang xem, anh em trả lời được rằng con số đã ghi nhận vào thời điểm cụ thể nào, từ điểm ra mạng nào. Mọi con số lương trong báo cáo phải lần ngược được về nguồn và về ngày ghi nhận.
Code định nghĩa schema bằng Python
Đoạn code dưới đây là ví dụ triển khai do ProxyVN viết, dùng dataclass có sẵn trong Python 3.10 trở lên. Hàm validate trả về danh sách lỗi thay vì ném ngoại lệ, để anh em lọc bản ghi lỗi ra một tệp riêng và xem lại.
from dataclasses import dataclass, asdict

UNITS = {"HOUR", "DAY", "WEEK", "MONTH", "YEAR"}
SOURCES = {"employer_jobposting", "official_statistic", "manual_glassdoor_note", "licensed_data"}
EXITS = {"VN", "US", "direct"}


@dataclass
class SalaryRecord:
    job_title_raw: str
    job_title_norm: str
    location: str
    currency: str
    unit: str
    amount_min: float | None
    amount_max: float | None
    source_type: str
    source_url: str
    posted_date: str | None   # ngày nguồn công bố, dạng YYYY-MM-DD
    observed_at: str          # thời điểm ghi nhận, ISO 8601 có múi giờ
    proxy_exit: str

    def validate(self):
        errors = []
        if self.unit not in UNITS:
            errors.append(f"unit không hợp lệ: {self.unit}")
        if self.source_type not in SOURCES:
            errors.append(f"source_type không hợp lệ: {self.source_type}")
        if self.proxy_exit not in EXITS:
            errors.append(f"proxy_exit không hợp lệ: {self.proxy_exit}")
        if len(self.currency) != 3:
            errors.append("currency phải là mã ISO 4217 ba chữ cái")
        if self.amount_min is None and self.amount_max is None:
            errors.append("thiếu giá trị lương")
        elif self.amount_min and self.amount_max and self.amount_min > self.amount_max:
            errors.append("amount_min lớn hơn amount_max")
        if not self.source_url.startswith("http"):
            errors.append("source_url thiếu hoặc sai định dạng")
        return errors

    def as_row(self):
        return asdict(self)
Tập SOURCES có sẵn giá trị manual_glassdoor_note cho ghi chú tay và licensed_data cho dữ liệu mua có giấy phép. Không có giá trị nào dành cho dữ liệu cào từ Glassdoor, và đó là chủ ý. Khi schema không có chỗ cho nguồn không hợp lệ, người nhập liệu cũng khó đưa nhầm vào.
Mẫu ghi chú tay cho phần xem Glassdoor
Ghi chú tay nên dùng cùng cấu trúc cột với bản ghi tự động. Anh em mở bảng tính, tạo đúng các cột như trên và thêm một cột tham chiếu ảnh chụp màn hình nếu cần lưu bằng chứng nội bộ. Ví dụ hai dòng dưới đây chỉ là dữ liệu minh hoạ, không phải số liệu thật.
job_title_raw,job_title_norm,location,currency,unit,amount_min,amount_max,source_type,source_url,posted_date,observed_at,proxy_exit
Data Engineer,data_engineer,"Austin, TX",USD,YEAR,0,0,manual_glassdoor_note,https://www.glassdoor.com/...,,2026-10-23T09:15:00+07:00,US
Data Engineer,data_engineer,"Ho Chi Minh City",VND,MONTH,0,0,manual_glassdoor_note,https://www.glassdoor.com/...,,2026-10-23T09:20:00+07:00,VN
Hai cột lương đang để số 0 làm chỗ trống, anh em thay bằng con số thực tế khi ghi chú. Đường dẫn rút gọn bằng dấu ba chấm trong ví dụ cũng cần thay bằng đường dẫn đầy đủ. Như vậy, schema mức lương và thời điểm là xương sống của dự án proxy Glassdoor nghiên cứu tuyển dụng: mọi nguồn đều đổ về một khuôn.
Chuẩn bị môi trường và proxy cho bộ thu thập JobPosting
Phần tự động của dự án chỉ chạy trên các trang tuyển dụng của doanh nghiệp đã qua bước kiểm tra điều khoản. Môi trường nên tách riêng để ghi lại phiên bản thư viện và cấu hình mạng. Các bước dưới đây chạy trên Windows PowerShell, máy Linux hoặc macOS chỉ khác lệnh kích hoạt môi trường ảo.
Cài thư viện và khoá phiên bản
Bộ thu thập dùng Requests để tải trang và BeautifulSoup để đọc khối JSON-LD. Module urllib.robotparser có sẵn trong thư viện chuẩn của Python nên không cần cài thêm. Sau khi cài, xuất danh sách phiên bản ra tệp để chạy lại được trên máy khác.
python -m venv .venv
.\.venv\Scripts\Activate.ps1
python -m pip install requests beautifulsoup4
python -m pip freeze > requirements-lock.txt
Tệp requirements-lock.txt là bằng chứng phiên bản khi viết phụ lục phương pháp. Nếu kết quả phân tích thay đổi sau một lần nâng cấp thư viện, anh em so tệp này để biết thư viện nào đã đổi.
Đặt thông tin proxy trong biến môi trường
Thông tin proxy không nên ghi cứng trong code. Anh em đặt địa chỉ theo dạng giao thức, máy chủ, cổng và thông tin xác thực do nhà cung cấp cấp, rồi để code đọc từ biến môi trường. Biến RESEARCH_EXIT ghi nhãn điểm ra để đưa vào trường proxy_exit của từng bản ghi.
$env:RESEARCH_PROXY = 'http://USERNAME:PASSWORD@HOST:PORT'
$env:RESEARCH_EXIT = 'US'
USERNAME, PASSWORD, HOST và PORT là giá trị mẫu. Nếu mật khẩu có ký tự đặc biệt như @ hoặc dấu hai chấm, cần mã hoá URL trước khi ghép. Khi gửi log cho đồng nghiệp, che phần thông tin đăng nhập.
Chọn loại proxy theo việc cần làm
Với việc tải trang tuyển dụng của doanh nghiệp, tốc độ thấp và lịch chạy đều quan trọng hơn số lượng IP. Một proxy datacenter hoặc dân cư tĩnh giữ IP cố định là đủ cho phần lớn dự án nhỏ. Đổi IP liên tục không giúp gì nếu mỗi website chỉ được tải vài trang mỗi ngày.
Với việc xem tay để đối chiếu khu vực, anh em cần điểm ra đúng quốc gia muốn mô tả. ProxyVN có proxy Việt Nam và datacenter US, nên phù hợp với kịch bản so sánh góc nhìn Việt Nam và Mỹ. Các thị trường khác cần nhà cung cấp có IP tại đúng quốc gia đó. Bài geo-targeting proxy là gì giải thích kỹ hơn cách định vị theo khu vực.
Tóm lại, môi trường gọn gồm hai thư viện, một tệp khoá phiên bản và hai biến môi trường. Phần này đủ để code ở phần sau chạy lại được mà không phải sửa tay.
Ví dụ tối thiểu: lấy JobPosting từ trang tuyển dụng được phép
Ví dụ trong phần này nhận đầu vào là danh sách URL trang tin tuyển dụng trên website doanh nghiệp, đã qua bước duyệt điều khoản. Code kiểm tra robots.txt, tải trang qua proxy với khoảng nghỉ, đọc khối JobPosting rồi chuyển thành bản ghi SalaryRecord. Đầu ra là tệp CSV dùng chung cấu trúc với ghi chú tay.
JobPosting trên trang tuyển dụng
Kiểm tra robots.txt qua cùng đường mạng
Tài liệu urllib.robotparser của Python cung cấp lớp RobotFileParser với phương thức can_fetch. Phương thức read của lớp này tự tải tệp bằng urllib, không đi qua Session của Requests. Để robots.txt và trang chính đi cùng một đường mạng, code dưới đây tải tệp bằng Session rồi đưa nội dung vào hàm parse.
import os
import time
import urllib.robotparser
from urllib.parse import urlsplit

import requests

UA = "salary-research-lab/0.1 (contact: hr-data@example.com)"
PROXY = os.environ.get("RESEARCH_PROXY")
_robots_cache = {}


def make_session():
    s = requests.Session()
    if PROXY:
        s.proxies.update({"http": PROXY, "https": PROXY})
    s.headers.update({"User-Agent": UA, "Accept-Language": "en-US,en;q=0.8"})
    return s


def robots_for(session, url):
    parts = urlsplit(url)
    base = f"{parts.scheme}://{parts.netloc}"
    if base in _robots_cache:
        return _robots_cache[base]
    rp = urllib.robotparser.RobotFileParser()
    r = session.get(base + "/robots.txt", timeout=(10, 20))
    if r.status_code in (401, 403):
        rp.disallow_all = True
    elif r.status_code >= 400:
        rp.allow_all = True
    else:
        rp.parse(r.text.splitlines())
    _robots_cache[base] = rp
    return rp


def polite_get(session, url, delay=5.0):
    if not robots_for(session, url).can_fetch(UA, url):
        return None, "robots_disallow"
    time.sleep(delay)
    r = session.get(url, timeout=(10, 30))
    return r, str(r.status_code)
Cách xử lý mã 401, 403 và các lỗi 4xx khác trong hàm robots_for bám theo hành vi của chính phương thức read trong thư viện chuẩn. Nếu robots.txt bị từ chối truy cập, code coi như không được tải gì trên website đó. Khoảng nghỉ mặc định 5 giây là mức thận trọng cho trang của doanh nghiệp, anh em có thể tăng thêm nếu website nhỏ.
Đọc khối JobPosting và chuyển thành bản ghi
Hàm iter_jobpostings duyệt mọi thẻ script kiểu application/ld+json, chấp nhận cả dạng đối tượng đơn, danh sách và @graph. Hàm to_record lấy các trường cần thiết, xử lý trường hợp baseSalary chỉ có một giá trị hoặc có khoảng minValue, maxValue. Đây cũng là ví dụ triển khai, mỗi website có thể đánh dấu hơi khác nên anh em cần thử trên vài trang trước.
import json
from datetime import datetime, timezone

from bs4 import BeautifulSoup


def iter_jobpostings(html):
    soup = BeautifulSoup(html, "html.parser")
    for tag in soup.find_all("script", type="application/ld+json"):
        try:
            data = json.loads(tag.string or "")
        except json.JSONDecodeError:
            continue
        items = data if isinstance(data, list) else data.get("@graph", [data])
        for item in items:
            kind = item.get("@type") if isinstance(item, dict) else None
            if kind == "JobPosting" or (isinstance(kind, list) and "JobPosting" in kind):
                yield item


def _location(job):
    loc = job.get("jobLocation") or {}
    if isinstance(loc, list):
        loc = loc[0] if loc else {}
    addr = (loc.get("address") or {}) if isinstance(loc, dict) else {}
    if isinstance(addr, str):
        return addr
    country = addr.get("addressCountry", "")
    if isinstance(country, dict):
        country = country.get("name", "")
    parts = [addr.get("addressLocality", ""), addr.get("addressRegion", ""), country]
    text = ", ".join(p for p in parts if p)
    if job.get("jobLocationType") == "TELECOMMUTE":
        text = (text + " (remote)").strip()
    return text


def to_record(job, url, proxy_exit):
    salary = job.get("baseSalary") or {}
    value = salary.get("value") if isinstance(salary, dict) else None
    if not isinstance(value, dict):
        value = {"value": value}
    low = value.get("minValue", value.get("value"))
    high = value.get("maxValue", value.get("value"))
    return SalaryRecord(
        job_title_raw=str(job.get("title", "")).strip(),
        job_title_norm="",
        location=_location(job),
        currency=str(salary.get("currency", "")).upper() if isinstance(salary, dict) else "",
        unit=str(value.get("unitText", "")).upper(),
        amount_min=float(low) if low not in (None, "") else None,
        amount_max=float(high) if high not in (None, "") else None,
        source_type="employer_jobposting",
        source_url=url,
        posted_date=(job.get("datePosted") or "")[:10] or None,
        observed_at=datetime.now(timezone.utc).isoformat(timespec="seconds"),
        proxy_exit=proxy_exit,
    )
Trường job_title_norm để trống ở bước này, vì chuẩn hoá chức danh là việc của bước phân tích. Gộp hai việc vào cùng hàm khiến lỗi khó tìm hơn. Hàm validate của SalaryRecord sẽ bắt các bản ghi thiếu đơn vị hoặc thiếu tiền tệ.
Chạy cả luồng và đầu ra mong đợi
Hàm run dưới đây đọc tệp urls.txt, gọi các hàm ở trên và ghi hai tệp: salary_ok.csv cho bản ghi hợp lệ, salary_review.csv cho bản ghi cần xem lại. Tệp log ghi trạng thái từng URL để làm báo cáo.
import csv
from dataclasses import fields


def run(url_file="urls.txt"):
    exit_label = os.environ.get("RESEARCH_EXIT", "direct")
    session = make_session()
    cols = [f.name for f in fields(SalaryRecord)] + ["errors"]
    with open(url_file, encoding="utf-8") as fh:
        urls = [u.strip() for u in fh if u.strip()]
    with open("salary_ok.csv", "w", newline="", encoding="utf-8") as ok_f, \
         open("salary_review.csv", "w", newline="", encoding="utf-8") as rv_f:
        ok_w = csv.DictWriter(ok_f, fieldnames=cols)
        rv_w = csv.DictWriter(rv_f, fieldnames=cols)
        ok_w.writeheader()
        rv_w.writeheader()
        for url in urls:
            resp, status = polite_get(session, url)
            print(status, url)
            if resp is None or resp.status_code != 200:
                continue
            for job in iter_jobpostings(resp.text):
                rec = to_record(job, resp.url, exit_label)
                errs = rec.validate()
                row = rec.as_row() | {"errors": "; ".join(errs)}
                (rv_w if errs else ok_w).writerow(row)


if __name__ == "__main__":
    run()
Khi chạy với ba URL thử, màn hình in mã trạng thái kèm đường dẫn. Đoạn dưới là dạng đầu ra mong đợi, tên miền là ví dụ, không phải kết quả đã chạy trên website thật.
200 https://careers.example.com/jobs/data-engineer-123
robots_disallow https://jobs.example.org/search?q=data
429 https://careers.example.net/jobs/analyst-77
Dòng 200 sinh ra bản ghi trong tệp CSV nếu trang có JobPosting. Dòng robots_disallow là URL bị bỏ qua đúng thiết kế. Dòng 429 là tín hiệu cần giảm tốc, phần tiếp theo sẽ nói cách xử lý. Như vậy, ví dụ tối thiểu cho proxy Glassdoor nghiên cứu tuyển dụng chỉ cần chừng một trăm dòng code nhưng đã có đủ kiểm tra quyền, khoảng nghỉ và kiểm tra dữ liệu.
Xử lý lỗi, giới hạn request và kiểm tra dữ liệu lương
Lỗi trong dự án này rơi vào hai nhóm: lỗi khi tải trang và lỗi nằm trong chính dữ liệu lương. Nhóm thứ hai nguy hiểm hơn vì code vẫn chạy bình thường nhưng con số trong báo cáo sai. Phần này đi qua cả hai nhóm, kèm cách phát hiện sớm.
Lỗi mạng và mã trạng thái
Phần proxy trong tài liệu Requests hướng dẫn truyền proxy qua tham số proxies hoặc qua Session như trong code mẫu. Khi gặp ProxyError hoặc ConnectTimeout, request chưa tới được website, anh em kiểm tra lại máy chủ, cổng và thông tin xác thực. Bài cài đặt proxy Python từ thư viện Requests trên blog ProxyVN có các bước kiểm tra kết nối chi tiết.
Mã 403 và 429 nghĩa là request đã tới website nhưng bị từ chối hoặc bị giới hạn. Với 429, đọc header Retry-After nếu có và đợi đúng thời gian đó. Với 403, dừng website đó lại và xem lại điều khoản, đừng đổi IP để thử tiếp.
- ProxyError 407: thiếu hoặc sai thông tin xác thực proxy.
- ConnectTimeout: proxy không phản hồi, kiểm tra cổng và trạng thái dịch vụ.
- 403: website từ chối, dừng và xem lại quyền truy cập.
- 429: giảm tốc, tăng delay, tôn trọng Retry-After.
- 200 nhưng không có JobPosting: trang dựng bằng JavaScript hoặc không đánh dấu dữ liệu.
Giới hạn tốc độ theo từng website
Code mẫu đặt khoảng nghỉ chung cho mọi request. Khi danh sách có nhiều website, anh em nên giới hạn theo từng tên miền, ví dụ tối đa vài chục trang mỗi ngày cho một website nhỏ. Cách đơn giản là nhóm URL theo tên miền và chạy lần lượt từng nhóm, thay vì xen kẽ ngẫu nhiên.
Một lưu ý quan trọng là không dùng nhiều IP để chia nhỏ lưu lượng lên cùng một website nhằm vượt giới hạn tốc độ. Nếu website đã trả 429, nó đang nói rõ mức chịu tải. Bài lỗi 429 khi dùng proxy giải thích kỹ hơn về mã lỗi này và cách điều chỉnh nhịp gửi.
Dữ liệu lương đúng nguồn, đúng ngày và đúng đơn vị có giá trị hơn gấp nhiều lần một bảng lớn mà không ai trả lời được con số đến từ đâu.
Kiểm tra dữ liệu lương trước khi phân tích
Lỗi dữ liệu phổ biến nhất là đơn vị sai. Một tin ghi 45 với đơn vị YEAR gần như là lương theo giờ bị đánh dấu nhầm. Một tin ghi 120.000 với đơn vị MONTH bằng USD cũng đáng nghi. Anh em nên đặt ngưỡng hợp lý theo từng tiền tệ và đơn vị, bản ghi nằm ngoài ngưỡng thì chuyển sang tệp xem lại.
Lỗi thứ hai là trùng lặp. Cùng một tin có thể xuất hiện ở nhiều URL do tham số theo dõi hoặc do được đăng lại. Khoá trùng nên gồm tên miền, chức danh gốc, địa điểm, khoảng lương và ngày đăng. Lỗi thứ ba là tiền tệ trống, thường do website quên khai báo; không tự đoán tiền tệ theo quốc gia của IP.
Quy đổi về một đơn vị để so sánh
Để so sánh, anh em quy đổi về lương năm hoặc lương tháng theo một quy ước ghi rõ trong báo cáo. Code dưới đây quy đổi về năm với giả định 40 giờ mỗi tuần, 52 tuần mỗi năm. Giả định này là ví dụ, mỗi thị trường có số giờ làm việc chuẩn khác nhau.
FACTOR_TO_YEAR = {"HOUR": 2080, "DAY": 260, "WEEK": 52, "MONTH": 12, "YEAR": 1}


def annual_midpoint(rec):
    low = rec.amount_min if rec.amount_min is not None else rec.amount_max
    high = rec.amount_max if rec.amount_max is not None else rec.amount_min
    if low is None or rec.unit not in FACTOR_TO_YEAR:
        return None
    return (low + high) / 2 * FACTOR_TO_YEAR[rec.unit]
Không quy đổi chéo giữa các tiền tệ ở bước này. Nếu cần so sánh lương USD với VND, dùng tỷ giá của một ngày cố định và ghi ngày đó vào báo cáo. Nhìn chung, kiểm tra dữ liệu là bước biến bảng thô của dự án proxy Glassdoor nghiên cứu tuyển dụng thành số liệu đủ tin để đưa cho người ra quyết định.
Đối chiếu khu vực bằng proxy Glassdoor nghiên cứu tuyển dụng
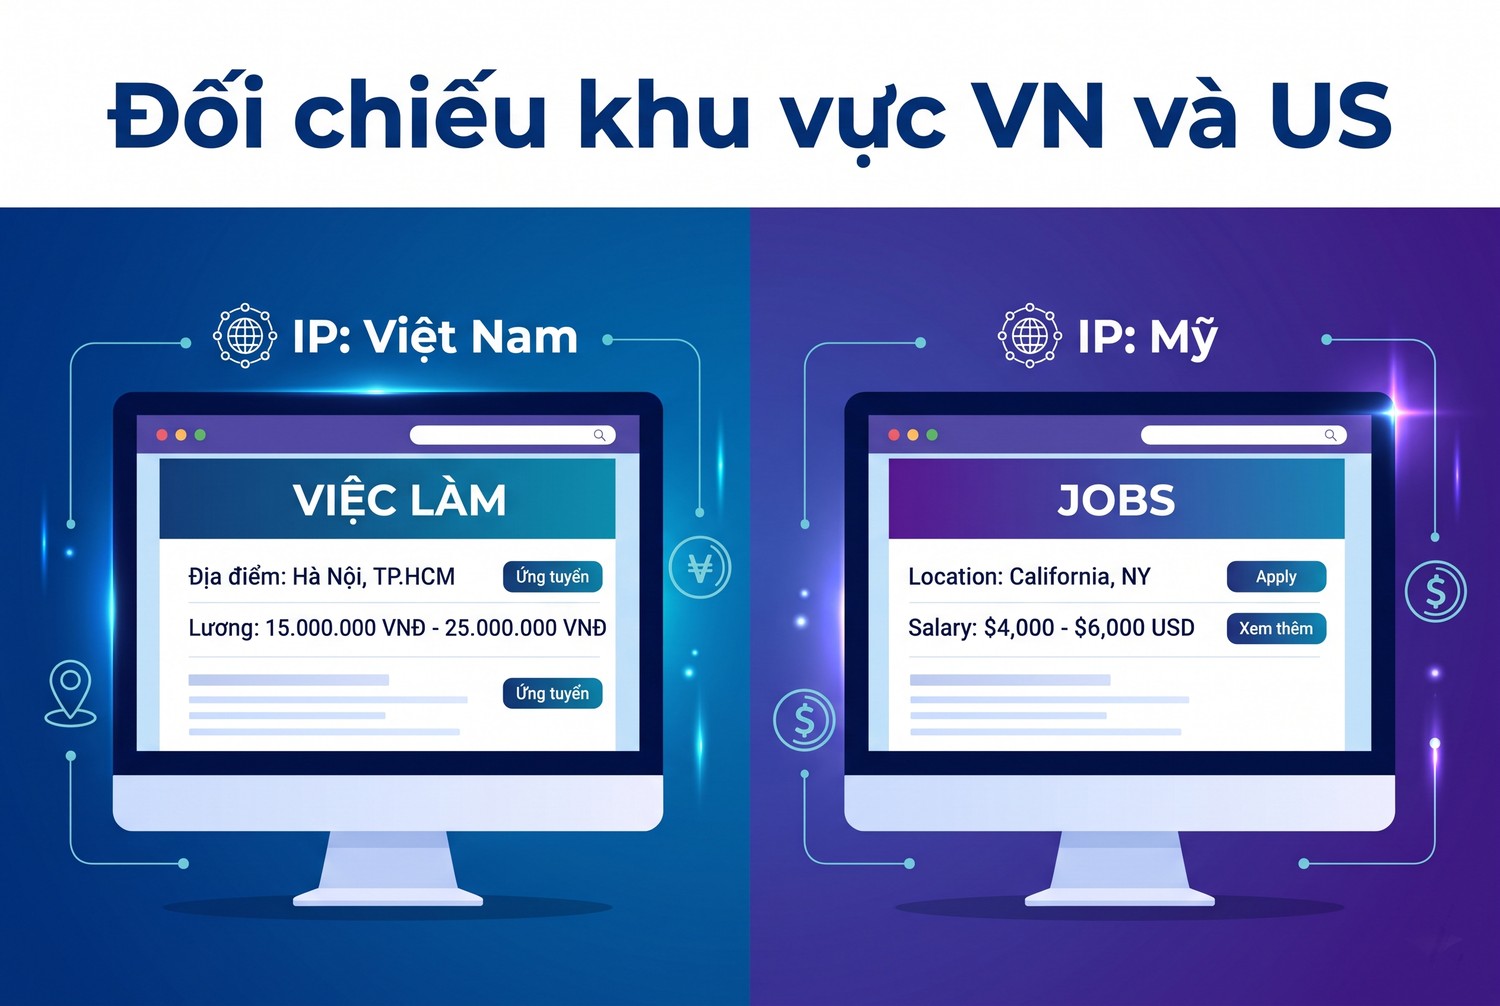
Phần này quay lại Glassdoor, nhưng ở chế độ xem tay. Mục tiêu là mô tả đúng những gì người dùng ở một quốc gia nhìn thấy khi tìm cùng một chức danh, chứ không phải thu thập dữ liệu. Proxy giúp anh em đặt mình vào vị trí người xem đó.
Đối chiếu khu vực VN và US
Thiết lập trình duyệt riêng cho việc đối chiếu
Anh em nên dùng một hồ sơ trình duyệt riêng cho việc nghiên cứu, gắn proxy ở cấp hồ sơ hoặc qua tiện ích quản lý proxy. Cách này tách cookie, lịch sử và tài khoản cá nhân khỏi phiên nghiên cứu. Nếu dùng chung trình duyệt cá nhân, gợi ý trên trang có thể bị ảnh hưởng bởi lịch sử tìm kiếm cũ.
Trước mỗi phiên, kiểm tra IP hiển thị và quốc gia bằng một trang kiểm tra IP. Ngôn ngữ trình duyệt cũng nên khớp với kịch bản, ví dụ tiếng Anh Mỹ khi mô tả góc nhìn ứng viên ở Mỹ. Ghi lại cả hai thông số vào cột proxy_exit và ghi chú phiên.
Những gì nên ghi lại khi so sánh
Khi mở cùng một trang từ điểm ra Việt Nam và điểm ra Mỹ, anh em quan sát vài điểm khác biệt có thể xuất hiện. Không phải lúc nào cũng có khác biệt, và việc ghi lại "không khác" cũng là kết quả có giá trị.
- Tên miền hoặc phiên bản quốc gia mà trang tự chuyển tới.
- Đơn vị tiền tệ hiển thị cho khoảng lương tổng hợp.
- Địa điểm được gợi ý sẵn trong ô tìm kiếm.
- Các phần nội dung yêu cầu đăng nhập hoặc đóng góp trước khi xem tiếp.
- Thời điểm xem, vì nội dung tổng hợp có thể được cập nhật.
Giữ mọi thứ ở mức đọc và ghi chú
Trong lúc đối chiếu, anh em chỉ đọc và ghi chú số liệu tổng hợp. Không dùng tiện ích tự động cuộn, tự bấm hay tự lưu trang hàng loạt, vì đó vẫn là công cụ tự động theo nghĩa của điều khoản. Không sao chép nguyên văn đánh giá của người lao động vào báo cáo; nếu cần dẫn ý, tóm tắt bằng lời của mình và ghi nguồn.
Khi trang yêu cầu đăng nhập hoặc đóng góp, anh em quyết định có tạo tài khoản thật để dùng theo đúng điều khoản hay không. Đó là lựa chọn của người dùng, không phải thứ proxy xử lý hộ. Tóm lại, đối chiếu khu vực bằng proxy Glassdoor nghiên cứu tuyển dụng là việc của người đọc cẩn thận, không phải việc của bot.
Checklist trước khi chạy proxy Glassdoor nghiên cứu tuyển dụng
Trước khi chuyển từ lab sang chạy định kỳ, anh em rà lại toàn bộ dự án theo danh sách dưới đây. Mỗi mục gắn với một rủi ro đã nói ở các phần trên. Thiếu mục nào, dự án có thể chạy được nhưng số liệu khó bảo vệ trước khách hàng.
Checklist về quyền dữ liệu
Nhóm mục đầu tiên liên quan tới quyền sử dụng nguồn. Đây là nhóm cần người có trách nhiệm ký duyệt, không chỉ là việc của người viết code.
- Đã đọc điều khoản sử dụng của từng nguồn và lưu ngày đọc.
- Glassdoor chỉ xuất hiện dưới dạng ghi chú tay hoặc dữ liệu có thoả thuận.
- Danh sách URL tự động chỉ gồm trang tuyển dụng đã duyệt, đã kiểm tra robots.txt.
- Không lưu thông tin cá nhân của người đăng đánh giá hay nhà tuyển dụng.
- Báo cáo ghi rõ loại nguồn cho từng con số.
Checklist kỹ thuật
Nhóm thứ hai liên quan tới cấu hình và vận hành. Đây là nhóm người viết code tự kiểm tra trước mỗi đợt chạy.
- Proxy đặt trong biến môi trường, log đã che thông tin xác thực.
- Có khoảng nghỉ và giới hạn số trang theo từng website.
- Dừng website khi gặp 403, tôn trọng Retry-After khi gặp 429.
- Có tệp khoá phiên bản thư viện.
- Bản ghi lỗi đi vào tệp xem lại, không bị xoá âm thầm.
Chọn gói proxy cho dự án
Dự án nghiên cứu tuyển dụng thường không cần nhiều IP. Một vài IP cố định cho từng điểm ra là đủ, ưu tiên độ ổn định để các lần đối chiếu cách nhau vài tuần vẫn xuất phát từ cùng bối cảnh mạng. Khi cần mua proxy Việt Nam hoặc datacenter US cho kịch bản so sánh, anh em xem các gói đang hiển thị trên trang chủ ProxyVN và thử với vài trang tuyển dụng trước khi chạy cả danh sách.
ProxyVN hỗ trợ cả HTTP và SOCKS5 có xác thực user/pass, nên cấu hình được trong cả trình duyệt lẫn code Python như ví dụ. ProxyVN chưa thử riêng với từng website tuyển dụng nêu trong bài, vì vậy bước thử nhỏ là cần thiết. Như vậy, checklist cho proxy Glassdoor nghiên cứu tuyển dụng đặt quyền dữ liệu lên trước, kỹ thuật đi sau.
Câu hỏi thường gặp về proxy Glassdoor nghiên cứu tuyển dụng
Phần này gom vài thắc mắc hay gặp khi anh em bắt đầu dự án nghiên cứu lương. Câu trả lời ngắn, chi tiết đã nằm trong các phần trên.
Dùng proxy có xem được nội dung Glassdoor cần đăng nhập không
Không. Phần nội dung yêu cầu đăng nhập hoặc đóng góp phụ thuộc vào tài khoản, không phụ thuộc IP. Đổi IP chỉ đổi điểm xuất phát của kết nối. Muốn xem phần đó, anh em dùng tài khoản thật theo đúng điều khoản của Glassdoor.
Có thể tự viết bot lấy lương từ Glassdoor nếu chạy chậm không
Điều khoản sử dụng Glassdoor ngày 23/10/2026 cấm đưa tác nhân tự động vào dịch vụ để cào hoặc khai thác dữ liệu khi chưa có văn bản cho phép. Chạy chậm hay chạy nhanh không thay đổi điều đó. Nếu cần dữ liệu ở quy mô lớn, anh em liên hệ Glassdoor hoặc đơn vị có giấy phép phân phối.
Nên lưu lương theo tháng hay theo năm
Lưu đúng đơn vị nguồn công bố trong trường unit, rồi quy đổi ở bước phân tích. Nếu quy đổi ngay khi lưu, anh em mất thông tin gốc và khó sửa khi phát hiện giả định sai. Báo cáo cuối cùng chọn một đơn vị thống nhất và ghi rõ hệ số quy đổi.
Dữ liệu tin tuyển dụng có đại diện cho mặt bằng lương không
Chưa hẳn. Tin tuyển dụng là mức doanh nghiệp đề nghị, thường thiên về các vị trí đang thiếu người. Thống kê chính thức đo lương thực trả nhưng chậm hơn. Ghép hai nguồn và đối chiếu thêm ghi chú tay cho bức tranh cân bằng hơn mỗi nguồn riêng lẻ.
Làm proxy Glassdoor nghiên cứu tuyển dụng nghĩa là xem tay phần công khai, tự động hoá trên nguồn được phép và lưu mọi con số kèm nguồn, ngày ghi nhận. Hãy bắt đầu với vài chức danh đã duyệt. Cần tư vấn điểm ra mạng, anh em nhắn Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam trước khi mở rộng proxy Glassdoor nghiên cứu tuyển dụng.


