
Giám sát proxy bằng Prometheus và Grafana theo lỗi
Giám sát proxy bằng Prometheus và Grafana cần phân biệt proxy lỗi, website đích lỗi và hệ thống đo ngừng cập nhật. Nếu chỉ nhìn một biểu đồ độ trễ, anh em có thể bỏ sót kết nối thất bại hoặc dữ liệu cũ. ProxyVN hướng dẫn thiết kế metric, exporter Python, truy vấn và cảnh báo theo phạm vi đo rõ ràng trước khi đưa vào trực vận hành.
Giám sát proxy bằng Prometheus và Grafana theo ba lớp
Một hệ thống đo gồm probe tạo yêu cầu thử, exporter công bố kết quả và Prometheus thu thập chuỗi thời gian. Grafana đọc dữ liệu từ Prometheus để hiển thị. Bốn trách nhiệm này cần được tách về mặt tư duy, dù ban đầu có thể chạy trên cùng máy. Khi biểu đồ mất dữ liệu, người trực phải biết kiểm tra exporter, lịch probe hay kết nối tới website đích thay vì gọi mọi hiện tượng là proxy chết.
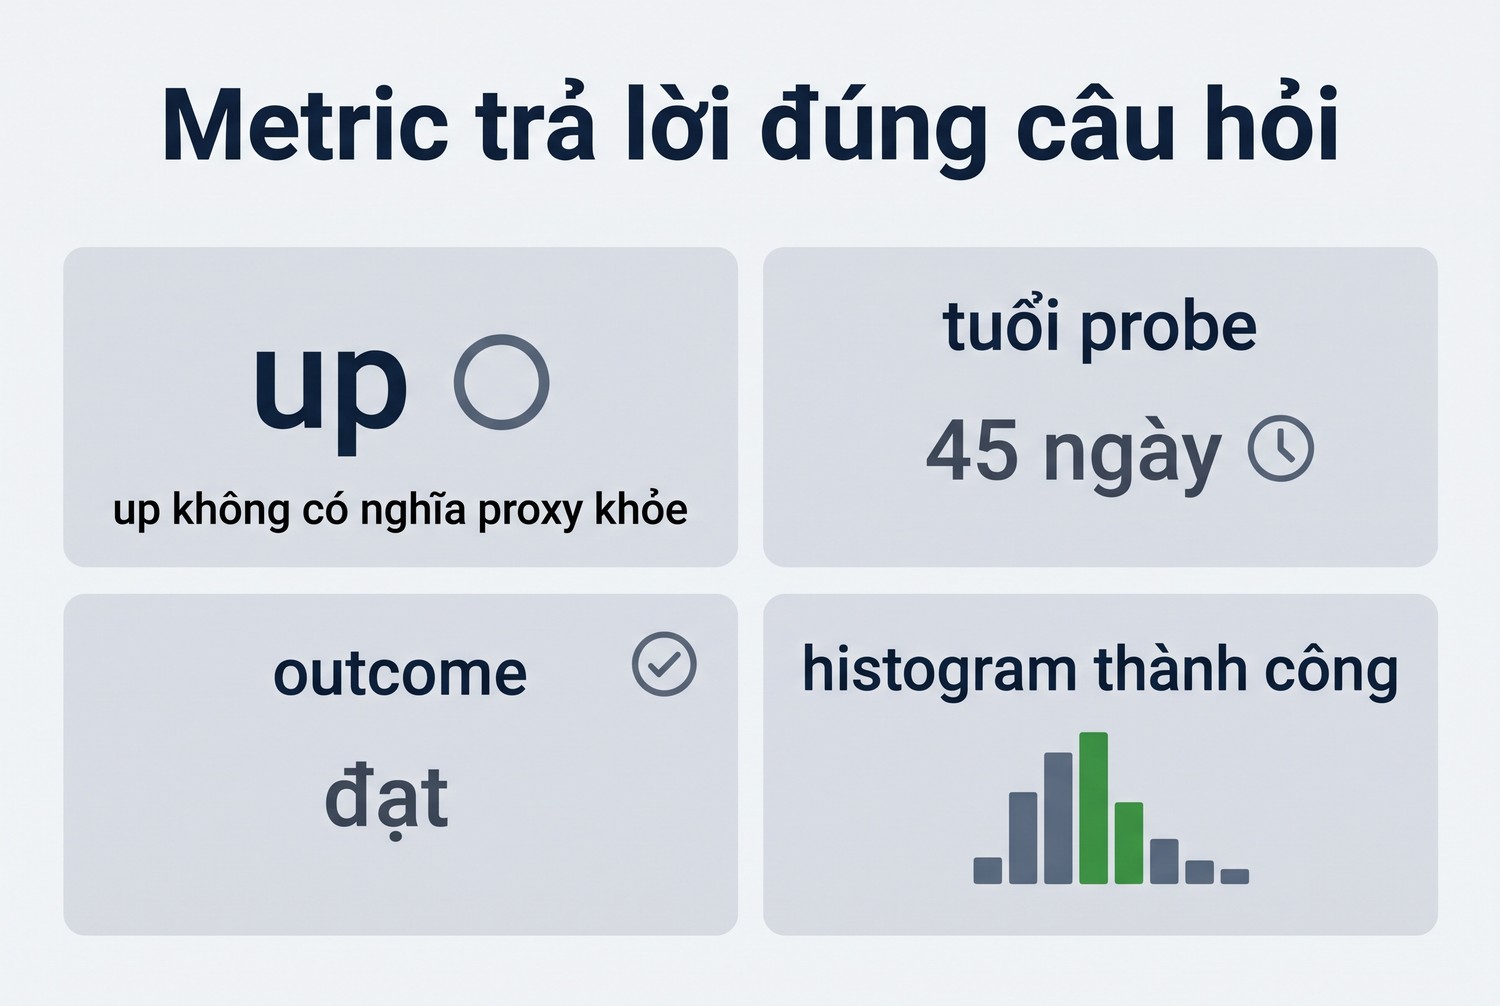
Chỉ số up do Prometheus tạo cho biết scrape target có được thu thập thành công hay không. Nếu exporter trả metric bình thường nhưng mọi yêu cầu qua proxy thất bại, up vẫn có thể bằng một. Ngược lại, exporter bị tắt có thể khiến up bằng không trong khi proxy ngoài vẫn hoạt động. Đặt hai chỉ số cạnh nhau giúp tránh dùng sức khỏe hệ thống đo thay cho sức khỏe đường kết nối được đo.
Định nghĩa một lần thử đạt trước khi vẽ
Trong ví dụ, một probe đạt khi nhận HTTP 200 và đúng marker từ endpoint thử do đội mình kiểm soát. Tiêu chí này khác với cổng TCP mở hoặc bất kỳ phản hồi HTTP nào. Một trang chặn truy cập có mã 200 nhưng nội dung sai không được xem là đạt. Nếu hệ thống cần kiểm tra thao tác nghiệp vụ cụ thể, bổ sung tiêu chí riêng và ghi rõ nó không còn chỉ đo khả năng kết nối cơ bản.
Endpoint thử nên có nội dung ngắn, ổn định và được phép dùng với tần suất dự kiến. Không dùng trang chủ của bên thứ ba làm target lâu dài chỉ vì hôm nay truy cập được. Nội dung thay đổi, chuyển hướng hay giới hạn truy cập có thể tạo báo động giả. Khi cần kiểm tra nhiều vùng, giữ cùng logic phản hồi để kết quả khác biệt phản ánh đường mạng thay vì ứng dụng thử ở mỗi vùng có hành vi khác nhau.
Một probe không đại diện mọi website. Proxy có thể đi tới endpoint kiểm tra nhưng bị chính sách của website công việc từ chối. Để quản lý điều này, tách kiểm tra kết nối nền khỏi kiểm tra ứng dụng quan trọng. Đặt nhãn target_group có số giá trị được quản lý nếu cần nhiều nhóm đích; không đưa URL đầy đủ, query hay tên tài khoản thành nhãn metric vì chúng làm tăng số chuỗi và có thể lộ dữ liệu.
Giám sát proxy bằng Prometheus và Grafana với metric rõ nghĩa
Quy ước đặt tên Prometheus khuyến khích tên phản ánh đại lượng và dùng đơn vị cơ sở. Vì vậy, thời gian trong ví dụ được ghi bằng giây, không trộn mili giây và giây trong cùng metric. Counter có hậu tố total, thời điểm có timestamp_seconds và độ dài khoảng thời gian có duration_seconds. Quy ước nhất quán giúp câu truy vấn dễ đọc khi người trực phải xử lý nhiều dashboard cùng lúc.
Nhóm metric tối thiểu gồm tổng probe theo kết quả, thời điểm probe hoàn tất gần nhất, trạng thái thành công của probe gần nhất và histogram độ trễ của lần thành công. Histogram chỉ ghi những lần đạt tiêu chí, nên cần được đọc cạnh tỷ lệ lỗi. Nếu nhiều yêu cầu timeout, phân vị của những lần thành công còn lại có thể vẫn thấp. Một biểu đồ đẹp không có nghĩa toàn bộ công việc đang hoàn thành tốt.
Metric đề xuất |
Loại |
Câu hỏi trả lời |
|---|---|---|
proxy_probe_total |
Counter |
Có bao nhiêu probe theo từng kết quả |
proxy_probe_success |
Gauge |
Probe gần nhất đạt hay thất bại |
proxy_last_probe_timestamp_seconds |
Gauge |
Bộ đo còn chạy gần đây hay không |
proxy_probe_duration_seconds |
Histogram |
Lần thành công mất bao lâu |
Giới hạn nhãn từ lúc thiết kế
Ví dụ dùng nhãn pool và endpoint là mã nội bộ được quản trị. Không dùng địa chỉ kèm username/password làm endpoint. Khi một endpoint thay password, mã của nó vẫn giữ ổn định nên lịch sử không bị tách thành chuỗi mới. Nếu thay tài nguyên có ý nghĩa khác, cập nhật inventory cùng lịch sử thay đổi thay vì tái sử dụng mã cũ mà không ghi nhận, vì người đọc có thể hiểu sai xu hướng trước sau.
Nhãn outcome cần một tập giá trị hữu hạn như success, proxy_auth, target_http hoặc proxy_transport. Không đưa nguyên thông báo exception làm outcome, vì mỗi địa chỉ hay lần timeout có thể tạo một chuỗi mới. Chi tiết cần thiết thuộc log đã loại bí mật, còn metric phục vụ tổng hợp. Tách hai kênh giúp vừa nhìn xu hướng vừa có thể truy nguyên một ca lỗi mà không làm kho chuỗi thời gian phình theo dữ liệu đầu vào.
Khi pool rất lớn, cân nhắc dashboard tổng hợp theo nhóm trước rồi mới mở chi tiết endpoint. Mỗi endpoint kết hợp nhiều outcome và histogram bucket sẽ tạo nhiều chuỗi. Dự tính số tổ hợp trước khi bật giám sát toàn bộ inventory. Không cần một con số giới hạn chung cho mọi tổ chức; cần hiểu chi phí lưu, tần suất scrape và nhu cầu điều tra thực tế của đội vận hành đang sử dụng hệ thống.
Metric trả lời đúng câu hỏi
Giám sát proxy bằng Prometheus và Grafana qua exporter Python
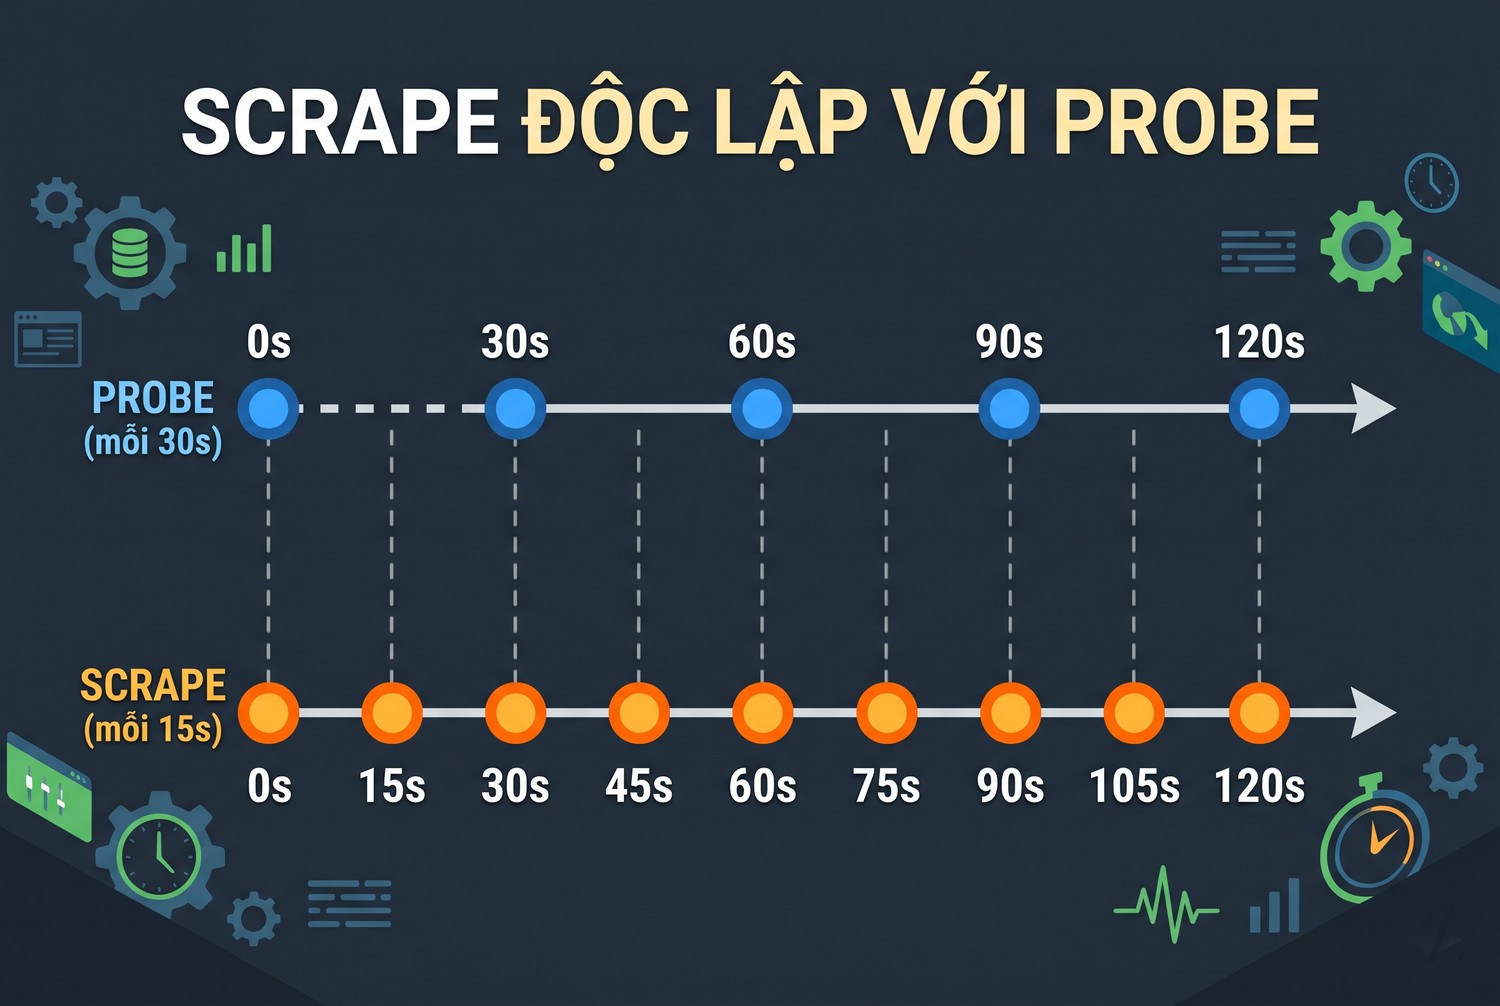
Thư viện client Python của Prometheus cung cấp counter, gauge, histogram và endpoint công bố metric. Ví dụ dưới đây tự viết cho một endpoint proxy được cấp. Probe chạy độc lập với scrape: mỗi lần Prometheus đọc metric không tạo thêm yêu cầu tới target. Cách tổ chức này quan trọng khi nhiều hệ thống cùng đọc exporter hoặc khi người dùng làm mới dashboard liên tục trong lúc điều tra sự cố.
Tạo exporter.py, cài requests cùng prometheus-client vào môi trường ảo của dự án. Biến TARGET_URL phải trỏ tới endpoint thử được quản lý; PROXY_URL chứa cấu hình proxy theo giao thức đã xác nhận. Mã không in hai giá trị đó. Ví dụ dùng một cặp pool và endpoint cố định để minh họa, không tự tải một danh sách đầu vào không tin cậy rồi tạo hàng nghìn nhãn trong một lần chạy.
import os
import time
import requests
from prometheus_client import Counter, Gauge, Histogram, start_http_server

LABELS = ['pool', 'endpoint']
TOTAL = Counter('proxy_probe_total', 'Completed probes', LABELS + ['outcome'])
SUCCESS = Gauge('proxy_probe_success', 'Last probe success', LABELS)
LAST = Gauge('proxy_last_probe_timestamp_seconds', 'Last completed probe', LABELS)
DURATION = Histogram('proxy_probe_duration_seconds',
                     'Successful probe duration', LABELS,
                     buckets=(0.1, 0.3, 0.5, 1, 2, 5, 10))

OUTCOMES = ('success', 'proxy_auth', 'target_http', 'content_mismatch',
            'proxy_transport', 'connect_timeout', 'read_timeout',
            'tls_error', 'other_error')

def initialize_outcomes(pool='qa', endpoint='a01'):
    for outcome in OUTCOMES:
        TOTAL.labels(pool, endpoint, outcome).inc(0)

def probe(session, target, proxy, pool='qa', endpoint='a01'):
    started = time.monotonic()
    outcome = 'other_error'
    try:
        with session.get(target, proxies={'http': proxy, 'https': proxy},
                         timeout=(3, 8), allow_redirects=False) as response:
            if response.status_code == 407:
                outcome = 'proxy_auth'
            elif response.status_code != 200:
                outcome = 'target_http'
            elif response.text.strip() != 'proxy-probe-ok':
                outcome = 'content_mismatch'
            else:
                outcome = 'success'
    except requests.exceptions.ProxyError:
        outcome = 'proxy_transport'
    except requests.exceptions.ConnectTimeout:
        outcome = 'connect_timeout'
    except requests.exceptions.ReadTimeout:
        outcome = 'read_timeout'
    except requests.exceptions.SSLError:
        outcome = 'tls_error'
    except requests.exceptions.RequestException:
        outcome = 'other_error'
    TOTAL.labels(pool, endpoint, outcome).inc()
    SUCCESS.labels(pool, endpoint).set(outcome == 'success')
    LAST.labels(pool, endpoint).set(time.time())
    if outcome == 'success':
        DURATION.labels(pool, endpoint).observe(time.monotonic() - started)
    return outcome

if __name__ == '__main__':
    initialize_outcomes()
    session = requests.Session()
    session.trust_env = False
    start_http_server(9109, addr='127.0.0.1')
    while True:
        probe(session, os.environ['TARGET_URL'], os.environ['PROXY_URL'])
        time.sleep(30)
Các timeout và bucket trong mã là cấu hình minh họa, chưa được hiệu chỉnh từ số liệu của một dịch vụ cụ thể. timeout của requests không phải ngân sách tổng cho mọi tình huống đọc nội dung. Target cần phản hồi ngắn và có giới hạn tài nguyên phù hợp; hệ thống thật nên có thêm giới hạn thời gian tổng của một probe. Không dùng ví dụ này làm cơ sở khẳng định mọi yêu cầu sẽ kết thúc trong một số giây cố định.
Đọc đúng nhóm lỗi xác thực
Khi client nhận trực tiếp HTTP 407, ví dụ phân loại proxy_auth. Với HTTPS qua CONNECT, lỗi xác thực có thể xuất hiện dưới dạng ProxyError của thư viện thay vì response 407. Mã khi đó ghi proxy_transport và không đoán bằng cách tìm chuỗi trong thông báo exception. Nếu cần phân biệt sâu hơn, dùng client hoặc cơ chế quan sát có thông tin có cấu trúc, rồi kiểm tra với endpoint thử hỗ trợ tình huống đó.
session.trust_env=False làm phép thử không vô tình dùng biến proxy hoặc cấu hình môi trường khác của máy exporter. Điều này giúp đầu vào của ca thử rõ hơn, nhưng cũng cần xem môi trường có yêu cầu CA hoặc thiết lập bắt buộc nào không. Giữ xác minh TLS; không thêm verify=False để đổi một lỗi chứng chỉ thành thành công. Khi có CA nội bộ được phê duyệt, cấu hình theo quy trình quản trị của hệ thống.
Khởi tạo nhóm kết quả mà không tạo probe giả
Counter cho một outcome chưa từng xuất hiện có thể chưa có chuỗi tương ứng. Nếu mọi probe đều thành công, tử số lọc các lỗi có thể vắng thay vì bằng không. Hàm initialize_outcomes trong mã mẫu tạo tập nhãn hữu hạn với giá trị ban đầu bằng không, giúp biểu thức tỷ lệ có dữ liệu lỗi nền khi các chuỗi đã được scrape đủ mẫu. Không cộng một probe giả để lấp chỗ trống này.
Khi thêm endpoint, khởi tạo các outcome cho đúng cặp pool và endpoint trước vòng thử của nó. Mã minh họa chỉ có qa và a01, nên chưa phải cơ chế discovery inventory. SUCCESS và LAST vẫn phản ánh probe đã hoàn tất; không tự gán thời điểm hiện tại lúc khởi tạo để làm dữ liệu trông mới. Một exporter đã chạy nhưng chưa thử endpoint cần được phân biệt với endpoint vừa có kết quả tốt.
Một cửa sổ không có probe mới vẫn có mẫu số bằng không dù các nhãn đã được tạo. Khi cảnh báo theo tỷ lệ, kết hợp số quan sát tối thiểu ở cùng nhóm và cửa sổ. Biểu thức dưới là một mẫu kiểm tra điều kiện có ít nhất mười probe trong năm phút; con số cần được chọn lại theo nhịp đo thật, không phải tiêu chuẩn đánh giá chất lượng dịch vụ.
sum by (pool) (increase(proxy_probe_total[5m])) >= 10Giám sát proxy bằng Prometheus và Grafana qua scrape độc lập
Hướng dẫn viết exporter là cơ sở để xem xét cách công bố dữ liệu và lỗi thu thập. Với ví dụ local, Prometheus có thể đọc cổng 9109 trong cùng máy. Nếu chạy trong container, localhost là chính container đó, không phải máy host hay container khác. Cần dùng tên dịch vụ hoặc địa chỉ phù hợp với mạng triển khai, đồng thời giới hạn quyền truy cập cổng metric theo nhu cầu vận hành.
Đặt cấu hình scrape bên dưới trong prometheus.yml rồi dùng công cụ kiểm tra cấu hình của bản Prometheus đang triển khai trước khi reload. Tần suất mười lăm giây chỉ là lựa chọn cho mô hình thử. Vì probe có khoảng nghỉ ba mươi giây sau khi hoàn tất, hai lần scrape liên tiếp có thể đọc cùng một kết quả. Đây là hành vi bình thường của gauge, không phải hai probe độc lập cần cộng thêm vào bộ đếm.
scrape_configs:
  - job_name: proxy-probe
    scrape_interval: 15s
    scrape_timeout: 5s
    static_configs:
      - targets: ['127.0.0.1:9109']
Phân biệt dữ liệu cũ với endpoint lỗi
Một exporter có thể tiếp tục trả metric trong khi vòng probe bị treo. Khi đó up còn bằng một nhưng thời điểm probe cuối không đổi. Anh em cần thêm panel tuổi dữ liệu bằng time() trừ proxy_last_probe_timestamp_seconds. Gauge success gần nhất chỉ nên được diễn giải khi tuổi dữ liệu còn phù hợp chu kỳ. Nếu bỏ qua thời gian, kết quả tốt cũ có thể được hiển thị như một kết nối đang hoạt động.
Trong ví dụ, gauge kết quả và thời điểm probe chưa có mẫu cho endpoint trước lần thử đầu tiên. Counter outcome đã được khởi tạo bằng không. Nếu muốn phân biệt inventory chưa kiểm tra với inventory không tồn tại, công bố thêm một metric inventory có số lượng giá trị được quản lý. Không điền số không cho mọi giá trị thiếu rồi coi đó là thất bại. Dữ liệu không có, exporter không được scrape và probe thất bại là ba trạng thái cần những bước xử lý khác nhau.
Khi exporter khởi động lại, counter quay về trạng thái ban đầu của tiến trình. Truy vấn rate phù hợp cho counter cần xử lý sự giảm do reset theo ngữ nghĩa Prometheus. Đừng lấy giá trị counter ở hai thời điểm bằng phép trừ thủ công rồi gọi đó là số probe mới nếu chưa xét reset. Số phiên bản exporter và thời điểm triển khai nên có trong nhật ký thay đổi để người trực hiểu biến động bất thường.
Scrape độc lập với probe
Giám sát proxy bằng Prometheus và Grafana với truy vấn đúng mẫu số
Các hàm truy vấn Prometheus hỗ trợ rate, increase và histogram_quantile cho những mục đích khác nhau. Với tỷ lệ lỗi, cần tổng tốc độ probe thất bại chia tổng tốc độ mọi probe cùng phạm vi nhãn và cửa sổ. Nếu tử số nhóm theo endpoint mà mẫu số nhóm theo pool, kết quả có thể mất chuỗi hoặc sai ý nghĩa. Viết rõ nhóm nhãn trước khi thêm panel sẽ giảm lỗi này.
Truy vấn dưới tính tỷ lệ probe lỗi theo pool trên cửa sổ năm phút. Khi chưa có probe mới, mẫu số bằng không và kết quả không phải một tỷ lệ thành công có ý nghĩa. Giao diện nên hiển thị không có quan sát thay vì tự biến thành không phần trăm lỗi. Trong cảnh báo, kết hợp điều kiện số probe tối thiểu để tránh đánh giá từ quá ít dữ liệu.
sum by (pool) (rate(proxy_probe_total{outcome!="success"}[5m]))
/
sum by (pool) (rate(proxy_probe_total[5m]))
Độ trễ phân vị chín mươi lăm của lần thành công có thể tính bằng histogram bucket. Nó mô tả phân bố của các probe đã đạt tiêu chí, không bao gồm timeout và phản hồi sai nội dung. Đặt tên panel là độ trễ probe thành công để người xem không hiểu nhầm. Nếu muốn tổng hợp theo pool, giữ nhãn le trong phép sum vì histogram_quantile cần các bucket cùng ranh giới để tính.
histogram_quantile(0.95,
  sum by (pool, le) (rate(proxy_probe_duration_seconds_bucket[5m]))
)
Không tính trung bình của các phân vị
Một phân vị tính riêng cho mỗi endpoint không nên được cộng rồi chia để tạo phân vị chung của pool. Cần tổng hợp bucket trước rồi tính phân vị trên phân bố đã tổng hợp. Tuy vậy, pool chung vẫn có thể che endpoint riêng đang chậm, nên cần đường mở chi tiết. Dashboard tốt có cả cái nhìn nhóm và khả năng truy ra tài nguyên cụ thể, thay vì chỉ một đường trung bình trông ổn định.
Một bảng điều tra nên có endpoint, kết quả probe cuối, tuổi quan sát và tốc độ lỗi theo nhóm. Không xếp hạng chỉ bằng độ trễ khi một endpoint có ít lần thành công hơn nhiều endpoint khác. Nếu cần chọn tài nguyên cấp phát, hệ thống cấp phát phải dùng chính sách riêng với ngưỡng và dữ liệu phù hợp. Dashboard quan sát không nên âm thầm thay đổi thứ tự cấp phát chỉ vì người dùng sắp xếp cột trên màn hình.
Giám sát proxy bằng Prometheus và Grafana qua cảnh báo theo hành động
Tài liệu alerting rules giải thích điều kiện và thời gian for trước khi một cảnh báo chuyển sang firing. Anh em nên chọn ngưỡng từ nhịp probe, yêu cầu công việc và dữ liệu nền của hệ thống. Ví dụ dưới chỉ minh họa lỗi exporter kéo dài cùng dữ liệu probe quá hạn, không tự đặt một mức độ trễ chung rồi gắn nhãn đạt chuẩn cho mọi nhà cung cấp.
groups:
  - name: proxy-health
    rules:
      - alert: ProxyExporterUnavailable
        expr: up{job="proxy-probe"} == 0
        for: 2m
        labels:
          severity: warning
        annotations:
          summary: Exporter proxy khong duoc scrape
      - alert: ProxyProbeStale
        expr: time() - proxy_last_probe_timestamp_seconds > 180
        for: 2m
        labels:
          severity: warning
        annotations:
          summary: Probe proxy khong co ket qua moi
Các mốc trong rule là ví dụ cấu hình để đọc cách hoạt động. Trước khi dùng, thử với chu kỳ thật, thời gian bảo trì và ngân sách phát hiện lỗi. Nếu probe thường kéo dài hoặc chạy ít hơn, ngưỡng một trăm tám mươi giây có thể tạo cảnh báo không phù hợp. Khi exporter biến mất, biểu thức stale cũng có thể không còn chuỗi; vì vậy vẫn cần cảnh báo up hoặc cách phát hiện dữ liệu vắng theo inventory.
Mỗi cảnh báo cần một bước xử lý đầu tiên
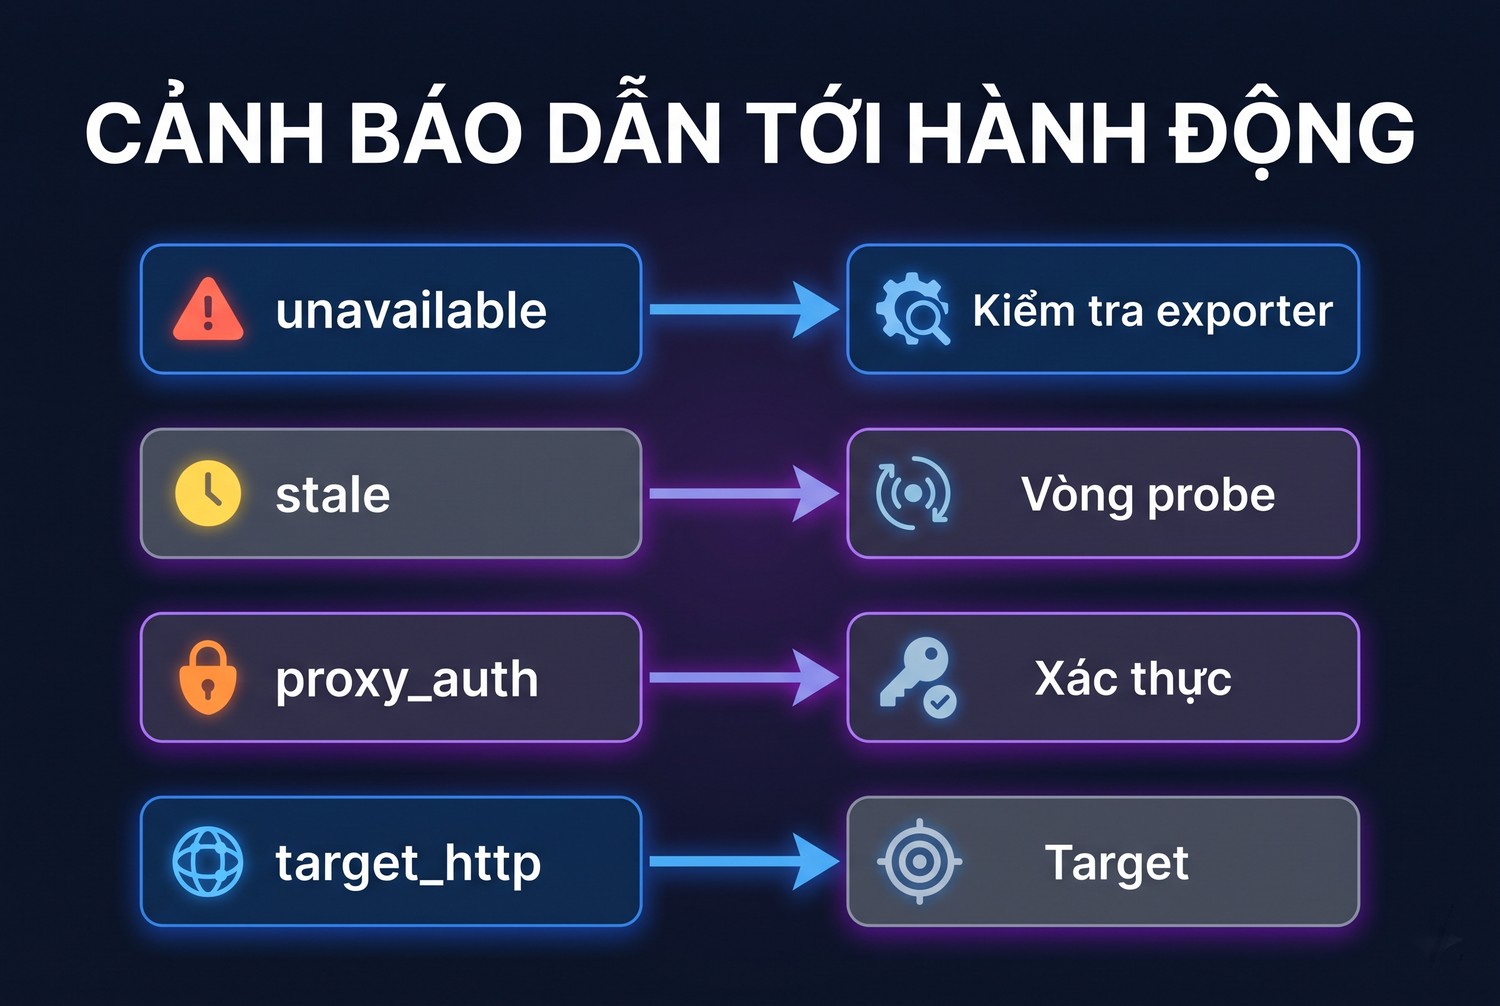
Exporter unavailable cần xem tiến trình, mạng scrape và cấu hình Prometheus. Probe stale cần xem vòng probe, target chậm hoặc tác vụ bị treo. Lỗi proxy_auth cần xem thông tin cấp quyền và thời hạn tài khoản. Target_http cần đối chiếu ứng dụng thử cùng mã phản hồi. Nếu mọi cảnh báo đều bảo đổi proxy, hệ thống giám sát sẽ đẩy người trực vào hành động không liên quan tới lớp đang có bằng chứng lỗi.
up xác nhận hệ thống thu metric; tuổi probe xác nhận độ mới; outcome mô tả kết quả yêu cầu đã thử.
Một cảnh báo tỷ lệ lỗi cũng cần số quan sát tối thiểu và phạm vi theo nhóm. Mười lần thử là con số minh họa có thể dùng để kiểm tra cú pháp, không phải mẫu đủ cho mọi kết luận chất lượng. Đội cần chọn cửa sổ theo nhịp công việc, đồng thời giữ cảnh báo dễ hiểu. Một biểu thức phức tạp không có tài liệu mẫu số sẽ khó hỗ trợ hơn một quy tắc hẹp có hành động rõ.
Với metric có nhãn outcome chỉ được tạo khi lần lỗi đầu tiên xảy ra, một cửa sổ ban đầu có thể thiếu chuỗi cho loại lỗi đó. Khi cần dashboard hiển thị đủ các nhóm ngay từ đầu, khởi tạo tập outcome hữu hạn với giá trị counter bằng không. Sau đó kiểm tra cách truy vấn xử lý trường hợp chưa có hai mẫu để tính rate. Không dùng dữ liệu khởi tạo để tăng số probe đã thực hiện trong báo cáo.
Việc gửi thông báo cũng cần được thử riêng với người trực và kênh nhận đã được tổ chức phê duyệt. Rule chuyển firing chưa chứng minh thông báo đã tới đúng người. Cần kiểm tra định tuyến, thời gian im lặng khi bảo trì và cách gom cảnh báo có cùng nguyên nhân. Nếu một exporter phục vụ nhiều endpoint cùng ngừng hoạt động, hàng loạt thông báo giống nhau có thể che mất nguyên nhân chung cần xử lý trước.
Cảnh báo dẫn tới hành động
Giám sát proxy bằng Prometheus và Grafana trên dashboard theo thời gian
Tài liệu cấu hình Prometheus trong Grafana mô tả các bước thêm data source và URL server. Cần quyền cấu hình phù hợp cùng địa chỉ Prometheus mà máy chủ Grafana truy cập được. Không mặc định localhost trong trình duyệt người dùng cũng là localhost của Grafana. Với triển khai nhiều container, phân biệt địa chỉ từ server tới server với địa chỉ mà người dùng mở để xem giao diện.
- Trong Grafana, mở Connections rồi chọn Add new connection theo tài liệu phiên bản đang triển khai.
- Tìm Prometheus, chọn Prometheus data source và chọn Add new data source.
- Ở phần Settings, đặt tên nguồn dữ liệu dễ nhận biết và điền Prometheus server URL phù hợp với mạng triển khai.
- Cấu hình xác thực hoặc chứng chỉ khi môi trường yêu cầu, rồi kiểm tra kết nối bằng chức năng kiểm tra của bản đang dùng.
- Tạo panel riêng cho up, tuổi probe, tỷ lệ lỗi và độ trễ thành công; giữ cùng phạm vi thời gian khi so sánh.
Bố cục hỗ trợ người trực tìm nguyên nhân
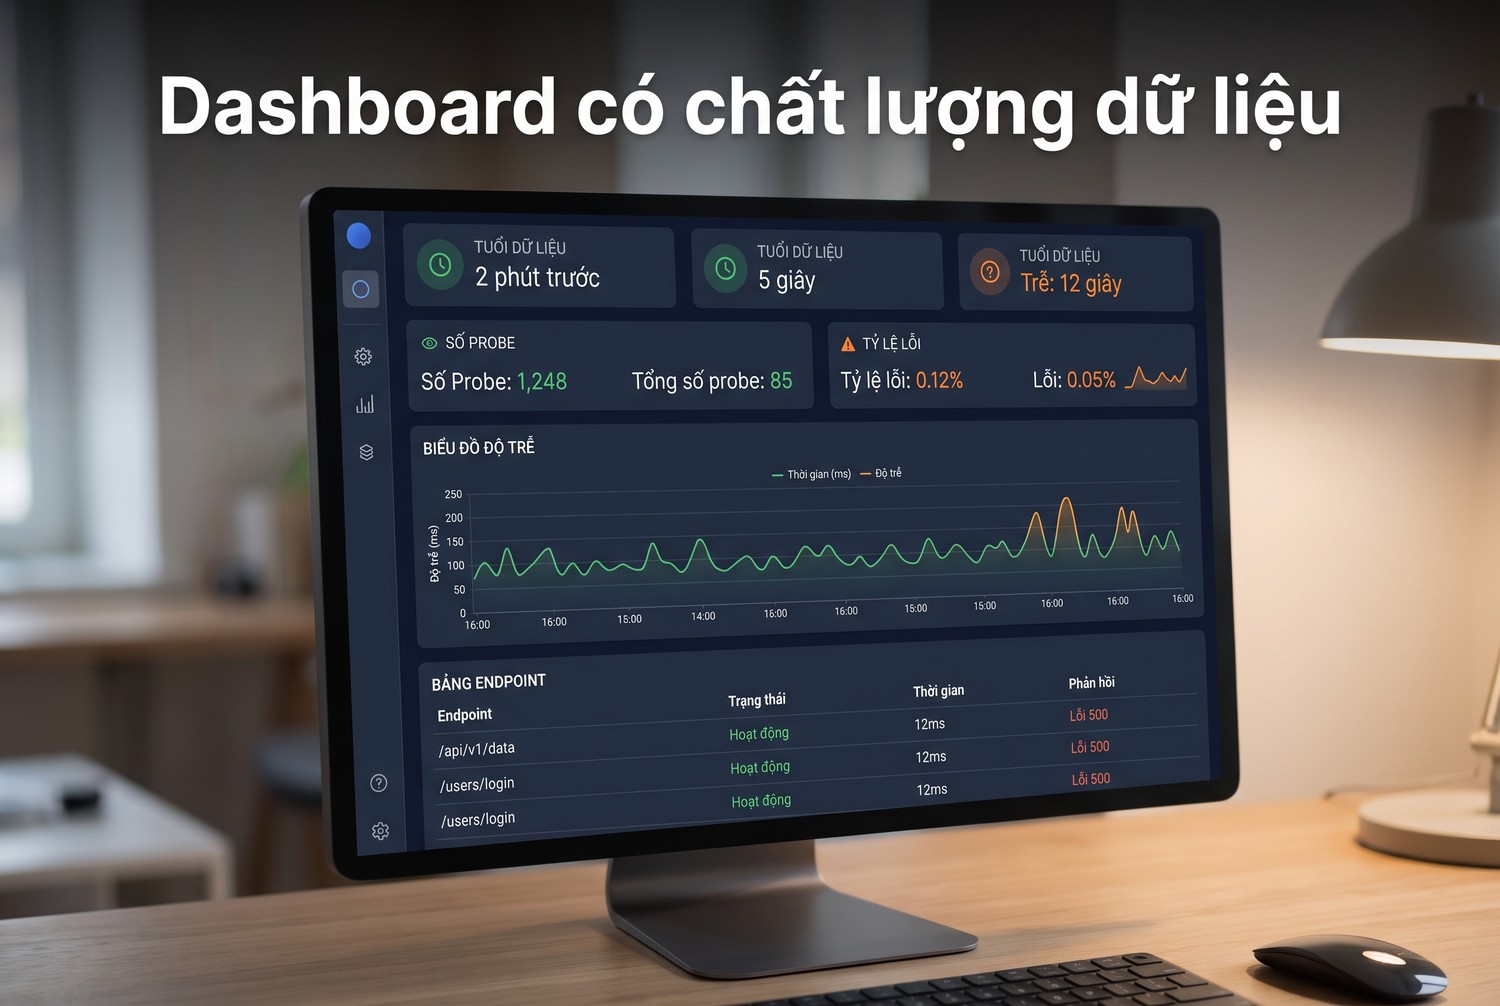
Hàng đầu nên cho biết hệ thống có dữ liệu mới hay không. Hàng tiếp theo thể hiện số probe và tỷ lệ lỗi; sau đó mới đến độ trễ và bảng endpoint. Bố cục này giúp người xem kiểm tra chất lượng dữ liệu trước khi kết luận về tài nguyên. Khi không có quan sát, dùng nhãn rõ thay vì tô xanh một ô rỗng. Với người không phân biệt được một số màu, văn bản trạng thái cũng cần đủ để đọc ý nghĩa.
Panel lỗi nên giữ nhóm outcome ổn định để nhìn được dịch chuyển từ lỗi xác thực sang lỗi đích. Khi một lần thay password làm nhiều endpoint lỗi, đường proxy_auth hoặc proxy_transport có thể tăng cùng thời điểm. Cần đối chiếu log và thay đổi cấu hình, vì ProxyError không cung cấp phân loại xác thực sâu trong mã mẫu. Không đặt tên một panel là lỗi mật khẩu nếu dữ liệu đầu vào chỉ biết lỗi đường tới proxy.
Nếu cần so sánh nhà mạng hoặc loại endpoint, đưa thuộc tính đó từ inventory đã xác minh. Không đoán nhà mạng từ tên mã nội bộ. Khi tài nguyên được thay thế, ghi chú thời điểm để người xem không diễn giải đoạn lịch sử mới như cùng một đường truyền cũ. Dashboard là nơi trình bày bằng chứng; các thuộc tính chưa được kiểm chứng cần giữ trạng thái chưa biết thay vì điền cho bảng trông đầy đủ.
Vận hành giám sát proxy bằng Prometheus và Grafana với dữ liệu thật
Kiểm thử exporter nên dùng response giả cho thành công, mã 407, lỗi HTTP, marker sai và các exception được xử lý. Xác nhận counter tăng đúng một lần, gauge cập nhật và histogram chỉ nhận lần thành công. Kiểm tra nội dung metric không chứa URL hoặc password giả đã đưa vào cấu hình. Đây là kiểm tra logic công bố số liệu, chưa thay thế phép thử kết nối mạng qua endpoint thật.
Kiểm tra toàn chuỗi trước khi dùng cảnh báo
Một phép thử tích hợp cần có exporter, Prometheus và Grafana chạy trong môi trường được quản lý. Dừng exporter có kiểm soát để xác nhận up đổi và cảnh báo đi đúng tuyến đã được phê duyệt. Tạm làm target trả marker sai để xác nhận tỷ lệ lỗi tăng mà scrape vẫn thành công. Sau đó khôi phục rồi xem thời gian hết cảnh báo. Không dùng dữ liệu giả để công bố uptime hay chất lượng của dịch vụ thương mại.
Trước khi mở rộng, đọc cách đo proxy success rate và thống nhất mẫu số với các báo cáo khác của đội. Nếu dashboard tính theo probe nền còn báo cáo tính theo yêu cầu nghiệp vụ, hai tỷ lệ có thể khác nhau dù cả hai đều được tính đúng. Ghi tên chỉ số đầy đủ giúp người sử dụng không so sánh những đại lượng có phạm vi khác nhau rồi tìm một lỗi không tồn tại.
Khi chuẩn bị mua proxy giá rẻ, anh em nên áp dụng cùng target, lịch đo và tiêu chí đạt cho endpoint mới, đồng thời đánh giá chi phí theo công việc hoàn thành thay vì chỉ nhìn một giá mua ban đầu.
Cuối cùng, giữ bản cấu hình, schema metric, rule cảnh báo và hướng xử lý trong cùng quy trình thay đổi. Khi đổi bucket, outcome hoặc nhãn, kiểm tra ảnh hưởng tới panel cũ và rule đang dùng. Một thay đổi nhỏ ở exporter có thể làm truy vấn mất dữ liệu mà không xuất hiện lỗi mạng. Bàn giao cần cho biết ai quản lý từng lớp và cách kiểm tra lại sau nâng cấp để giám sát tiếp tục phản ánh đúng hệ thống đang vận hành.
Cổng metric trong ví dụ chỉ bind loopback. Khi mở cho máy Prometheus khác truy cập, áp dụng giới hạn mạng và cơ chế bảo vệ phù hợp với hạ tầng. Metric không chứa password vẫn có thể tiết lộ tên nhóm công việc hoặc nhịp hoạt động. Không công khai exporter chỉ để dashboard từ xa đọc thuận tiện; Grafana đọc qua nguồn dữ liệu được cấu hình ở server, không cần từng người xem truy cập trực tiếp cổng này.
Khi một người rời nhóm vận hành, thu hồi quyền dashboard và quyền đọc cấu hình chứa bí mật. Việc chỉ xóa tên khỏi lịch trực chưa thay đổi những quyền truy cập đã được cấp trước đó.
Dashboard có chất lượng dữ liệu
Giám sát proxy bằng Prometheus và Grafana cần metric đúng nghĩa, dữ liệu mới và cảnh báo dẫn tới hành động cụ thể. Anh em có thể trao đổi endpoint tại Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam, rồi chuẩn hóa phép đo cho giám sát proxy bằng Prometheus và Grafana.


