
Crossref API bằng Python để đối soát DOI và ngày
Crossref API bằng Python giúp bổ sung metadata từ danh sách DOI có sẵn. Cần chuẩn hóa định danh có kiểm và phân biệt ngày xuất bản với ngày đăng ký hay cập nhật chỉ mục. Bài này dùng CSV tự tạo, giữ trạng thái thiếu DOI và kiểm một lookup công khai nhỏ trước khi thiết kế pipeline định kỳ. ProxyVN hướng dẫn cách kiểm trên dữ liệu mẫu.
Crossref API bằng Python cho danh sách DOI đầu vào
Tác vụ của bài bắt đầu từ một CSV DOI, không crawl trang tạp chí để tìm mọi tài liệu. Mỗi DOI được đối soát với metadata từ endpoint phù hợp. Output giữ trạng thái để người nhận biết record nào khớp, thiếu đầu vào hoặc chưa tìm thấy theo phạm vi nguồn.
Metadata không đồng nghĩa full text. Một record có title và ngày không tự cho phép tải hay tái bản nội dung ở website nhà xuất bản. Pipeline mẫu chỉ giữ các trường thư mục cần thiết và không thu email tác giả để mở rộng danh sách liên hệ.
REST API của Crossref là nguồn bắt đầu để kiểm endpoint và điều kiện dùng. Trong đợt soạn, một lookup DOI công khai đã trả HTTP 200. Ca nhỏ đó chưa kiểm harvesting nhiều trang hoặc quyền theo một pool tài khoản cụ thể.
DOI và title có vai trò khác nhau
DOI là định danh dùng cho tác vụ lookup, còn title là metadata có thể được sửa hoặc trùng giữa các work. Không dùng title để thay DOI khi một ô đầu vào thiếu. Nếu cần tìm kiếm để gợi ý DOI, đó là quy trình riêng có đánh giá khớp, không phải kết quả lookup trực tiếp.
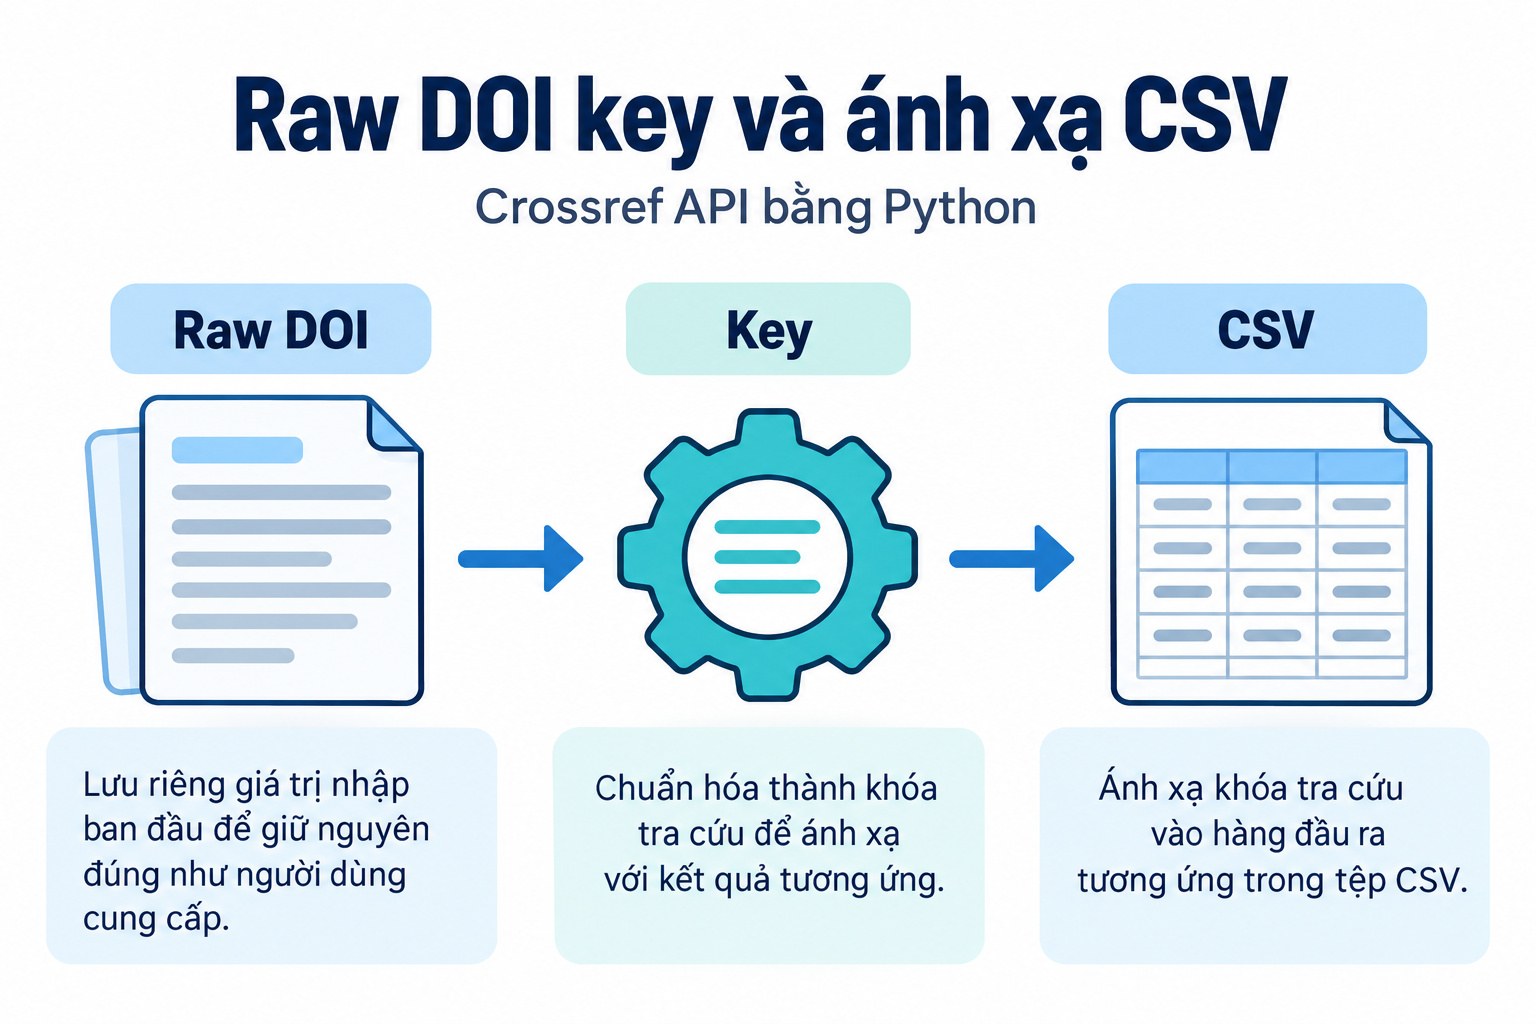
Một URL DOI và một chuỗi DOI thuần có thể chỉ cùng định danh theo quy tắc chuẩn hóa phù hợp. Giữ giá trị raw để truy lại cách người dùng cung cấp. Khi bỏ tiền tố, không được cắt tùy tiện những ký tự thật thuộc suffix.
Nếu một DOI không có trong Crossref, chưa đủ kết luận nó không tồn tại ở mọi cơ quan đăng ký. Trạng thái output nên nêu “không tìm thấy trong phép tra này” theo response, không tự gán nhãn DOI giả cho mọi trường hợp.
Crossref API bằng Python với chuẩn hóa DOI có giới hạn
Chuẩn hóa cần giải quyết các dạng đầu vào mà pipeline thật chấp nhận. CSV fixture có DOI URL viết hoa, tiền tố doi, ô trống và một mã không tìm thấy giả lập. Bộ này kiểm định danh cùng trạng thái, không chứng nhận mọi cú pháp DOI có thể xuất hiện ngoài Internet.
Raw DOI key và ánh xạ CSV
Giữ raw và key chuẩn hóa riêng
Ví dụ chỉ xử lý các tiền tố được nêu và so key không phân biệt hoa thường theo hợp đồng dữ liệu. Nó không xác minh registry và không tự resolve DOI. Những placeholder dùng trong fixture được đánh dấu là dữ liệu giả lập.
import re
def doi_key(value):
    return re.sub(r'^(?:https?://(?:dx\.)?doi\.org/|doi:\s*)',
                  '', value.strip(), flags=re.I).casefold()
assert doi_key('https://doi.org/10.0000/ALPHA') == '10.0000/alpha'
assert doi_key('doi:10.0000/alpha') == '10.0000/alpha'
assert doi_key('   ') == ''
Không dùng hàm này như validator DOI tổng quát. Nếu đầu vào là URL có encoding hoặc dạng khác, cần một adapter được kiểm. Giữ điều kiện hỗ trợ rõ giúp người nhận không cho mọi chuỗi qua chỉ vì nó bắt đầu bằng một tiền tố quen thuộc.
Một suffix có thể chứa ký tự dấu câu theo định danh thực. Đừng xóa mọi dấu ngoặc hoặc dấu chấm cuối bằng regex rộng khi input đến từ một ô CSV đã được định nghĩa. Nếu trích DOI từ câu văn, bước nhận diện ranh giới là nhiệm vụ khác cần nhãn riêng.
Dedupe request không làm mất hàng input
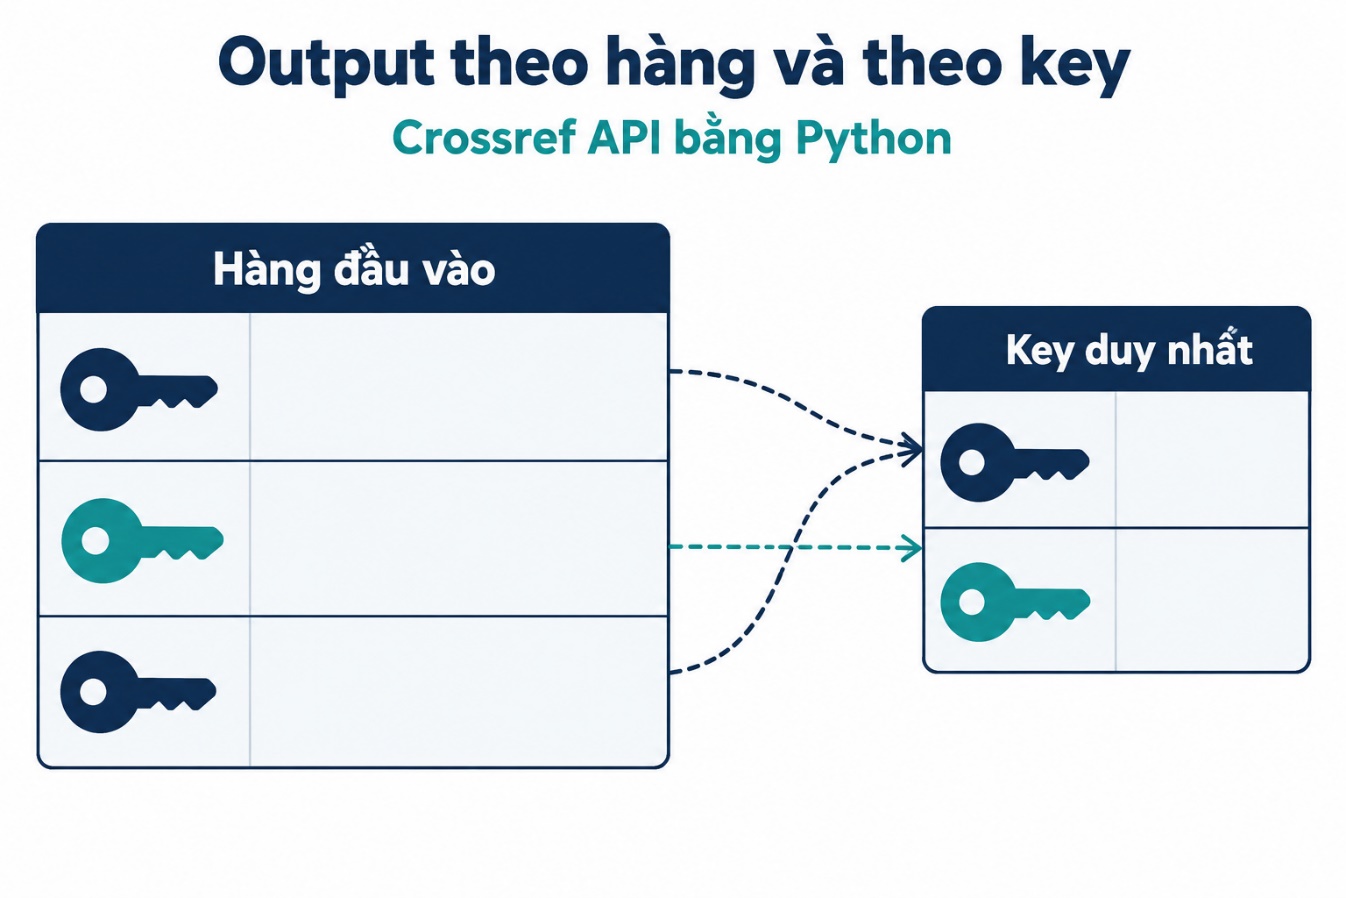
Hai hàng CSV có cùng doi_key có thể dùng chung một kết quả lookup. Nhưng nếu người dùng cần output theo hàng đầu vào, giữ input_row và ánh xạ về cả hai. Đừng xóa hàng trùng rồi khiến số output không còn đối soát được với file người dùng gửi.
Một ô trống nên đi vào nhóm missing_input mà không gửi request không có ý nghĩa. Một key không tìm thấy có trạng thái riêng sau phép tra. Hai tình huống khác nhau cần được giữ, thay vì điền cùng chuỗi “không có dữ liệu”.
Nếu dữ liệu có nhiều snapshot của cùng DOI, metadata có thể được cập nhật theo thời gian. Cache lookup cần có observed_at và chính sách refresh theo tác vụ. Dùng một kết quả cũ vô thời hạn có thể không phù hợp với yêu cầu đối soát hiện tại.
Crossref API bằng Python với lookup một work
Endpoint một work phù hợp khi đã có DOI. Client cần mã hóa phần đường dẫn theo hợp đồng URL và kiểm status trước khi đọc message. Một response lỗi không được biến thành object metadata trống rồi tính là lookup thành công.
Ví dụ request giới hạn
DOI trong đoạn live đã được tra công khai trong bộ kiểm. Code không tải full text hoặc gửi email. Nếu dự án dùng thông tin liên hệ cho cơ chế truy cập được tài liệu hỗ trợ, dùng dữ liệu có quyền và không giả địa chỉ trong ví dụ.
from urllib.parse import quote
import requests
doi = '10.1038/nphys1170'
response = requests.get('https://api.crossref.org/works/' + quote(doi, safe='/'),
                        timeout=20)
response.raise_for_status()
message = response.json()['message']
assert message['DOI'].casefold() == doi.casefold()
print(message.get('title', []))
Phép so DOI trả về giúp phát hiện mapping sai khi nối output, nhưng chưa xác minh mọi field khác. Title có thể là danh sách và dữ liệu ngày có độ chính xác khác nhau. Schema xuất nên giữ cấu trúc gốc cần thiết trước khi chọn một biểu diễn thuận tiện.
Tài liệu REST trên GitHub Crossref cung cấp thêm ngữ cảnh tham số, response và cách dùng dịch vụ. Giữ version hoặc ngày tham chiếu khi viết hướng dẫn vận hành. Không hardcode một quota lấy từ nguồn cũ rồi nhận đó là điều kiện hiện hành.
Chính sách gọi và polite pool
Một thông tin liên hệ trong request theo cơ chế API không phải quyền để gọi không giới hạn. Điều kiện pool và nhịp gọi cần đối chiếu tài liệu cùng response tại thời điểm triển khai. Bài không công bố hạn mức cố định hoặc cam kết tăng tốc theo pool chưa được thử.
Nếu cấu hình contact, giữ nó ngoài mã chia sẻ khi có yêu cầu riêng tư và dùng địa chỉ người vận hành có quyền sử dụng. Không tạo một email giả của tổ chức khác. Bộ live của bài không kiểm polite pool với credentials hoặc thông tin liên hệ riêng.
Khi dịch vụ báo hạn chế, dừng hoặc chờ theo chính sách thay vì đổi proxy để tiếp tục vượt điều kiện. Proxy có thể phục vụ tuyến mạng doanh nghiệp, nhưng không tự tăng quyền truy cập API. Hai tiêu chí cần được quản lý riêng trong pipeline.
Crossref API bằng Python và các loại ngày
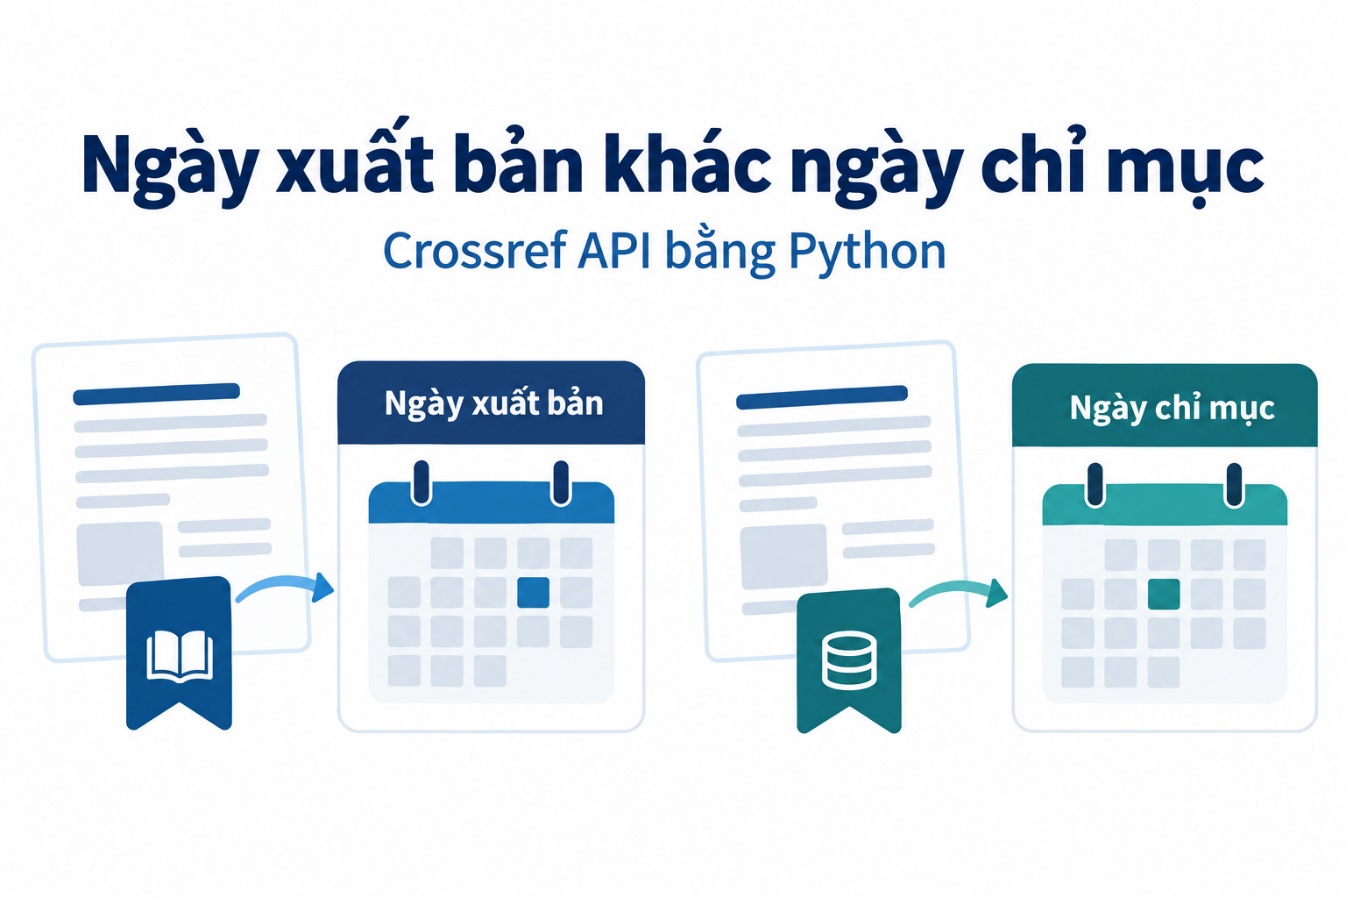
Ngày trong metadata có thể mô tả xuất bản, đăng ký, gửi lại metadata hoặc cập nhật chỉ mục. Chúng không đồng nghĩa. Chọn sai field có thể làm một bài cũ xuất hiện như công bố mới trong báo cáo nghiên cứu.
Ngày xuất bản khác ngày chỉ mục
Nhóm trường |
Câu hỏi cần phân biệt |
Cách giữ |
|---|---|---|
published hoặc published-print |
Nguồn công bố thời gian xuất bản |
Field gốc và precision |
created |
Thời điểm tạo record theo API |
Không thay ngày bài |
deposited hoặc indexed |
Cập nhật metadata hoặc chỉ mục |
Cột riêng theo nghĩa |
observed_at |
Lần client nhận metadata |
Timestamp của công việc |
Ngày thiếu thành phần không được tự điền
Một date-parts chỉ có năm khác một ngày đầy đủ. Dữ liệu có năm và tháng chưa công bố ngày cụ thể. Đừng thêm ngày một để tiện đưa vào cột date nếu output sẽ được người dùng hiểu là ngày nguồn xác nhận.
Có thể lưu parts cùng precision year, month hoặc day theo schema nội bộ. Nếu cần một giá trị để sort, tạo trường suy ra riêng với nhãn rõ. Không trộn giá trị suy ra vào cùng cột ngày gốc mà không có dấu phân biệt.
Trong fixture, ba dạng năm, năm-tháng và năm-tháng-ngày được kiểm thành ba biểu diễn giữ precision. Bộ thử không làm một validator mọi ngày lịch hoặc mọi dạng date-time. Nếu nguồn có dữ liệu ngoài phạm vi, ghi lỗi theo field thay vì đoán.
Quan sát từ lookup live nhỏ
Record đã tra có title Measured measurement và DOI khớp đầu vào. published-print công bố năm và tháng trong phần metadata đã giữ. Các mốc tạo record và chỉ mục có độ chi tiết khác, minh họa lý do không dùng một cột date chung cho mọi trường.
Ngày indexed có thể mới hơn nhiều so với năm xuất bản vì nó mô tả hoạt động dữ liệu. Nếu báo cáo theo năm bài, lấy indexed làm publication year sẽ làm sai mục tiêu. Giữ tên field gốc để người biên tập kiểm được phép chọn.
Một lookup không chứng minh mọi record Crossref đều có cùng bộ ngày. Field có thể thiếu hoặc cấu trúc khác theo loại work. Code nên có nhánh cho thiếu dữ liệu và báo precision thay vì index mù vào danh sách chưa kiểm.
Crossref API bằng Python với title và metadata thiếu
Các field thư mục cần được chuẩn hóa theo một schema có nguồn. Không chuyển mọi giá trị sang str để tránh lỗi kiểu, vì object hoặc list có thể bị biến thành chuỗi khó dùng. Giữ raw metadata cần thiết để kiểm lại quyết định chọn.
Title là danh sách theo response cần xử lý
Với tác vụ xuất một tiêu đề chính, định nghĩa cách chọn trong danh sách và giữ danh sách raw nếu cần. Không lấy phần tử đầu mà không kiểm danh sách có tồn tại và chứa chuỗi. Một record thiếu title không phải lý do tự dùng DOI làm tiêu đề nguồn.
Nếu title có markup hoặc ký tự đặc biệt, chọn cách làm sạch có kiểm và giữ nguyên bản trước xử lý. Không giải mã HTML entity nhiều lần theo phỏng đoán. Một lỗi hiển thị ở CSV hoặc terminal cũng cần được tách với metadata thực nhận.
Tên nhà xuất bản hoặc nguồn có thể hỗ trợ người đọc hiểu record, nhưng không thay kiểm định danh. Hai work cùng publisher vẫn là hai thực thể khác nhau. Khóa join nên theo DOI đã được đối soát và phạm vi dữ liệu của tác vụ.
Thiếu field cần trạng thái chứ không cần dữ liệu bịa
Nếu published-online thiếu, không dùng created để lấp mà vẫn gọi đó là ngày online. Nếu title thiếu, giữ null hoặc trạng thái theo hợp đồng. Output nhìn đầy cột nhưng sai ý nghĩa sẽ khó sửa hơn một record có lỗi được nêu rõ.
Nếu một field bắt buộc cho báo cáo, đưa record vào nhóm chưa đủ metadata hoặc kiểm tay theo quy trình. Lookup thành công HTTP vẫn có thể không đủ dữ liệu cho nhiệm vụ. Tách transport_status với data_status giúp report phản ánh cả hai.
Không tải mọi link full text để bù dữ liệu thiếu khi tác vụ chỉ cho phép metadata. Nguồn khác cần quyền và thiết kế thu riêng. Bài giữ ranh giới đối soát thư mục để không biến một CSV DOI thành công cụ thu nội dung ngoài phạm vi.
Crossref API bằng Python trong pipeline CSV
Pipeline cần giữ input_row, raw_doi, doi_key, status và metadata chuẩn hóa. Những trường này giúp nối output về file đầu vào, đặc biệt khi có trùng hoặc ô thiếu. Đừng chỉ xuất các record đẹp rồi làm người dùng không biết phần còn lại đi đâu.
Output theo hàng và theo key
Đối soát số lượng theo hàng và theo key
Trong fixture có bốn hàng raw nhưng chỉ hai key không rỗng khác nhau. Hai hàng đầu cùng key được gắn nhãn khớp giả lập, một hàng thiếu và một key không tìm thấy giả lập. Đây là dữ liệu tự tạo để kiểm mapping, không phải kết quả registry của các placeholder.
Nếu dedupe request, cache kết quả theo key rồi ghép lại từng input_row. Số request tiềm năng không bằng số hàng output. Báo hai đại lượng riêng giúp hiểu phần tối ưu mà không làm mất trace của file người dùng.
Khi xuất CSV, dùng thư viện csv và encoding rõ. Title có dấu phẩy hoặc xuống dòng cần được quote đúng. csv của Python là nguồn đối chiếu thao tác, không nên tự split hoặc ghép dòng bằng dấu phẩy.
Retry và checkpoint không được che lỗi
Lỗi tạm có thể được thử lại có giới hạn theo phản hồi dịch vụ. Lỗi tham số hoặc DOI đầu vào cần sửa theo dữ liệu, không chỉ chờ thêm. Giữ số lần và lý do để người vận hành biết một record chưa có kết quả vì đâu.
Checkpoint nên gắn với hash input và cấu hình lookup. Nếu file CSV đã đổi, không tiếp tục từ số dòng cũ mà không kiểm. Một row number chỉ có ý nghĩa trong đúng phiên bản file đã được nhận diện.
Khi mua proxy cho tuyến API được phép, giữ kiểm mạng riêng với logic DOI. Một proxy khác không sửa ngày bị chọn sai hoặc định danh bị cắt suffix. Bộ bài không kiểm gateway thương mại và không hứa proxy nâng quota.
Crossref API bằng Python và bộ nghiệm thu
Bộ kiểm gồm phép lookup live nhỏ cùng fixture chuẩn hóa CSV và ngày. Hai nhóm có vai trò khác nhau nên cần ghi riêng. Không gọi nhãn giả lập not_found là một status 404 đã quan sát từ API thật.
Lookup live và fixture precision
Những ca đã chạy
Lookup DOI công khai trả 200, DOI response khớp và metadata được giữ hẹp theo mục tiêu. Fixture kiểm hai dạng định danh về cùng key, ô trống được giữ trạng thái thiếu và ngày giữ đúng precision. Nó không kiểm mọi agency, mọi cú pháp DOI hoặc mọi pool truy cập.
Các placeholder được giữ để người nhận có thể tái hiện mà không gửi request vào registry. Không dùng chúng làm ví dụ một công trình thật. Phần live có một DOI cụ thể riêng với log ngày kiểm để đối chiếu.
Những ca cần thêm theo dự án
Thêm DOI không tìm thấy thật nếu có một bộ input được phép dùng, response hạn chế và lỗi mạng theo môi trường kiểm soát. Thêm title thiếu, danh sách rỗng và ngày sai shape cho parser. Mỗi ca cần expected trước khi chạy.
Nếu thu nhiều work bằng endpoint list, thêm phân trang và checkpoint theo API tương ứng. Bài tập trung lookup theo DOI, không nhận một request singleton đã nghiệm thu harvesting toàn bộ. Không mở rộng tốc độ chỉ từ thời gian của một GET.
Tài liệu urllib.parse hỗ trợ kiểm phần mã hóa URL trong client. Giữ raw DOI và key trước khi tạo request giúp giải thích lỗi path hoặc ký tự đặc biệt. Một URL gọi thành công chưa chứng minh quy tắc chuẩn hóa mọi đầu vào đã đúng.
Crossref API bằng Python với độ chính xác thời gian
Độ chính xác của ngày cần được giữ như một phần dữ liệu. Một năm chỉ tạo phạm vi theo năm, không chỉ một điểm thời gian cụ thể. Nếu ứng dụng cần sort hoặc vẽ biểu đồ theo ngày, nó phải biết giá trị nào được nguồn công bố đủ và giá trị nào được suy ra cho trình bày.
Biểu diễn năm tháng và ngày không bị điền thêm
Fixture năm 2020 được xuất thành chuỗi năm với precision year. Fixture năm và tháng được xuất thành 2020-05 với precision month. Fixture đủ ba phần tạo 2020-05-03 với precision day. Ba trạng thái này không nên bị ép về cùng một chuỗi ngày đầy đủ mà mất nhãn.
Nếu cần một ngày đại diện để sắp thứ tự, tạo field derived_date theo chính sách nội bộ và giữ nguồn quy tắc. Người dùng vẫn phải nhìn được precision gốc. Một ngày suy ra để vẽ trục thời gian không phải ngày xuất bản đã được registry xác nhận.
Không lấy ngày một của tháng rồi trích dẫn nó như một sự kiện nguồn xảy ra hôm đó. Điều này đặc biệt quan trọng khi so với mốc đăng ký hoặc mốc cập nhật có đủ ngày. Chênh lệch độ chi tiết không được che bằng một định dạng nhìn đồng nhất.
Một date-parts ngoài số phần hỗ trợ cần lỗi hoặc trạng thái chưa hiểu. Đừng index ba phần bất chấp dữ liệu có hay không. Validator lịch, nếu dự án yêu cầu, cần kiểm thêm tháng và ngày hợp lệ thay vì chỉ ghép số thành chuỗi.
Nhiều ngày xuất bản cần một quy tắc lựa chọn
Nguồn có thể công bố các mốc online và print khác nhau. Báo cáo phải nói đang dùng mốc nào theo mục tiêu. Không tự chọn ngày sớm nhất của mọi field kể cả created và indexed rồi gọi đó là publication date.
Nếu tác vụ cần cả hai mốc, giữ hai cột cùng precision riêng. Một mốc thiếu không làm mốc còn lại sai, nhưng cũng không cho phép tự gán chúng bằng nhau. Dữ liệu thiếu là thông tin về mức đầy đủ mà report cần phản ánh.
Một quy tắc ưu tiên được dự án chọn nên có version. Khi thay từ print sang online, nhiều record có thể đổi năm trong bảng cuối mà API không hề sửa dữ liệu. Report cần phân biệt đổi phương pháp với cập nhật metadata của nguồn.
Observed time nối với một lần lookup
Thời điểm client nhận response cho biết lúc quan sát dữ liệu. Nó không phải deposited hoặc indexed của nguồn. Giữ timestamp UTC và mã lần chạy giúp nối report với log mà không phụ thuộc timezone hiển thị của máy người nhận.
Nếu dùng cache, lưu thời điểm kết quả được lấy chứ không chỉ thời điểm cache được đọc. Một report tạo hôm nay có thể dùng metadata đã cache trước đó. Ghi hai mốc nếu tác vụ cần đánh giá độ mới, không gán ngày tạo CSV thành ngày API được truy vấn.
Khi kết quả live khác một bản cũ, so field và thời điểm trước khi kết luận pipeline lỗi. Registry có thể được cập nhật. Snapshot hẹp có DOI, title và các ngày cần thiết giúp kiểm sự thay đổi mà không phải lưu mọi field ngoài nhiệm vụ.
Crossref API bằng Python với đối soát từng hàng CSV
File input và tập key lookup là hai cấu trúc liên quan nhưng khác nhau. Một tối ưu dedupe chỉ nên giảm số lookup, không làm mất mối nối của người dùng tới từng hàng. Bộ bốn hàng tự tạo giúp kiểm ranh giới đó bằng số lượng nhỏ.
Hai đầu vào cùng một key
Hàng đầu dùng DOI URL viết hoa phần định danh, hàng sau dùng tiền tố doi với cùng mã. Hàm fixture chuẩn hóa chúng về cùng key. Nếu cache lookup theo key, một kết quả có thể được gắn về cả hai input_row theo yêu cầu xuất.
Output có hai hàng metadata giống không có nghĩa API bị gọi hai lần. Ngược lại, một bảng chỉ có một key không cho biết người dùng đã đưa bao nhiêu hàng. Báo số hàng input, số key không rỗng và số lookup thực theo đơn vị riêng.
Không dùng title làm cách phát hiện hai DOI trùng. Hai title giống có thể thuộc các work khác, và một DOI có thể được sửa title. Bộ chuẩn hóa định danh phải làm việc trên trường DOI theo hợp đồng, giữ raw cho người kiểm.
Ô trống và key không có kết quả
Hàng trống được đánh missing_input trong fixture và không cần gửi request. Đây là lỗi hoặc trạng thái của file đầu vào. Hàng unknown được gắn nhãn không tìm thấy giả lập để kiểm report, không phải một DOI đã được gọi thật rồi nhận status 404.
Khi dùng API thật, lấy trạng thái từ response và giữ phạm vi nguồn. Không tìm thấy tại endpoint Crossref không chứng minh một định danh không có ở nguồn đăng ký khác. Nếu dự án cần xác minh toàn hệ thống DOI, phải thiết kế quy trình phù hợp riêng.
Một record có key nhưng response chưa nhận do timeout nên giữ trạng thái pending hoặc lỗi tải theo schema, khác not_found. Nếu gộp chúng, người nhận sẽ tưởng registry không có dữ liệu trong khi phép lookup chưa hoàn tất.
Kiểm title và ngày sau khi xuất file
Đọc lại CSV bằng thư viện hoặc công cụ mà người nhận dùng. Một title có dấu phẩy có thể làm sai cột nếu được ghép thủ công; một giá trị ngày partial có thể bị bảng tính tự diễn giải. Giữ schema giao nhận để người dùng không mất precision khi mở file.
Nếu công cụ chuyển 2020-05 thành một ngày mặc định, đó là một phép diễn giải ở phía nhận. Không sửa dữ liệu nguồn cho khớp hiển thị đó. Có thể cần cột precision và hướng dẫn nhập text theo hợp đồng để giữ đúng ý nghĩa.
Đối soát input_row ở cả bốn hàng sau khi đọc lại. Nếu một hàng biến mất do dedupe hoặc lỗi quote, tổng đơn giản có thể chưa chỉ ra lý do. So khóa dòng cùng trạng thái và metadata giúp phát hiện sai mapping.
Chuẩn hóa URL không phải xóa mọi ký tự lạ
Khi DOI chứa ký tự cần mã hóa trong URL, dùng thư viện URL thay vì thay chuỗi tùy tiện. Phân biệt DOI raw với URL dùng gọi endpoint. Một giá trị hiển thị đẹp không tự bảo đảm request path vẫn giữ cùng định danh.
Nếu input là DOI URL đã percent-encode, chỉ decode theo quy tắc của dạng input đó và kiểm trên fixture. Không unquote nhiều lần mọi chuỗi DOI vì có thể biến một phần dữ liệu thành ký tự khác ngoài ý muốn. Giữ dạng raw để có đường đối chiếu khi kết quả không khớp.
Mỗi adapter nhận dạng thêm nên có expected key và expected trạng thái khi không hỗ trợ. Chấp nhận ít dạng có kiểm có thể hữu ích hơn cố sửa mọi chuỗi. Điều quan trọng là output nói rõ phần nào được chuẩn hóa và phần nào cần người dùng xem lại.
DOI giữ danh tính work; các ngày metadata cần được gọi đúng tên và giữ độ chính xác mà nguồn thực công bố.
Anh em hãy lưu dữ liệu mẫu cùng cấu hình và kết quả đối chiếu để lần cập nhật sau có cơ sở kiểm lại. Tham khảo thêm tại Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam. Bắt đầu từ phạm vi nhỏ và tiêu chí rõ ràng khi triển khai Crossref API bằng Python.


