
Crawl Yelp bằng Python: Places API, business ID và lưu đệm 24 giờ
Crawl Yelp bằng Python ổn định nhất khi đi qua Yelp Places API, tên mới của Yelp Fusion API. API trả địa điểm có business ID cố định, có hạn mức báo qua header và có quy định lưu đệm rõ ràng. Bài này, ProxyVN hướng dẫn chuẩn hoá địa điểm, chống trùng bằng business ID, lưu đoạn trích đánh giá đúng thời hạn và xử lý hạn mức theo ngày.
Mục tiêu và phạm vi của crawl Yelp bằng Python
Yelp là nguồn dữ liệu địa điểm và đánh giá lớn ở Mỹ và một số thị trường khác. Người làm dữ liệu thường cần nó cho ba việc: lập danh sách cơ sở kinh doanh theo ngành trong một khu vực, so sánh điểm đánh giá giữa các cơ sở, và đối chiếu danh sách khách hàng của mình với hồ sơ trên Yelp. Mỗi việc cần một cách gọi API và một cách lưu khác nhau.
Dữ liệu địa điểm và dữ liệu đánh giá
Dữ liệu địa điểm gồm tên, địa chỉ, toạ độ, ngành, mức giá, điểm trung bình và số lượng đánh giá. Đây là phần tĩnh, ít đổi theo ngày. Dữ liệu đánh giá gồm nội dung người dùng viết, thay đổi liên tục và gắn với quy định hiển thị riêng của Yelp.
Bài tách hai loại này thành hai bảng với chính sách lưu khác nhau. Bảng địa điểm giữ business ID lâu dài, các trường khác làm mới theo chu kỳ. Bảng đoạn trích đánh giá có thời hạn sống ngắn, đúng như hướng dẫn của Yelp về lưu đệm.
Phạm vi kỹ thuật
Sau bài, anh em có kịch bản gọi tìm kiếm theo khu vực và ngành, phân trang bằng offset, gộp kết quả trùng giữa các truy vấn theo business ID, lưu SQLite và dọn dữ liệu quá hạn. Toàn bộ chạy được với phản hồi mẫu đặt trong code.
Bài không đọc trang Yelp, không thu thập hồ sơ người viết đánh giá và không vượt hạn mức bằng cách đổi IP hay tạo nhiều khoá. Business ID là thứ duy nhất anh em nên coi là dữ liệu lâu dài khi làm việc với Yelp API. Tóm lại, crawl Yelp bằng Python trong bài là xây danh mục địa điểm sạch, không trùng, tuân thủ thời hạn lưu đệm.
Nguồn được phép khi crawl Yelp bằng Python
Câu hỏi đầu tiên là Yelp cho phép lấy dữ liệu qua đường nào và với điều kiện gì. Điều khoản dịch vụ và tài liệu API trả lời khá rõ. Phần này trích những điểm ProxyVN đọc được ngày 23/10/2026.
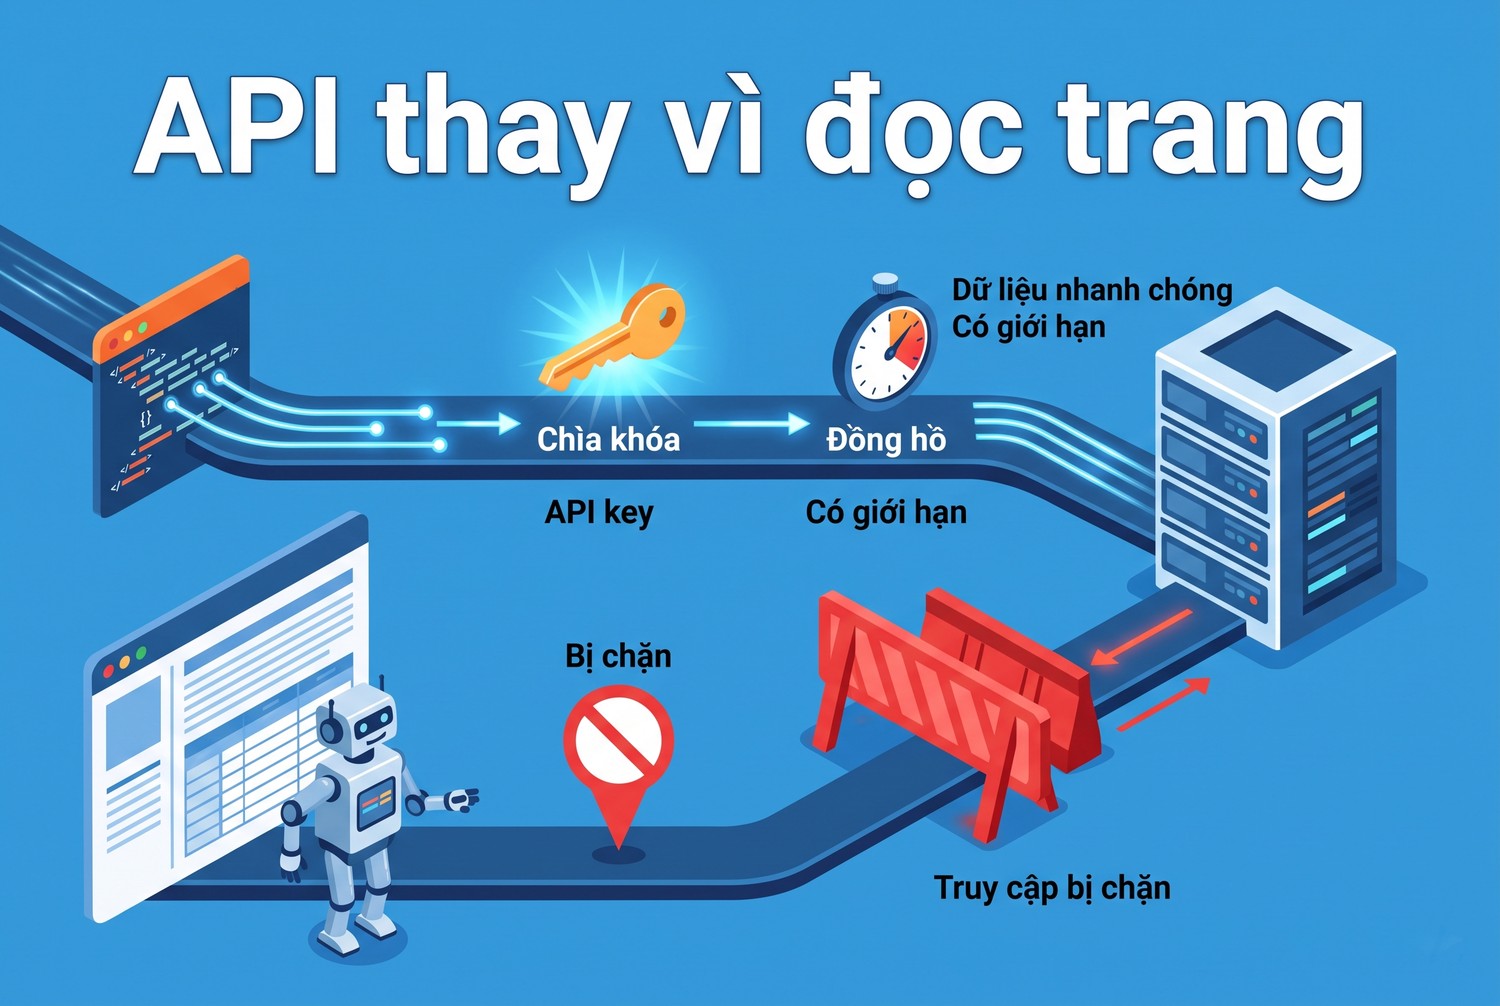
API thay vì đọc trang
Điều khoản dịch vụ website
Điều khoản dịch vụ của Yelp cấm dùng robot, spider, ứng dụng tìm kiếm hay phương tiện tự động khác để truy cập, sao chép, cào hoặc lập chỉ mục bất kỳ phần nào của dịch vụ, trừ khi Yelp cho phép rõ ràng, ví dụ theo mô tả trong robots.txt. Một mục khác cấm dùng phương tiện tự động để thu thập dữ liệu, nội dung hay đánh giá từ trang người dùng và trang doanh nghiệp.
Hai mục này cho thấy đọc trang Yelp bằng kịch bản không phải lựa chọn hợp lệ cho việc gom dữ liệu. Đường đi chính thức là API, với điều khoản API và quy định hiển thị đi kèm.
Yelp Places API
Trang giới thiệu Yelp Places API cho biết mọi endpoint nằm dưới đường dẫn https://api.yelp.com/v3 và dùng khoá API riêng được tạo khi anh em tạo ứng dụng. Danh sách endpoint gồm tìm kiếm doanh nghiệp, tìm theo số điện thoại, đối chiếu doanh nghiệp, chi tiết doanh nghiệp và đánh giá. Trang cũng nhắc tới gói dịch vụ và bản dùng thử, nghĩa là anh em cần xem gói phù hợp trước khi lên kế hoạch số lượt gọi.
Tài liệu endpoint tìm kiếm ghi endpoint trả tối đa 240 doanh nghiệp cho một bộ tiêu chí. Tham số location hoặc cặp latitude, longitude là bắt buộc. Tham số limit từ 0 tới 50, mặc định 20, còn offset từ 0 tới 1000. Tham số sort_by chỉ là gợi ý cho thuật toán tìm kiếm, không bắt buộc áp dụng.
Đoạn trích đánh giá và thời hạn lưu
Tài liệu endpoint đánh giá ghi endpoint trả tối đa ba đoạn trích đánh giá cho một doanh nghiệp theo thứ tự sắp xếp mặc định của Yelp. Đây là đoạn trích, không phải toàn văn, và không phải toàn bộ đánh giá của doanh nghiệp.
Trang hạn mức của Yelp khuyên trong giai đoạn phát triển nên giảm số lượt gọi bằng cách lưu đệm dữ liệu Yelp tối đa 24 giờ và lưu business ID, loại ID có thể dùng riêng cho việc đối chiếu ở phía máy chủ. Đây là quy tắc mà phần lưu trữ trong bài bám theo.
Bảng dưới tóm tắt các endpoint dùng trong bài và giới hạn tương ứng theo tài liệu ngày 23/10/2026.
Endpoint |
Đường dẫn |
Giới hạn chính |
Dùng cho |
|---|---|---|---|
Business Search |
/v3/businesses/search |
Tối đa 240 kết quả, limit 0-50 |
Lập danh mục theo khu vực, ngành |
Business Details |
/v3/businesses/{id} |
Một doanh nghiệp mỗi lần |
Làm mới thông tin chi tiết |
Business Match |
/v3/businesses/matches |
Theo địa chỉ đầu vào |
Đối chiếu danh sách riêng |
Reviews |
/v3/businesses/{id}/reviews |
Tối đa 3 đoạn trích |
Hiển thị đánh giá mẫu |
Kết lại, crawl Yelp bằng Python hợp lệ là dùng Places API với khoá riêng, chấp nhận giới hạn 240 kết quả mỗi tiêu chí và tuân thủ thời hạn lưu đệm 24 giờ.
Chuẩn hoá địa điểm khi crawl Yelp bằng Python
Kết quả tìm kiếm Yelp có cấu trúc lồng nhau: toạ độ nằm trong coordinates, địa chỉ trong location, ngành là danh sách object. Bước chuẩn hoá làm phẳng cấu trúc này thành một dòng có trường ổn định, để so sánh được giữa các lần gọi.
Business ID và alias
Mỗi doanh nghiệp có hai định danh: id là chuỗi ký tự ngẫu nhiên cố định, alias là chuỗi đọc được, thường ghép từ tên và thành phố. Endpoint đánh giá chấp nhận cả hai, nhưng alias có thể đổi khi doanh nghiệp đổi tên. Vì vậy, khoá chính trong bài là id, còn alias chỉ lưu để hiển thị.
Một lỗi hay gặp là dùng tên doanh nghiệp làm khoá. Chuỗi cửa hàng có nhiều chi nhánh cùng tên, và tên có thể viết khác nhau giữa các lần cập nhật. Dùng id giúp tránh cả hai vấn đề.
Quy tắc chuẩn hoá từng trường
Danh sách dưới ghi quy tắc ProxyVN dùng cho từng nhóm trường. Mục tiêu là hai lần gọi cùng một doanh nghiệp cho ra cùng một dòng, trừ khi dữ liệu thật sự đổi.
- Tên: gộp khoảng trắng, giữ chữ hoa để hiển thị.
- Toạ độ: làm tròn 5 chữ số thập phân, tương đương độ chính xác khoảng một mét.
- Địa chỉ: ghép từ các thành phần, mã bưu chính giữ dạng chuỗi để không mất số không đầu.
- Ngành: lấy alias của từng ngành, sắp xếp rồi nối bằng dấu phẩy.
- Mức giá: giữ ký hiệu đô la gốc và thêm cột số từ 1 tới 4.
- Điểm và số đánh giá: giữ nguyên, kèm thời điểm lấy để biết độ mới.
Sắp xếp ngành trước khi nối là chi tiết nhỏ nhưng quan trọng. API có thể trả cùng danh sách ngành theo thứ tự khác nhau, và nếu không sắp xếp, mỗi lần gọi sẽ trông như dữ liệu đã đổi.
Không lưu gì về người dùng
Phản hồi đánh giá có thông tin người viết như tên hiển thị và ảnh đại diện. Bài không đọc các trường này. Với phân tích, nội dung đoạn trích, điểm và thời điểm là đủ. Tóm lại, chuẩn hoá địa điểm Yelp gồm lấy id làm khoá, làm phẳng cấu trúc lồng và sắp xếp các danh sách để so sánh ổn định.
Chuẩn bị môi trường cho crawl Yelp bằng Python
Lab dùng Python 3.12 với Requests để gọi API và sqlite3 để lưu. Phản hồi mẫu đặt trong code mô phỏng hai truy vấn ngành khác nhau trong cùng một khu vực, có doanh nghiệp xuất hiện ở cả hai truy vấn.
Cài đặt và khoá API
Khoá API tạo trong trang quản lý ứng dụng của tài khoản nhà phát triển Yelp. Khoá gửi qua header Authorization dạng Bearer, đặt trong biến môi trường, không ghi trong code.
python -m venv .venv
.\.venv\Scripts\Activate.ps1
python -m pip install requests
$env:YELP_API_KEY = 'YOUR_API_KEY'
Khi ProxyVN dựng lab, phiên bản Requests là 2.34.2 trên Python 3.12.10. Bài không gọi API thật nên không có khoá thật trong lab.
Phản hồi mẫu hai truy vấn
Truy vấn thứ nhất tìm quán cà phê, truy vấn thứ hai tìm tiệm bánh trong cùng khu vực. Một doanh nghiệp vừa bán cà phê vừa bán bánh nên xuất hiện ở cả hai, với thứ tự ngành khác nhau. Toàn bộ tên, id và toạ độ là giả lập.
import os
import json
import time
import sqlite3
from datetime import datetime, timezone, timedelta
import requests

YELP_BASE = "https://api.yelp.com/v3"

def biz(i, name, cats, lat, lon, rating, count, price="$$", zip_code="02139"):
    return {"id": i, "alias": name.lower().replace(" ", "-") + "-cambridge", "name": name,
            "categories": [{"alias": c, "title": c.title()} for c in cats],
            "coordinates": {"latitude": lat, "longitude": lon},
            "location": {"address1": "1 Demo St", "city": "Cambridge", "zip_code": zip_code,
                         "country": "US"},
            "rating": rating, "review_count": count, "price": price, "is_closed": False}

SEARCH = {
    "coffee": [{"total": 3, "businesses": [
        biz("aaa111", "Demo Roasters", ["coffee", "bakeries"], 42.3736158, -71.1097335, 4.5, 210),
        biz("bbb222", "Quiet  Cup", ["coffee"], 42.36, -71.10, 4.0, 85)]},
               {"total": 3, "businesses": [
        biz("ccc333", "Late Bean", ["coffee", "cafes"], 42.37, -71.12, 3.5, 40, price="$")]}],
    "bakeries": [{"total": 1, "businesses": [
        biz("aaa111", "Demo Roasters", ["bakeries", "coffee"], 42.37361581, -71.10973349, 4.5, 211)]}],
}
Doanh nghiệp aaa111 ở truy vấn tiệm bánh có số đánh giá tăng thêm một và toạ độ khác ở chữ số thập phân thứ tám. Đây là tình huống thật khi hai lần gọi cách nhau vài phút.
Đọc header hạn mức
Trang hạn mức của Yelp liệt kê các header RateLimit-DailyLimit, RateLimit-Remaining và RateLimit-ResetTime, cùng các header theo từng endpoint nếu có. Hàm dưới gom chúng vào một dict để ghi log và quyết định có gọi tiếp hay không.
def quota(headers):
    keys = ["RateLimit-DailyLimit", "RateLimit-Remaining", "RateLimit-ResourceDailyLimit",
            "RateLimit-ResourceRemaining", "RateLimit-ResetTime"]
    return {k: headers.get(k) for k in keys if headers.get(k) is not None}

def can_continue(headers, reserve=50):
    remaining = headers.get("RateLimit-Remaining")
    return remaining is None or int(remaining) > reserve
Tham số reserve giữ lại một phần hạn mức cho việc khác trong ngày, ví dụ làm mới chi tiết những doanh nghiệp quan trọng. Tóm lại, môi trường lab gồm khoá trong biến môi trường, phản hồi mẫu có doanh nghiệp trùng giữa hai truy vấn và hàm đọc hạn mức.
Chống trùng bằng business ID khi crawl Yelp bằng Python
Phần này là ví dụ triển khai do ProxyVN viết, đã chạy với phản hồi mẫu trong lab. Nó gồm hàm phân trang theo offset, hàm chuẩn hoá và hàm lưu có chống trùng. Đầu ra được in để anh em đối chiếu.
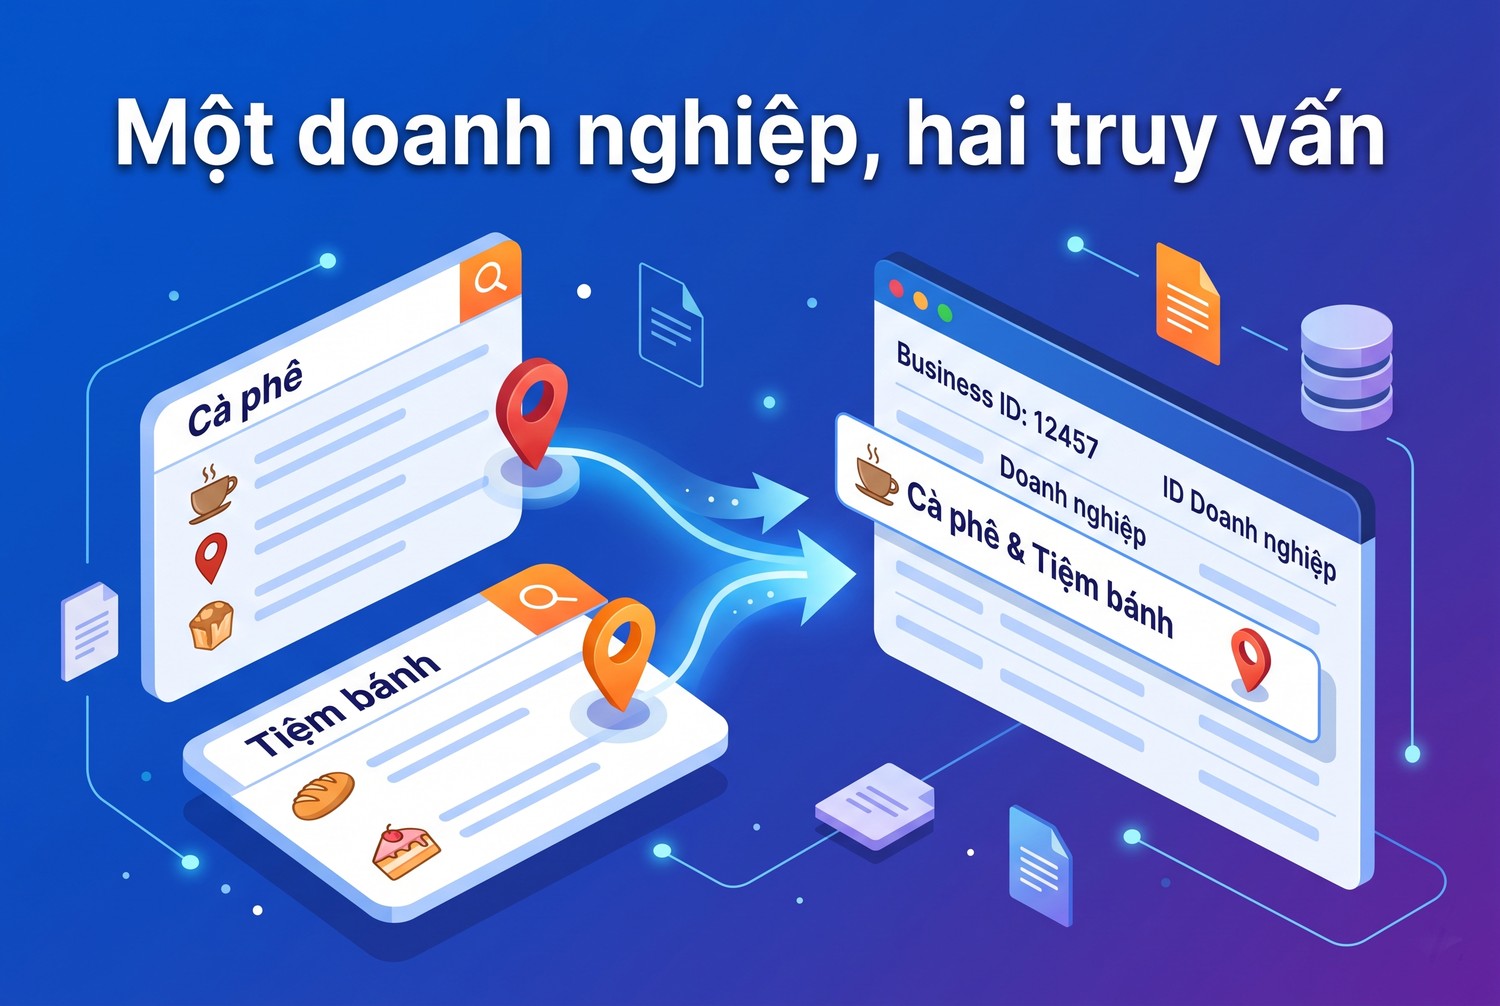
Một doanh nghiệp, hai truy vấn
Phân trang theo offset có trần 240
Hàm search_all gọi lần lượt với offset tăng theo limit. Vòng lặp dừng khi trang trả ít hơn limit, khi offset chạm tổng số kết quả, khi chạm trần 240 theo tài liệu hoặc khi hạn mức còn lại xuống dưới mức dự trữ.
MAX_RESULTS = 240

def search_all(get, params, limit=50, pause=0.5):
    offset, seen = 0, 0
    while offset < MAX_RESULTS:
        page = get({**params, "limit": limit, "offset": offset})
        items = page["json"].get("businesses", [])
        yield from items
        seen += len(items)
        total = min(page["json"].get("total", 0), MAX_RESULTS)
        if len(items) < limit or seen >= total or not can_continue(page["headers"]):
            return
        offset += limit
        time.sleep(pause)

def yelp_get_factory(session, api_key):
    def get(params):
        r = session.get(f"{YELP_BASE}/businesses/search", params=params,
                        headers={"Authorization": f"Bearer {api_key}"}, timeout=(10, 30))
        r.raise_for_status()
        return {"json": r.json(), "headers": r.headers}
    return get
Trần 240 nghĩa là với khu vực đông doanh nghiệp, một truy vấn không thể liệt kê hết. Cách hợp lệ là thu hẹp tiêu chí theo cách người dùng bình thường vẫn làm, ví dụ tách theo ngành con hoặc theo khu phố, và chấp nhận rằng danh mục là mẫu đại diện chứ không phải toàn bộ.
Chuẩn hoá và lưu với khoá id
Hàm normalize_business làm phẳng cấu trúc theo các quy tắc ở phần trước. Hàm save_businesses lưu với khoá chính là business_id và ghi mỗi lần doanh nghiệp xuất hiện trong truy vấn nào vào bảng phụ.
PRICE = {"$": 1, "$$": 2, "$$$": 3, "$$$$": 4}
BIZ_COLS = ["business_id", "alias", "name", "lat", "lon", "address", "city", "zip", "country",
            "categories", "price", "price_level", "rating", "review_count", "is_closed", "fetched_at"]

def normalize_business(b, fetched_at):
    loc, co = b.get("location") or {}, b.get("coordinates") or {}
    return {
        "business_id": b["id"], "alias": b.get("alias", ""),
        "name": " ".join(b.get("name", "").split()),
        "lat": round(float(co.get("latitude") or 0), 5),
        "lon": round(float(co.get("longitude") or 0), 5),
        "address": loc.get("address1") or "", "city": loc.get("city") or "",
        "zip": str(loc.get("zip_code") or ""), "country": loc.get("country") or "",
        "categories": ",".join(sorted(c["alias"] for c in b.get("categories", []))),
        "price": b.get("price") or "", "price_level": PRICE.get(b.get("price") or "", None),
        "rating": b.get("rating"), "review_count": b.get("review_count"),
        "is_closed": int(bool(b.get("is_closed"))), "fetched_at": fetched_at,
    }

def open_places(path="yelp_places.db"):
    con = sqlite3.connect(path)
    con.execute(f"CREATE TABLE IF NOT EXISTS businesses ({', '.join(BIZ_COLS)}, PRIMARY KEY (business_id))")
    con.execute("""CREATE TABLE IF NOT EXISTS business_queries (
        business_id TEXT, query TEXT, seen_at TEXT, PRIMARY KEY (business_id, query))""")
    return con

def save_businesses(con, items, query, fetched_at):
    for b in items:
        row = normalize_business(b, fetched_at)
        con.execute(f"INSERT OR REPLACE INTO businesses VALUES ({', '.join('?' for _ in BIZ_COLS)})",
                    [row[c] for c in BIZ_COLS])
        con.execute("INSERT OR REPLACE INTO business_queries VALUES (?, ?, ?)",
                    (row["business_id"], query, fetched_at))
    con.commit()
INSERT OR REPLACE ghi đè dòng cũ bằng dòng mới nhất. Với dữ liệu địa điểm, giá trị mới nhất là giá trị đúng, nên không cần giữ lịch sử từng lần gọi như với tin nhà đất.
Chạy hai truy vấn với dữ liệu mẫu
Hàm fake_search trả phản hồi mẫu theo ngành và offset. Kịch bản chạy hai truy vấn, rồi in số doanh nghiệp, số lượt xuất hiện và thông tin của doanh nghiệp trùng.
def fake_search_factory(term):
    pages = SEARCH[term]
    def get(params):
        idx = params["offset"] // params["limit"]
        return {"json": pages[idx], "headers": {"RateLimit-Remaining": "4800"}}
    return get

con = open_places(":memory:")
stamp = datetime.now(timezone.utc).isoformat(timespec="seconds")
for term in ["coffee", "bakeries"]:
    items = list(search_all(fake_search_factory(term), {"term": term, "location": "Cambridge, MA"},
                            limit=2, pause=0))
    save_businesses(con, items, term, stamp)
print("Doanh nghiệp:", con.execute("SELECT COUNT(*) FROM businesses").fetchone()[0])
print("Lượt xuất hiện:", con.execute("SELECT COUNT(*) FROM business_queries").fetchone()[0])
print(con.execute("SELECT business_id, categories, lat, lon, review_count FROM businesses "
                  "WHERE business_id='aaa111'").fetchone())
Kết quả lab: ba doanh nghiệp, bốn lượt xuất hiện. Doanh nghiệp aaa111 có ngành "bakeries,coffee" ở cả hai truy vấn nhờ sắp xếp, toạ độ làm tròn còn 42.37362 và -71.10973, số đánh giá 211 từ lần gọi sau. Bộ mẫu dùng limit bằng 2 để kiểm tra vòng phân trang với hai trang.
Tóm lại, chống trùng bằng business ID kết hợp bảng lượt xuất hiện cho anh em vừa danh mục không trùng, vừa biết mỗi doanh nghiệp được tìm thấy qua những truy vấn nào.
Lưu đệm 24 giờ khi crawl Yelp bằng Python
Hướng dẫn của Yelp về lưu đệm tối đa 24 giờ ảnh hưởng trực tiếp tới thiết kế kho dữ liệu. Kho không thể giữ mãi tên, điểm và đoạn trích đánh giá như một cơ sở dữ liệu bình thường. Phần này dựng cơ chế dọn dữ liệu quá hạn mà vẫn giữ business ID.
Bảng đoạn trích có thời điểm lấy
Đoạn trích đánh giá lưu ở bảng riêng, mỗi dòng có thời điểm lấy. Bảng không có cột người viết. Hàm dưới tạo bảng và lưu đoạn trích mẫu cho doanh nghiệp aaa111.
def save_excerpts(con, business_id, reviews, fetched_at):
    con.execute("""CREATE TABLE IF NOT EXISTS review_excerpts (
        business_id TEXT, review_id TEXT, rating INTEGER, text TEXT, time_created TEXT,
        fetched_at TEXT, PRIMARY KEY (business_id, review_id))""")
    for r in reviews[:3]:
        con.execute("INSERT OR REPLACE INTO review_excerpts VALUES (?, ?, ?, ?, ?, ?)",
                    (business_id, r["id"], r["rating"], " ".join(r["text"].split()),
                     r["time_created"], fetched_at))
    con.commit()

REVIEWS = [{"id": "r1", "rating": 5, "text": "Great pastries...", "time_created": "2026-10-20 08:00:00",
            "user": {"name": "Demo U."}},
           {"id": "r2", "rating": 3, "text": "Long line...", "time_created": "2026-10-18 12:00:00",
            "user": {"name": "Demo V."}}]
save_excerpts(con, "aaa111", REVIEWS, "2026-10-21T08:00:00+00:00")
Hàm cắt danh sách còn tối đa ba phần tử, khớp với giới hạn của endpoint. Trường user trong phản hồi mẫu không được ghi vào bảng.
Dọn dữ liệu quá 24 giờ
Hàm purge_expired xoá đoạn trích quá hạn và làm rỗng các trường nội dung của doanh nghiệp quá hạn, chỉ giữ business_id, alias và thời điểm lấy. Lần chạy sau, kịch bản biết doanh nghiệp nào cần lấy lại chi tiết nhờ danh sách id còn giữ.
CONTENT_COLS = ["name", "lat", "lon", "address", "city", "zip", "country", "categories",
                "price", "price_level", "rating", "review_count", "is_closed"]

def purge_expired(con, now, ttl_hours=24):
    cutoff = (now - timedelta(hours=ttl_hours)).isoformat(timespec="seconds")
    n_rev = con.execute("DELETE FROM review_excerpts WHERE fetched_at < ?", (cutoff,)).rowcount
    sets = ", ".join(f"{c}=NULL" for c in CONTENT_COLS)
    n_biz = con.execute(f"UPDATE businesses SET {sets} WHERE fetched_at < ? AND name IS NOT NULL",
                        (cutoff,)).rowcount
    con.commit()
    return n_rev, n_biz

now = datetime.now(timezone.utc) + timedelta(hours=25)
print("Đã dọn (đoạn trích, doanh nghiệp):", purge_expired(con, now))
print("Còn giữ id:", [r[0] for r in con.execute("SELECT business_id FROM businesses ORDER BY 1")])
Lab giả lập thời điểm 25 giờ sau lần lấy. Kết quả: hai đoạn trích bị xoá, ba doanh nghiệp bị làm rỗng nội dung, ba business_id vẫn còn. Lần chạy kế tiếp dùng danh sách id này để gọi Business Details hoặc chạy lại tìm kiếm.
Phân tích trong khuôn khổ 24 giờ
Thời hạn lưu đệm buộc phân tích phải chạy ngay sau khi lấy dữ liệu, hoặc chỉ lưu kết quả tổng hợp không chứa nội dung Yelp. Ví dụ, anh em có thể lưu "số doanh nghiệp cà phê có điểm từ 4 trở lên trong khu vực" theo ngày, vì đây là con số của mình tính ra. Trước khi lưu bất kỳ dạng tổng hợp nào lâu dài, đọc lại điều khoản API để chắc cách dùng nằm trong phạm vi cho phép.
Thời hạn 24 giờ không phải trở ngại kỹ thuật mà là điều kiện thiết kế, đặt ngay từ đầu sẽ rẻ hơn sửa về sau. Tóm lại, lưu đệm đúng hạn gồm bảng có thời điểm lấy, hàm dọn chạy định kỳ và danh sách business ID làm cầu nối giữa các lần chạy.
Đối chiếu danh sách riêng khi crawl Yelp bằng Python
Nhiều dự án không cần liệt kê mọi doanh nghiệp trong khu vực. Họ đã có danh sách khách hàng hoặc đối tác và chỉ cần biết từng cơ sở tương ứng với hồ sơ nào trên Yelp. Endpoint Business Match được thiết kế cho việc này.
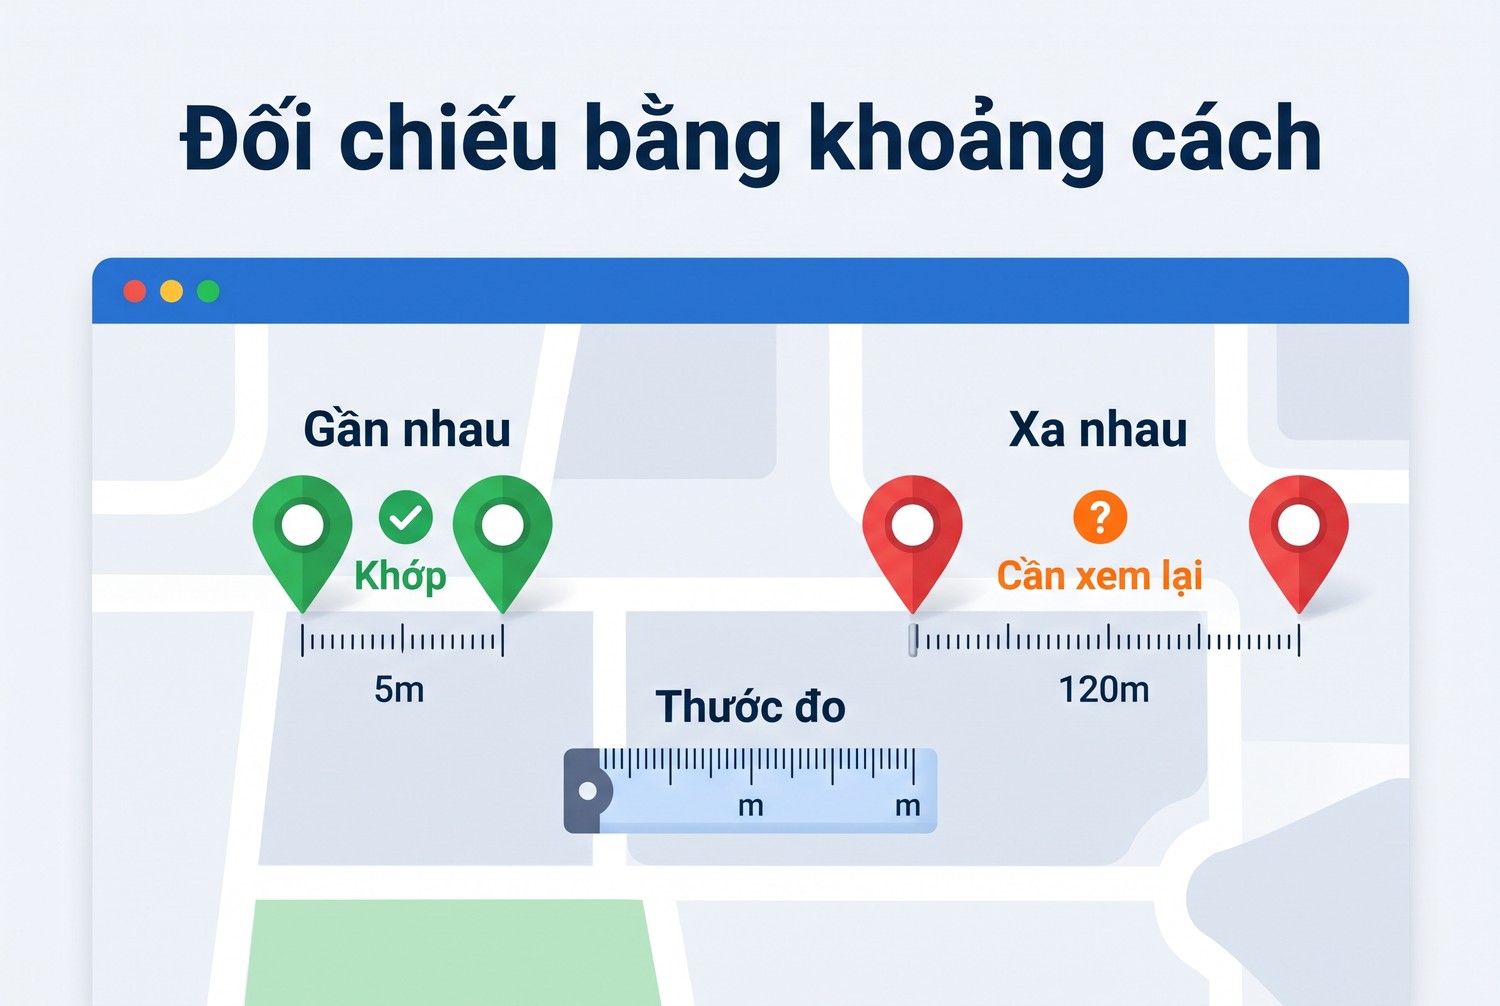
Đối chiếu bằng khoảng cách
Vì sao không dùng tìm kiếm theo tên
Tìm kiếm theo tên dễ trả nhầm chi nhánh khác hoặc doanh nghiệp tên gần giống. Business Match nhận tên, địa chỉ, thành phố, bang và quốc gia, rồi trả về doanh nghiệp khớp với địa điểm chính xác đó. Tài liệu Yelp mô tả endpoint này dùng để khớp dữ liệu doanh nghiệp từ nguồn khác với doanh nghiệp trên Yelp.
Kết quả khớp là business_id, thứ duy nhất anh em được giữ lâu dài theo hướng dẫn lưu đệm. Lưu cặp mã nội bộ và business_id vào bảng đối chiếu, các trường khác lấy lại khi cần.
Bảng đối chiếu và kiểm tra khoảng cách
Khi đã có business_id và toạ độ, anh em kiểm tra chéo bằng khoảng cách tới toạ độ trong dữ liệu nội bộ. Khớp cách xa vài trăm mét là dấu hiệu khớp nhầm chi nhánh.
from math import radians, sin, cos, asin, sqrt

def distance_m(lat1, lon1, lat2, lon2):
    dlat, dlon = radians(lat2 - lat1), radians(lon2 - lon1)
    a = sin(dlat / 2) ** 2 + cos(radians(lat1)) * cos(radians(lat2)) * sin(dlon / 2) ** 2
    return 2 * 6371000 * asin(sqrt(a))

def check_match(internal, matched, max_m=150):
    d = distance_m(internal["lat"], internal["lon"], matched["lat"], matched["lon"])
    return {"internal_id": internal["id"], "business_id": matched["business_id"],
            "distance_m": round(d), "ok": d <= max_m}

print(check_match({"id": "KH-01", "lat": 42.3737, "lon": -71.1098},
                  {"business_id": "aaa111", "lat": 42.37362, "lon": -71.10973}))
print(check_match({"id": "KH-02", "lat": 42.3800, "lon": -71.1000},
                  {"business_id": "bbb222", "lat": 42.36, "lon": -71.10}))
Cặp đầu cách nhau khoảng 11 mét, đánh dấu khớp. Cặp sau cách khoảng 2,2 km, đánh dấu cần xem lại. Ngưỡng 150 mét là điểm khởi đầu, khu trung tâm đông đúc có thể cần ngưỡng nhỏ hơn.
Khi nào dùng tìm kiếm, khi nào dùng đối chiếu
Tìm kiếm phù hợp khi câu hỏi là "có những ai trong khu vực". Đối chiếu phù hợp khi câu hỏi là "cơ sở của tôi là hồ sơ nào". Phần lớn dự án nội bộ thuộc loại thứ hai và tốn ít lượt gọi hơn nhiều. Với danh sách vài trăm cơ sở, anh em chạy đối chiếu một lần rồi chỉ chạy lại cho cơ sở mới hoặc cơ sở đổi địa chỉ. Bảng đối chiếu chỉ chứa mã nội bộ, business_id và kết quả kiểm tra khoảng cách, nên giữ lâu dài được theo hướng dẫn lưu đệm.
Tóm lại, Business Match kèm kiểm tra khoảng cách là cách gọn nhất để nối danh sách riêng với Yelp.
Xử lý lỗi khi crawl Yelp bằng Python
Lỗi với Yelp Places API chủ yếu xoay quanh khoá, hạn mức và tham số tìm kiếm. Tài liệu ghi mã lỗi và thông báo đi kèm khá rõ. Danh sách dưới gom các lỗi hay gặp và hướng xử lý.
Mã lỗi thường gặp
Mỗi dòng ghi mã, nguyên nhân thường gặp và cách sửa. Với lỗi hạn mức, cách sửa luôn là giảm số lượt gọi hoặc nâng gói.
- 400: tham số sai, ví dụ thiếu cả location lẫn toạ độ, hoặc offset cộng limit vượt giới hạn.
- 401: khoá hết hạn hoặc không hợp lệ; tạo khoá mới trong trang quản lý ứng dụng.
- 403: khoá không có quyền với endpoint; kiểm tra gói dịch vụ.
- 429 với mã ACCESS_LIMIT_REACHED: hết hạn mức ngày; chờ tới RateLimit-ResetTime.
- 429 do số lượt mỗi giây: gọi quá nhanh; tăng khoảng nghỉ giữa các lần gọi.
Trang hạn mức của Yelp cho biết lượt gọi thêm được cấp dựa trên lưu lượng người dùng thật, thường sau khi sản phẩm ra mắt, qua email gửi bộ phận cấp phép dữ liệu. Đây là đường hợp lệ khi dự án cần nhiều hơn.
Lỗi dữ liệu
Doanh nghiệp đóng cửa vẫn có thể xuất hiện với is_closed bằng true. Kịch bản giữ trường này để lọc khi phân tích, không xoá dòng. Toạ độ bằng 0 thường là dữ liệu thiếu, cần đánh dấu thay vì đưa vào bản đồ.
Ghi log có ích
Mỗi lượt gọi ghi tham số tìm kiếm, offset, số kết quả, giá trị RateLimit-Remaining và mã trạng thái. Không ghi header Authorization. Khi một truy vấn cho ít kết quả bất thường, log giúp biết đó là do khu vực ít doanh nghiệp hay do tham số sai.
Một lỗi khó thấy hơn là truy vấn trả đúng 240 kết quả. Con số này trùng với trần của endpoint, nghĩa là rất có thể còn doanh nghiệp phù hợp chưa được liệt kê. Kịch bản nên ghi cờ cho mọi truy vấn chạm trần, để người phân tích biết danh mục của khu vực đó là mẫu chưa đầy đủ. Khi cần độ phủ tốt hơn, tách truy vấn theo ngành con hoặc khu phố nhỏ hơn rồi chạy lại.
Tóm lại, xử lý lỗi Yelp API là đọc đúng header hạn mức, phân biệt hai kiểu 429 và giữ log đủ để tái hiện mỗi truy vấn.
Khi nào cần proxy cho crawl Yelp bằng Python
Hạn mức của Yelp Places API gắn với khoá và ứng dụng, không với IP. Proxy không làm tăng số lượt gọi, và dùng nhiều IP để lách hạn mức đi ngược hướng dẫn của Yelp. Phần lớn dự án gọi API trực tiếp từ máy chủ là đủ.
Tình huống proxy có ích
Tình huống phổ biến nhất là mạng công ty bắt buộc đi qua proxy để ra Internet. Khi đó, khai báo proxy trong Session riêng, tắt trust_env để cấu hình rõ ràng. Tình huống thứ hai là đội ở Việt Nam muốn có IP cố định cho máy chủ gọi API, thuận tiện khi đối tác dữ liệu hay đội bảo mật yêu cầu danh sách IP được phép.
Tình huống thứ ba là kiểm tra thủ công cách hồ sơ doanh nghiệp hiển thị trên Yelp với người xem ở Mỹ, ví dụ khi đội marketing cần chụp màn hình hồ sơ khách hàng. Đây là thao tác của người, không phải kịch bản. Bài proxy local SEO trên blog ProxyVN bàn thêm về việc xem kết quả theo địa phương.
Tình huống không dùng proxy
Không dùng proxy xoay để đọc trang Yelp, không dùng để chạy nhiều khoá song song nhằm vượt hạn mức ngày. Điều khoản dịch vụ cấm thu thập tự động từ trang, và trang hạn mức đã chỉ ra đường hợp lệ khi cần thêm lượt gọi.
Với Yelp, hạn mức là thoả thuận giữa anh em và nền tảng. Cách mở rộng đúng là chứng minh nhu cầu thật để được cấp thêm, không phải nhân bản IP.
Gói phù hợp
Nếu cần IP cố định cho máy chủ, anh em có thể mua proxy Việt Nam dạng datacenter hoặc dân cư tĩnh trên trang chủ ProxyVN, hoặc chọn datacenter US khi máy chủ phân tích đặt ở Mỹ. Kiểm tra IP đi ra trước khi khai báo với bất kỳ bên nào. Với nghiên cứu theo khu vực nói chung, bài proxy nghiên cứu thị trường có thêm gợi ý.
Tóm lại, proxy trong dự án Yelp là chuyện hạ tầng mạng và kiểm tra hiển thị thủ công, không liên quan tới việc lấy thêm dữ liệu.
Checklist trước khi crawl Yelp bằng Python chạy thật
Danh sách dưới gom các bước trong bài thành việc cần kiểm tra trước khi để kịch bản chạy định kỳ. Anh em chia theo ba nhóm để dễ phân công.
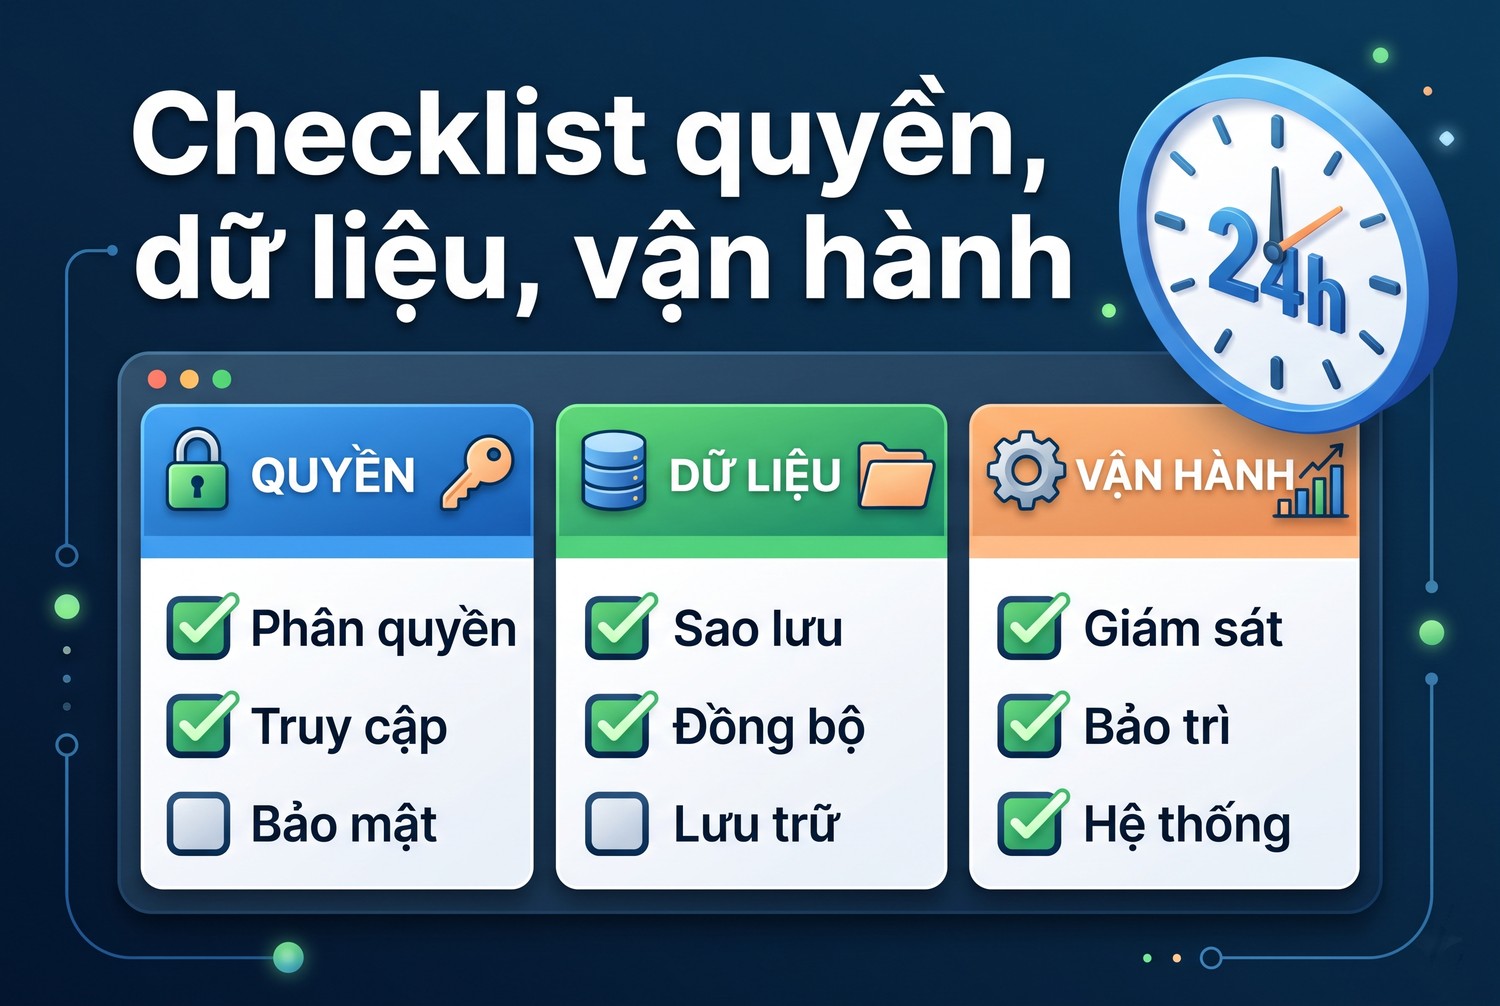
Checklist quyền, dữ liệu, vận hành
Nhóm quyền và điều khoản
Nhóm này xác định dự án đứng trên nền hợp lệ. Rà lại khi Yelp cập nhật điều khoản hay gói dịch vụ.
- Đã đọc điều khoản dịch vụ Yelp và điều khoản API, ghi ngày đọc.
- Chỉ dùng Places API với khoá riêng, không đọc trang Yelp.
- Không lưu thông tin người viết đánh giá.
- Đã xem quy định hiển thị nếu dữ liệu được đưa lên giao diện cho người khác xem.
Nhóm dữ liệu
Nhóm này đảm bảo danh mục không trùng và đúng hạn lưu. Mỗi mục tương ứng một khối code trong bài.
- Khoá chính là business_id, alias chỉ để hiển thị.
- Ngành được sắp xếp, toạ độ làm tròn trước khi lưu.
- Bảng business_queries ghi truy vấn đã tìm thấy doanh nghiệp.
- Hàm purge_expired chạy định kỳ với thời hạn 24 giờ.
- Đối chiếu danh sách riêng có kiểm tra khoảng cách.
Nhóm vận hành
Nhóm cuối giúp kịch bản chạy đều trong hạn mức. Xem lại sau tuần đầu.
- Đọc RateLimit-Remaining sau mỗi lượt gọi, có mức dự trữ.
- Phân trang dừng ở trần 240 hoặc khi hết kết quả.
- Log không chứa khoá API.
Kết luận cho checklist: kịch bản Yelp tốt là kịch bản tôn trọng thời hạn lưu đệm và hạn mức như một phần của thiết kế, không phải ràng buộc cần lách.
Crawl Yelp bằng Python đúng cách là gọi Yelp Places API với khoá riêng, chuẩn hoá địa điểm, chống trùng bằng business ID và dọn dữ liệu quá 24 giờ. Đọc điều khoản trước khi gọi API. Cần IP cố định cho máy chủ, anh em nhắn Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam trước khi crawl Yelp bằng Python.


