
Crawl TripAdvisor bằng Python: Content API và chuẩn hoá đánh giá
Crawl TripAdvisor bằng Python là cách nhiều đội marketing du lịch muốn dùng để đọc đánh giá khách về khách sạn, nhà hàng hay điểm tham quan. Điều khoản của TripAdvisor cấm thu thập tự động nếu chưa có văn bản cho phép, nhưng họ có Content API riêng cho việc này. Bài này, ProxyVN hướng dẫn gọi API, chuẩn hoá đánh giá đa ngôn ngữ, chống trùng và tổng hợp điểm theo tháng.
Mục tiêu và phạm vi của crawl TripAdvisor bằng Python
Đánh giá trên TripAdvisor là nguồn phản hồi khách hàng lớn của ngành du lịch. Một khách sạn muốn biết khách phàn nàn gì nhiều nhất, một chuỗi nhà hàng muốn so điểm giữa các chi nhánh, một sở du lịch muốn theo dõi cảm nhận về điểm đến. Mỗi mục tiêu cần một cách gom và tổng hợp khác nhau.
Câu hỏi nên trả lời được
Trước khi viết code, anh em ghi ra các câu hỏi cụ thể. Ví dụ: điểm trung bình theo tháng của năm cơ sở có xu hướng tăng hay giảm, tỷ lệ đánh giá một và hai sao của từng cơ sở là bao nhiêu, khách nói tiếng Anh và tiếng Hàn chấm điểm khác nhau thế nào. Câu hỏi càng rõ, danh sách trường cần lấy càng ngắn.
Với phần lớn câu hỏi quản trị, anh em không cần toàn bộ lịch sử đánh giá. Những đánh giá gần đây, cập nhật đều đặn và tổng hợp đúng cách đủ để thấy xu hướng. Đây cũng đúng là kiểu dữ liệu mà Content API cung cấp.
Ranh giới với bài chọn proxy khách sạn
Blog ProxyVN đã có bài về proxy đặt phòng khách sạn, tập trung vào việc xem giá phòng theo khu vực. Bài này không bàn chuyện đó. Ở đây, trọng tâm là dữ liệu đánh giá: lấy qua kênh nào, chuẩn hoá ra sao, lưu và tổng hợp thế nào.
Bài cũng không hướng dẫn đọc trang đánh giá hàng loạt, không vượt CAPTCHA và không lưu hồ sơ người viết đánh giá. Đánh giá là ý kiến của khách, còn hồ sơ người viết là dữ liệu cá nhân, hai thứ được đối xử khác nhau. Tóm lại, crawl TripAdvisor bằng Python trong bài là xây một kho đánh giá gọn, có nguồn rõ, phục vụ câu hỏi quản trị cụ thể.
Điều kiện truy cập khi crawl TripAdvisor bằng Python
Trước khi gửi request đầu tiên, anh em cần biết TripAdvisor cho phép gì. Văn bản điều khoản và tài liệu API trả lời câu hỏi này rõ ràng. Phần này trích những điểm quan trọng nhất ProxyVN đọc được ngày 23/10/2026.
Kênh API thay vì đọc trang
Điều khoản sử dụng website
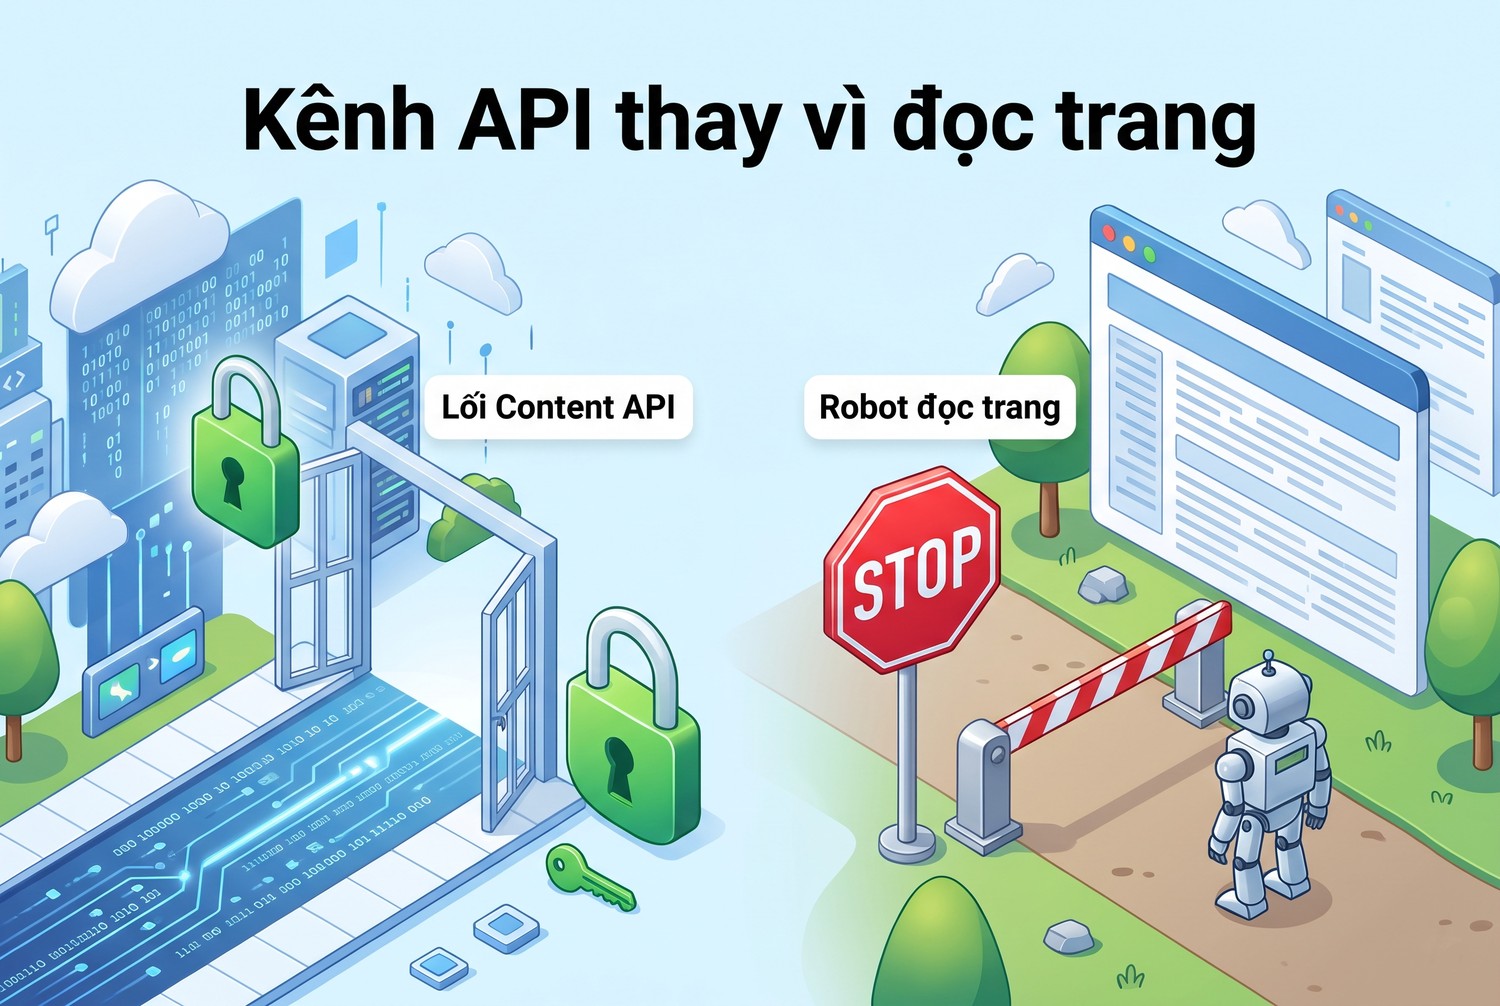
Điều khoản sử dụng của TripAdvisor có nhiều mục liên quan tới truy cập tự động. Một mục cấm truy cập, theo dõi, sao chép hay khai thác nội dung dịch vụ, kể cả hồ sơ và ảnh người dùng, bằng robot, spider, scraper hay phương tiện tự động khác nếu không có văn bản cho phép. Một mục khác cấm vi phạm chỉ dẫn robot exclusion hoặc vượt qua các biện pháp giới hạn truy cập.
Bản điều khoản hiện hành còn nhắc rõ hệ thống trí tuệ nhân tạo trong danh sách phương tiện tự động bị cấm khi chưa được cho phép bằng văn bản. Điều này có nghĩa là dùng agent AI duyệt web để gom đánh giá cũng nằm trong phạm vi hạn chế, không chỉ kịch bản Python truyền thống.
Content API là kênh chính thức
TripAdvisor cung cấp Content API cho đối tác muốn hiển thị nội dung của họ. Tài liệu endpoint Location Reviews mô tả request tới đường dẫn /api/v1/location/{locationId}/reviews trên máy chủ api.content.tripadvisor.com, với tham số key là khoá API đối tác, language để chọn ngôn ngữ, cùng limit và offset.
Tài liệu ghi endpoint này trả tối đa 5 đánh giá gần nhất cho một địa điểm, và giới hạn có thể khác với gói thử nghiệm. Đây là con số cần biết trước khi thiết kế: Content API phục vụ hiển thị đánh giá mới, không phải tải toàn bộ lịch sử. Endpoint Location Search trả tối đa 10 địa điểm cho mỗi truy vấn, lọc được theo nhóm khách sạn, điểm tham quan, nhà hàng hoặc khu vực.
Hệ quả cho thiết kế
Vì mỗi lần gọi chỉ có vài đánh giá mới nhất, cách duy nhất để có chuỗi dữ liệu dài là gọi định kỳ và tích luỹ. Một cơ sở nhận vài đánh giá mỗi tuần, gọi mỗi ngày là đủ bắt gần như mọi đánh giá mới. Cơ sở đông khách hơn có thể cần gọi dày hơn, trong phạm vi hạn mức của gói API.
Bảng dưới so sánh các đường tiếp cận dữ liệu đánh giá TripAdvisor. Các con số lấy từ tài liệu và điều khoản ngày 23/10/2026.
Đường tiếp cận |
Phạm vi |
Điều kiện |
Phù hợp |
|---|---|---|---|
Content API, Location Reviews |
Tối đa 5 đánh giá gần nhất mỗi địa điểm |
Khoá API đối tác, theo điều khoản API |
Theo dõi đánh giá mới |
Content API, Location Search |
Tối đa 10 địa điểm mỗi truy vấn |
Khoá API đối tác |
Tìm locationId |
Đọc trang website |
Không giới hạn kỹ thuật |
Bị cấm nếu không có văn bản cho phép |
Không dùng |
Dữ liệu chủ cơ sở tự xuất |
Đánh giá về cơ sở của mình |
Theo công cụ quản lý của nền tảng |
Phân tích nội bộ |
Kết lại, crawl TripAdvisor bằng Python một cách hợp lệ là dùng Content API với khoá đối tác, chấp nhận giới hạn vài đánh giá mỗi lần gọi và tích luỹ theo thời gian.
Chuẩn hoá đánh giá khi crawl TripAdvisor bằng Python
Đánh giá du lịch có ba đặc thù làm việc chuẩn hoá khó hơn dữ liệu thông thường: nhiều ngôn ngữ, nhiều định dạng ngày và nhiều thang điểm khi gộp với nguồn khác. Schema tốt phải xử lý cả ba ngay từ đầu.
Schema một đánh giá
Schema dưới giữ đúng những gì cần cho phân tích và loại bỏ thông tin nhận diện người viết. Mỗi trường có lý do tồn tại cụ thể.
- review_id: mã đánh giá gốc, khoá chính cùng với tên nguồn.
- location_id: mã địa điểm trên TripAdvisor, dùng để nối với bảng cơ sở.
- published_date: ngày đăng dạng năm-tháng-ngày theo UTC.
- language: mã ngôn ngữ hai chữ cái của đánh giá.
- rating: điểm nguyên từ 1 tới 5, score_norm: điểm quy về khoảng 0 tới 1.
- title, text: tiêu đề và nội dung đã gộp khoảng trắng.
- trip_type: loại chuyến đi nếu có, ví dụ gia đình, công tác, cặp đôi.
- text_hash: mã băm nội dung để phát hiện đánh giá trùng nội dung.
- url: đường dẫn tới đánh giá gốc để người đọc báo cáo kiểm tra.
Danh sách cố ý không có tên người dùng, ảnh đại diện hay quê quán người viết. Nếu phản hồi API có các trường này, kịch bản bỏ qua chúng ngay ở bước chuẩn hoá.
Thang điểm chung khi gộp nguồn
TripAdvisor dùng thang 1 tới 5. Khi gộp với nguồn khác như khảo sát nội bộ thang 1 tới 10, anh em cần một thang chung. Công thức đơn giản là trừ điểm thấp nhất rồi chia cho khoảng thang điểm. Với thang 1 tới 5, điểm 4 thành 0,75, điểm 1 thành 0 và điểm 5 thành 1.
Cách quy đổi tuyến tính này giả định khoảng cách giữa các mức điểm đều nhau, điều không hẳn đúng với hành vi chấm điểm thật. Anh em nên giữ cả điểm gốc lẫn điểm quy đổi, và chỉ dùng điểm quy đổi khi thật sự cần so giữa các nguồn.
Ngôn ngữ là một chiều phân tích
Tham số language của API cho phép lấy đánh giá theo từng ngôn ngữ. Với điểm đến có nhiều khách quốc tế, chia theo ngôn ngữ cho thấy những khác biệt mà điểm trung bình chung che mất. Khách nói tiếng Anh có thể phàn nàn về tốc độ phục vụ, khách nói tiếng Hàn quan tâm nhiều hơn tới vệ sinh.
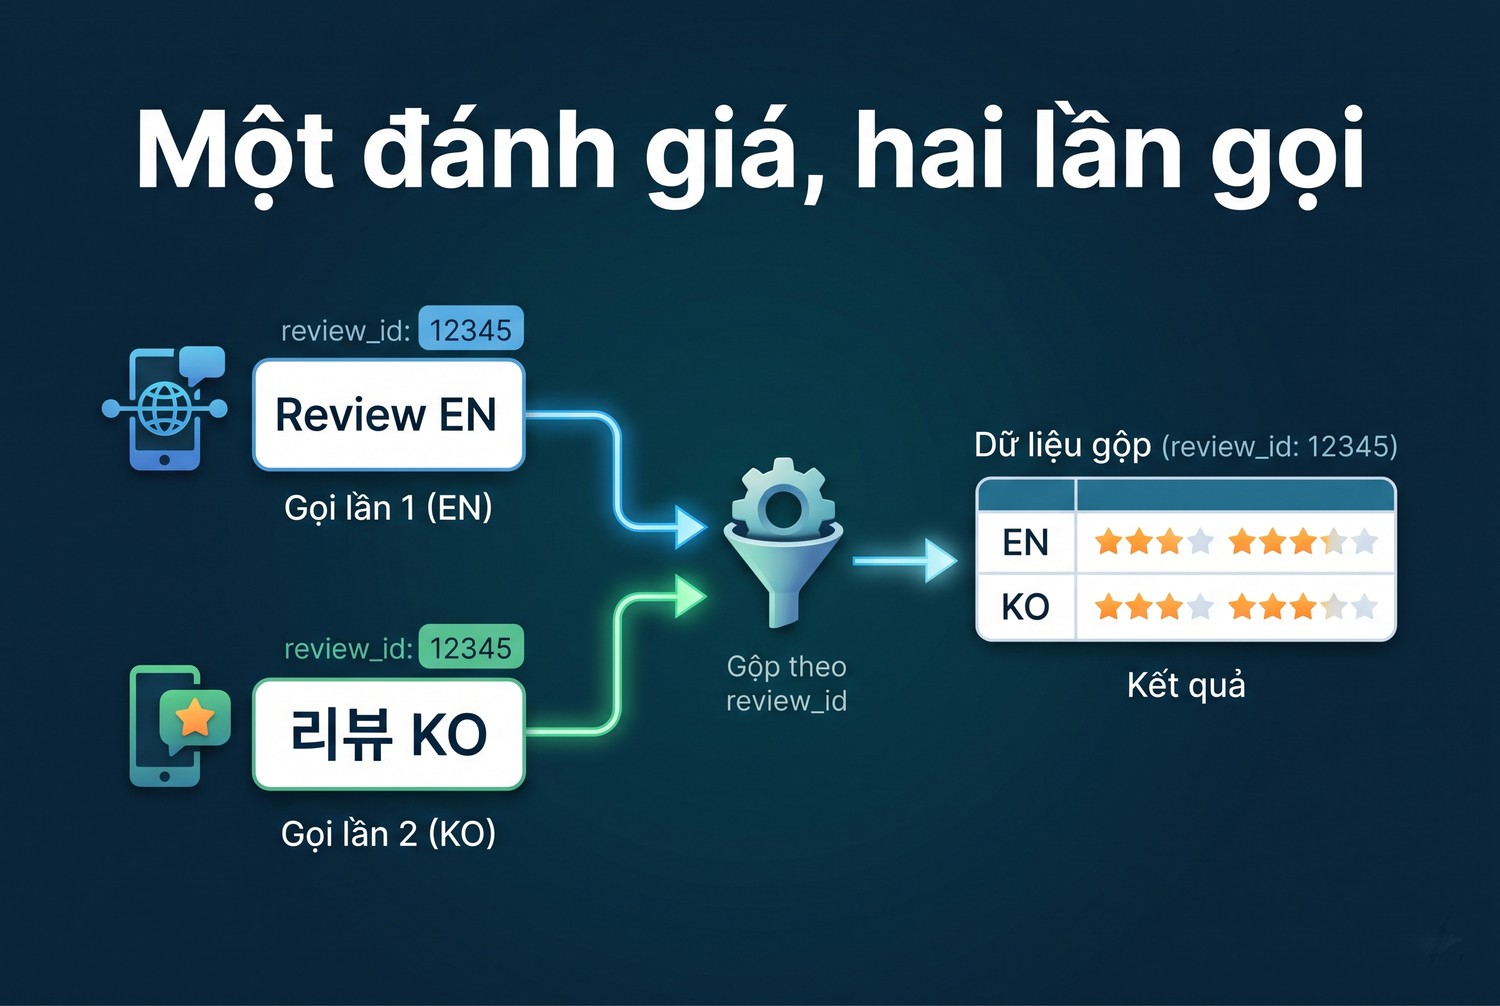
Khi gọi API với nhiều ngôn ngữ, một số đánh giá có thể xuất hiện ở nhiều lần gọi, tuỳ cách nền tảng xử lý bản dịch. Khoá review_id giúp gộp các lần xuất hiện này thành một dòng. Tóm lại, schema tốt cho đánh giá du lịch giữ điểm gốc, điểm quy đổi, ngôn ngữ và mã băm nội dung, đồng thời loại bỏ thông tin người viết.
Chuẩn bị môi trường cho crawl TripAdvisor bằng Python
Lab dùng Python 3.12 với Requests để gọi API và sqlite3 để lưu. Toàn bộ ví dụ chạy với phản hồi mẫu đặt trong code, mô phỏng hai lần gọi theo hai ngôn ngữ. Khi có khoá API, anh em thay hàm gọi giả bằng hàm gọi thật.
Cài đặt và khoá API
Khoá API đối tác lấy từ tài khoản Content API sau khi đăng ký và được chấp thuận. Khoá đặt trong biến môi trường. Khi ProxyVN dựng lab, phiên bản Requests là 2.34.2 trên Python 3.12.10.
python -m venv .venv
.\.venv\Scripts\Activate.ps1
python -m pip install requests
$env:TA_API_KEY = 'YOUR_PARTNER_KEY'
Tài liệu Content API dùng tham số key trên URL để xác thực. Vì vậy, anh em cần đặc biệt cẩn thận với log: URL đầy đủ chứa khoá, nên mọi chỗ ghi URL phải che tham số key trước.
Phản hồi mẫu
Lab tạo phản hồi mẫu theo dạng danh sách đánh giá với các trường thường gặp: id, ngôn ngữ, ngày đăng, điểm, tiêu đề, nội dung, loại chuyến đi, đường dẫn và thông tin người dùng. Tên trường thật cần đối chiếu với phản hồi API khi anh em có khoá, vì bài không gọi API thật.
import os
import re
import json
import time
import hashlib
import sqlite3
from datetime import datetime, timezone
import requests

TA_BASE = "https://api.content.tripadvisor.com/api/v1"

SAMPLE = {
    "en": {"data": [
        {"id": 9001, "lang": "en", "location_id": 777, "published_date": "2026-10-20T08:12:00Z",
         "rating": 4, "title": "Great view ", "text": "Lovely  rooftop, slow check-in.",
         "trip_type": "Couples", "url": "https://www.tripadvisor.com/demo-9001",
         "user": {"username": "traveler_abc", "user_location": {"name": "Seoul"}}},
        {"id": 9002, "lang": "en", "location_id": 777, "published_date": "2026-09-30T23:40:00Z",
         "rating": 2, "title": "Noisy", "text": "Street noise all night.",
         "trip_type": "Business", "url": "https://www.tripadvisor.com/demo-9002",
         "user": {"username": "trip_xyz"}}]},
    "ko": {"data": [
        {"id": 9003, "lang": "ko", "location_id": 777, "published_date": "2026-10-18T02:00:00Z",
         "rating": 5, "title": "깨끗해요", "text": "방이 깨끗하고 직원이 친절해요.",
         "trip_type": "Family", "url": "https://www.tripadvisor.com/demo-9003",
         "user": {"username": "kim_demo"}},
        {"id": 9001, "lang": "en", "location_id": 777, "published_date": "2026-10-20T08:12:00Z",
         "rating": 4, "title": "Great view", "text": "Lovely rooftop, slow check-in.",
         "trip_type": "Couples", "url": "https://www.tripadvisor.com/demo-9001",
         "user": {"username": "traveler_abc"}}]},
}
Phản hồi tiếng Hàn cố ý chứa lại đánh giá 9001 với khoảng trắng khác, để kiểm tra bước chống trùng. Toàn bộ nội dung, id và tên người dùng trong mẫu là giả lập.
Hàm gọi API thật
Hàm fetch_reviews nhận hàm get để dễ thay bằng dữ liệu mẫu. Mỗi ngôn ngữ một lần gọi, có khoảng nghỉ giữa các lần. Khi gặp mã 429, hàm chờ theo header Retry-After nếu có.
def ta_get_factory(session, api_key):
    def get(location_id, language):
        r = session.get(f"{TA_BASE}/location/{location_id}/reviews",
                        params={"key": api_key, "language": language},
                        headers={"accept": "application/json"}, timeout=(10, 30))
        if r.status_code == 429:
            time.sleep(int(r.headers.get("Retry-After", 60)))
            return {"data": []}
        r.raise_for_status()
        return r.json()
    return get

def fetch_reviews(get, location_id, languages, pause=1.0):
    for lang in languages:
        payload = get(location_id, lang)
        for item in payload.get("data", []):
            yield lang, item
        time.sleep(pause)

def mask_key(url):
    return re.sub(r"(key=)[^&]+", r"\1***", url)
Hàm mask_key che khoá trong URL trước khi ghi log. Tóm lại, môi trường lab gồm khoá trong biến môi trường, phản hồi mẫu có đánh giá trùng giữa hai ngôn ngữ và hàm gọi tách khỏi phần xử lý.
Ví dụ tối thiểu crawl TripAdvisor bằng Python
Phần này ghép các bước thành một lần chạy hoàn chỉnh: gọi theo hai ngôn ngữ, chuẩn hoá, chống trùng, lưu SQLite. Đây là ví dụ triển khai do ProxyVN viết, đã chạy với phản hồi mẫu trong lab. Mỗi khối có đầu ra để anh em đối chiếu.
Một đánh giá, hai lần gọi
Hàm chuẩn hoá một đánh giá
Hàm normalize_review chỉ giữ các trường trong schema. Điểm được ép về số nguyên và kiểm tra nằm trong khoảng 1 tới 5. Mã băm nội dung tính trên tiêu đề và nội dung đã gộp khoảng trắng, chữ thường, để hai bản khác nhau về khoảng trắng cho cùng mã.
def clean(s):
    return " ".join(str(s or "").split())

def normalize_review(item, requested_lang):
    rating = int(item.get("rating") or 0)
    if not 1 <= rating <= 5:
        raise ValueError(f"rating ngoài thang 1-5: {rating}")
    title, text = clean(item.get("title")), clean(item.get("text"))
    published = datetime.fromisoformat(item["published_date"].replace("Z", "+00:00"))
    return {
        "source": "tripadvisor",
        "review_id": str(item["id"]),
        "location_id": str(item.get("location_id", "")),
        "published_date": published.astimezone(timezone.utc).date().isoformat(),
        "language": item.get("lang") or requested_lang,
        "rating": rating,
        "score_norm": round((rating - 1) / 4, 3),
        "title": title,
        "text": text,
        "trip_type": clean(item.get("trip_type")),
        "text_hash": hashlib.sha1(f"{title}|{text}".lower().encode("utf-8")).hexdigest()[:16],
        "url": item.get("url", ""),
    }
Trường user trong phản hồi không được đọc. Đây là cách đơn giản nhất để chắc kho dữ liệu không chứa tên người dùng: không chép nó ngay từ đầu, thay vì chép rồi mới xoá.
Lưu với khoá nguồn và review_id
Bảng reviews có khoá chính là cặp nguồn và review_id. Bảng phụ review_seen ghi mỗi lần một đánh giá xuất hiện trong một lần gọi theo ngôn ngữ nào, giúp đánh giá sau này ngôn ngữ nào đáng gọi.
REV_COLS = ["source", "review_id", "location_id", "published_date", "language", "rating",
            "score_norm", "title", "text", "trip_type", "text_hash", "url"]

def open_reviews(path="reviews.db"):
    con = sqlite3.connect(path)
    con.execute(f"CREATE TABLE IF NOT EXISTS reviews ({', '.join(REV_COLS)}, "
                "first_seen TEXT, PRIMARY KEY (source, review_id))")
    con.execute("""CREATE TABLE IF NOT EXISTS review_seen (
        source TEXT, review_id TEXT, requested_lang TEXT, seen_at TEXT,
        PRIMARY KEY (source, review_id, requested_lang))""")
    return con

def store(con, pairs, seen_at):
    inserted = 0
    for lang, item in pairs:
        r = normalize_review(item, lang)
        cur = con.execute(f"INSERT OR IGNORE INTO reviews VALUES ({', '.join('?' for _ in REV_COLS)}, ?)",
                          [r[c] for c in REV_COLS] + [seen_at])
        inserted += cur.rowcount
        con.execute("INSERT OR REPLACE INTO review_seen VALUES (?, ?, ?, ?)",
                    (r["source"], r["review_id"], lang, seen_at))
    con.commit()
    return inserted

def fake_get(location_id, language):
    return SAMPLE.get(language, {"data": []})

con = open_reviews(":memory:")
n = store(con, fetch_reviews(fake_get, 777, ["en", "ko"], pause=0), "2026-10-23T09:00:00+00:00")
print("Đánh giá mới:", n)
print("Lượt xuất hiện:", con.execute("SELECT COUNT(*) FROM review_seen").fetchone()[0])
print(con.execute("SELECT review_id, language, rating, score_norm FROM reviews ORDER BY review_id").fetchall())
Kết quả lab: bốn lượt xuất hiện nhưng chỉ ba đánh giá mới. Đánh giá 9001 xuất hiện ở cả lần gọi tiếng Anh lẫn tiếng Hàn, được lưu một lần với ngôn ngữ gốc en. Điểm quy đổi của ba đánh giá là 0,75, 0,25 và 1.
Chạy lại không sinh dòng trùng
Gọi store thêm một lần với cùng dữ liệu, số đánh giá mới trả về là 0 vì INSERT OR IGNORE bỏ qua khoá đã có, đúng như tài liệu xử lý xung đột của SQLite mô tả. Đây là hành vi mong muốn khi kịch bản chạy mỗi ngày: chỉ đánh giá thật sự mới được thêm. Tóm lại, ví dụ tối thiểu cho thấy chuẩn hoá loại thông tin người viết, khoá review_id gộp trùng giữa các ngôn ngữ và chạy lại an toàn.
Phân trang và lịch gọi khi crawl TripAdvisor bằng Python
Với Content API, phân trang không phải bài toán lớn vì mỗi lần gọi chỉ trả vài đánh giá. Bài toán thật là lịch gọi: gọi bao lâu một lần để không bỏ sót đánh giá mới mà vẫn trong hạn mức. Phần này tính toán điều đó bằng dữ liệu của chính anh em.
Limit và offset trong tài liệu
Tài liệu endpoint Location Reviews có tham số limit và offset. Tuy vậy, giới hạn tối đa 5 đánh giá gần nhất vẫn áp dụng theo mô tả của endpoint, và giới hạn của gói thử nghiệm có thể thấp hơn. ProxyVN chưa có khoá để kiểm tra hành vi của offset, nên khuyên anh em thử trực tiếp với gói của mình trước khi xây logic phân trang.
Nếu offset hoạt động trong phạm vi 5 đánh giá, một lần gọi không offset đã đủ. Nếu gói của anh em cho giới hạn cao hơn, vòng lặp tăng offset theo limit cho tới khi nhận trang rỗng là cách phân trang chuẩn. Code xử lý cả hai trường hợp chỉ khác nhau một vòng lặp.
Ước lượng tần suất gọi từ dữ liệu
Cách hợp lý là đo tốc độ đánh giá mới của từng cơ sở. Hàm dưới tính số ngày trung bình giữa các đánh giá liên tiếp trong kho, rồi đề xuất khoảng gọi sao cho mỗi lần gọi thường nhận ít hơn 5 đánh giá mới.
def suggest_interval_days(con, location_id, per_call=5, safety=0.5):
    dates = [datetime.fromisoformat(d) for (d,) in con.execute(
        "SELECT published_date FROM reviews WHERE location_id=? ORDER BY published_date",
        (str(location_id),))]
    if len(dates) < 2:
        return 1
    span = (dates[-1] - dates[0]).days or 1
    per_day = (len(dates) - 1) / span
    return max(1, int(per_call / per_day * safety)) if per_day else 7

print("Khoảng gọi đề xuất (ngày):", suggest_interval_days(con, 777))
Với ba đánh giá mẫu trải trong 20 ngày, tốc độ là 0,1 đánh giá mỗi ngày, hàm đề xuất gọi mỗi 25 ngày. Con số này chỉ minh hoạ cách tính. Trong thực tế, ProxyVN khuyên giữ khoảng gọi tối đa vài ngày kể cả với cơ sở ít đánh giá, vì đánh giá tiêu cực cần được thấy sớm.
Hệ số an toàn
Tham số safety bằng 0,5 nghĩa là gọi dày gấp đôi mức tối thiểu tính được. Lý do là đánh giá không đến đều: mùa cao điểm, sự kiện hay một sự cố có thể làm số đánh giá tăng vọt trong vài ngày. Bỏ sót đánh giá vì gọi quá thưa khó phát hiện hơn nhiều so với tốn thêm vài lượt gọi.
Tóm lại, với Content API, lịch gọi quan trọng hơn phân trang. Đo tốc độ đánh giá thật của từng cơ sở rồi đặt khoảng gọi có hệ số an toàn.
Tổng hợp và kiểm tra đầu ra khi crawl TripAdvisor bằng Python
Kho đánh giá chỉ có giá trị khi được tổng hợp thành con số người quản lý đọc được. Phần này dựng bảng điểm theo tháng và ngôn ngữ, đồng thời kiểm tra những dấu hiệu bất thường trong dữ liệu.
Điểm theo tháng và ngôn ngữ
Điểm theo tháng và ngôn ngữ
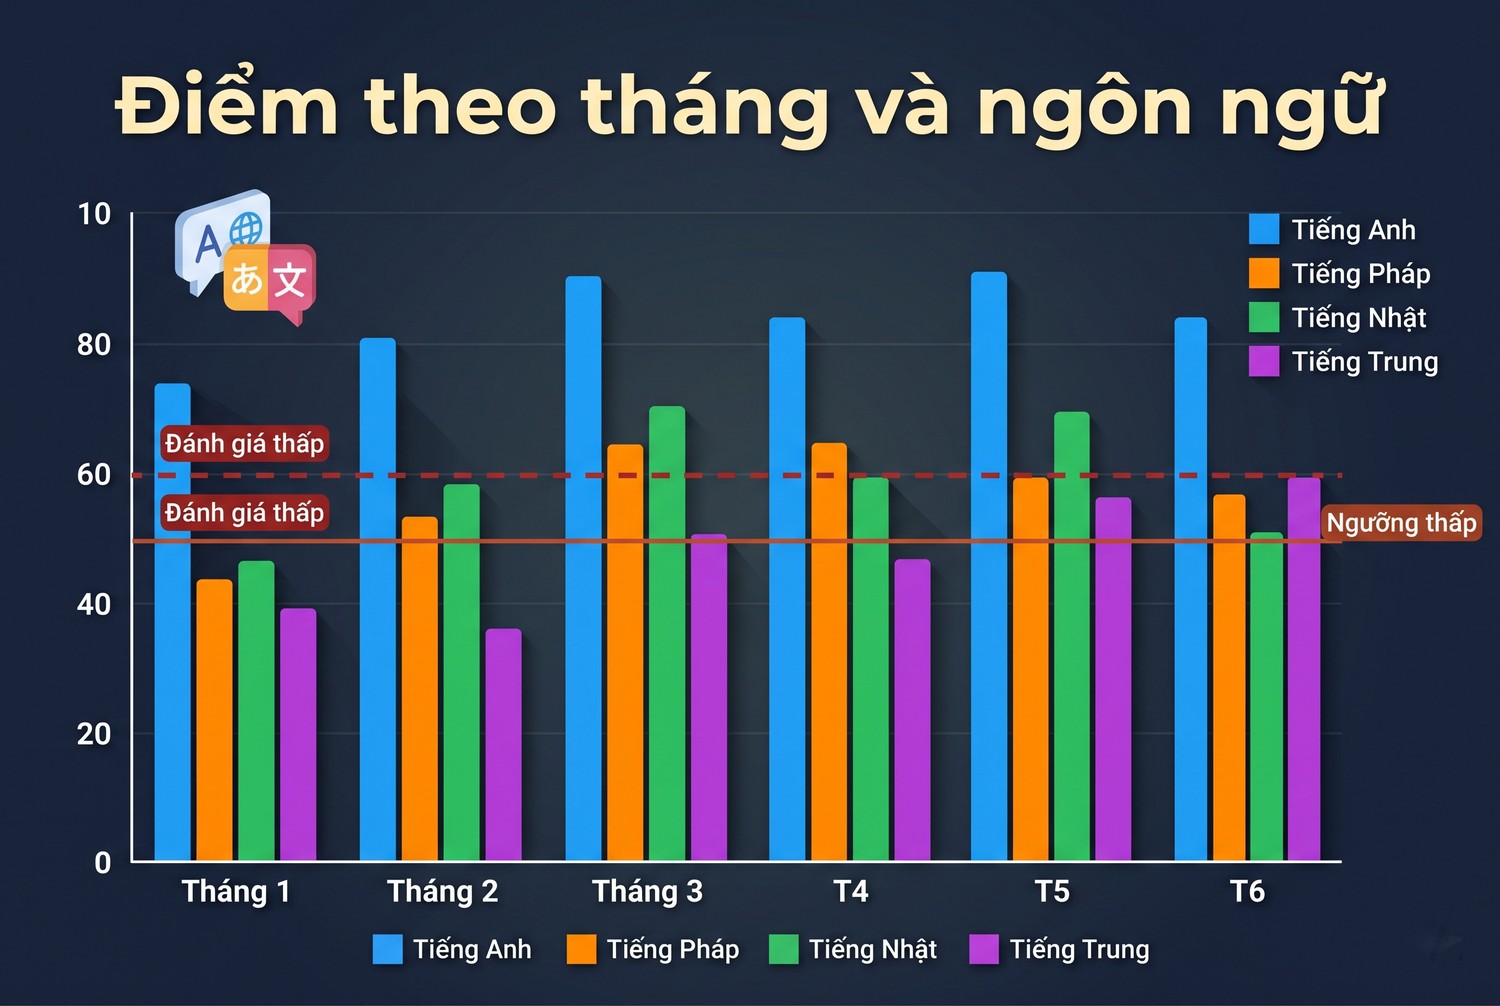
Truy vấn dưới nhóm theo cơ sở, tháng đăng và ngôn ngữ, trả về số đánh giá, điểm trung bình và tỷ lệ đánh giá thấp. Tỷ lệ đánh giá một và hai sao thường nhạy hơn điểm trung bình khi chất lượng dịch vụ đi xuống.
def monthly_summary(con):
    return con.execute("""SELECT location_id, substr(published_date, 1, 7) AS month, language,
        COUNT(*), ROUND(AVG(rating), 2), ROUND(100.0 * SUM(rating <= 2) / COUNT(*), 1)
        FROM reviews GROUP BY 1, 2, 3 ORDER BY 1, 2, 3""").fetchall()

for row in monthly_summary(con):
    print(row)
Bộ mẫu cho ba dòng: tháng 9 tiếng Anh một đánh giá điểm 2, tháng 10 tiếng Anh một đánh giá điểm 4, tháng 10 tiếng Hàn một đánh giá điểm 5. Với dữ liệu thật, nhóm có ít hơn khoảng 10 đánh giá nên hiển thị kèm cảnh báo cỡ mẫu nhỏ.
Phát hiện nội dung trùng
Trường text_hash giúp tìm các đánh giá khác review_id nhưng cùng nội dung. Hiện tượng này có thể do người dùng đăng lại, do hệ thống trùng lặp, hoặc là dấu hiệu đánh giá không tự nhiên. Kịch bản không tự kết luận, chỉ liệt kê để người phân tích xem.
def duplicate_texts(con):
    return con.execute("""SELECT text_hash, COUNT(*), GROUP_CONCAT(review_id) FROM reviews
        WHERE length(text) > 20 GROUP BY text_hash HAVING COUNT(*) > 1""").fetchall()

print("Nội dung trùng:", duplicate_texts(con))
Bộ mẫu không có nội dung trùng giữa các review_id khác nhau, nên kết quả rỗng. Điều kiện độ dài trên 20 ký tự tránh báo trùng với những đánh giá rất ngắn như "Good" vốn trùng nhau tự nhiên.
Danh sách kiểm tra đầu ra
Ngoài hai truy vấn trên, anh em chạy thêm vài kiểm tra trước khi gửi báo cáo. Mỗi kiểm tra có dấu hiệu và cách xử lý.
- Đánh giá có ngày đăng trong tương lai: lỗi múi giờ hoặc lỗi phân tích ngày.
- Cơ sở không có đánh giá mới quá 30 ngày: kiểm tra locationId và lịch gọi.
- Tỷ lệ ngôn ngữ đổi đột ngột: kiểm tra danh sách ngôn ngữ gọi.
- Bảng reviews có cột tên người dùng: lỗi ở bước chuẩn hoá, sửa ngay.
Tóm lại, tổng hợp theo tháng và ngôn ngữ biến kho đánh giá thành thông tin quản trị, còn kiểm tra đầu ra giữ cho thông tin đó đáng tin.
Xử lý lỗi khi crawl TripAdvisor bằng Python
Lỗi với Content API thường thuộc ba nhóm: khoá và quyền, hạn mức và dữ liệu. Vì khoá nằm trên URL, việc xử lý lỗi còn gắn với chuyện bảo vệ khoá trong log. Phần này đi qua từng nhóm.
Lỗi khoá và hạn mức
Danh sách dưới gom các mã lỗi hay gặp với API dùng khoá. Mỗi dòng ghi nguyên nhân thường gặp và hướng xử lý.
- 401 hoặc 403: khoá sai, hết hạn hoặc chưa được kích hoạt cho endpoint; kiểm tra trong tài khoản đối tác.
- 404: locationId không tồn tại; tra lại bằng Location Search.
- 429: vượt hạn mức gói; giãn lịch gọi, đừng đổi IP để gọi tiếp.
- 5xx: lỗi phía máy chủ; thử lại sau vài phút với số lần giới hạn.
Với mã 429, bài mua proxy bị lỗi 429 trên blog ProxyVN giải thích cơ chế giới hạn tần suất nói chung. Với API có khoá, hạn mức gắn với khoá, nên giải pháp duy nhất là giảm tần suất hoặc nâng gói.
Lỗi dữ liệu
Hàm normalize_review ném lỗi khi điểm nằm ngoài thang 1 tới 5. Thay vì để kịch bản dừng, anh em bắt lỗi này, ghi đánh giá vào bảng chờ xem xét và tiếp tục. Khi số đánh giá lỗi tăng, nguyên nhân thường là API đổi cấu trúc trường, cần cập nhật hàm chuẩn hoá.
Lỗi phân tích ngày là nhóm thứ hai. Phản hồi mẫu dùng định dạng ISO có chữ Z, được đọc bằng datetime.fromisoformat, nhưng dữ liệu thật có thể dùng định dạng khác. Viết hàm phân tích ngày chấp nhận vài định dạng phổ biến và báo lỗi rõ khi gặp định dạng lạ.
Bảo vệ khoá trong log
Mọi dòng log chứa URL phải đi qua hàm mask_key. Đối tượng phản hồi của Requests giữ URL đầy đủ trong thuộc tính url, nên in trực tiếp r.url sẽ lộ khoá. Một khoá bị lộ trong log chia sẻ có thể bị dùng hết hạn mức của cả dự án trong vài giờ.
Tóm lại, xử lý lỗi Content API gồm phân biệt lỗi khoá với lỗi hạn mức, đưa dữ liệu lỗi vào bảng chờ và luôn che khoá trước khi ghi log.
Khi nào cần proxy cho crawl TripAdvisor bằng Python
Với Content API, request đi từ máy chủ của anh em tới máy chủ API kèm khoá. Hạn mức gắn với khoá, nên proxy không làm tăng số lượt gọi. Phần lớn dự án không cần proxy cho phần thu thập đánh giá.
Tình huống proxy có ích
Một số chương trình API đối tác cho phép hoặc yêu cầu giới hạn khoá theo danh sách IP hay tên miền được phép. Khi máy chủ của anh em có IP thay đổi, một proxy datacenter tĩnh giúp khai báo một IP cố định. Đây là tình huống hạ tầng, không liên quan tới việc lấy thêm dữ liệu.
Tình huống thứ hai là kiểm tra thủ công cách trang của cơ sở hiển thị với khách ở thị trường khác, ví dụ ngôn ngữ mặc định hay đơn vị tiền tệ. Đây là việc của người làm marketing, xem vài trang, không phải kịch bản tự động. Proxy dân cư tĩnh hoặc datacenter đặt đúng khu vực đáp ứng nhu cầu này.
Tình huống không dùng proxy
Không dùng proxy xoay để đọc trang đánh giá hàng loạt. Điều khoản TripAdvisor cấm việc này khi không có văn bản cho phép, và cấm cả việc vượt các biện pháp giới hạn truy cập. Thay IP liên tục để tránh bị chặn chính là kiểu vượt giới hạn mà điều khoản nhắc tới.
Với đánh giá du lịch, kênh hợp lệ cho vài đánh giá mỗi lần gọi nhưng đều đặn mỗi ngày. Sau vài tháng, kho dữ liệu tích luỹ đủ để trả lời phần lớn câu hỏi quản trị.
Gói phù hợp
Nếu cần IP tĩnh cho máy chủ gọi API, anh em có thể mua proxy tốc độ cao dạng datacenter Việt Nam hoặc datacenter US trên trang chủ ProxyVN, kiểm tra IP đi ra rồi khai báo với chương trình đối tác. Với việc kiểm tra hiển thị theo khu vực, bài proxy local SEO có thêm gợi ý về cách xem kết quả theo địa phương.
Tóm lại, proxy cho dự án TripAdvisor phục vụ IP cố định và kiểm tra hiển thị thủ công, không phục vụ thu thập đánh giá.
Checklist trước khi crawl TripAdvisor bằng Python chạy thật
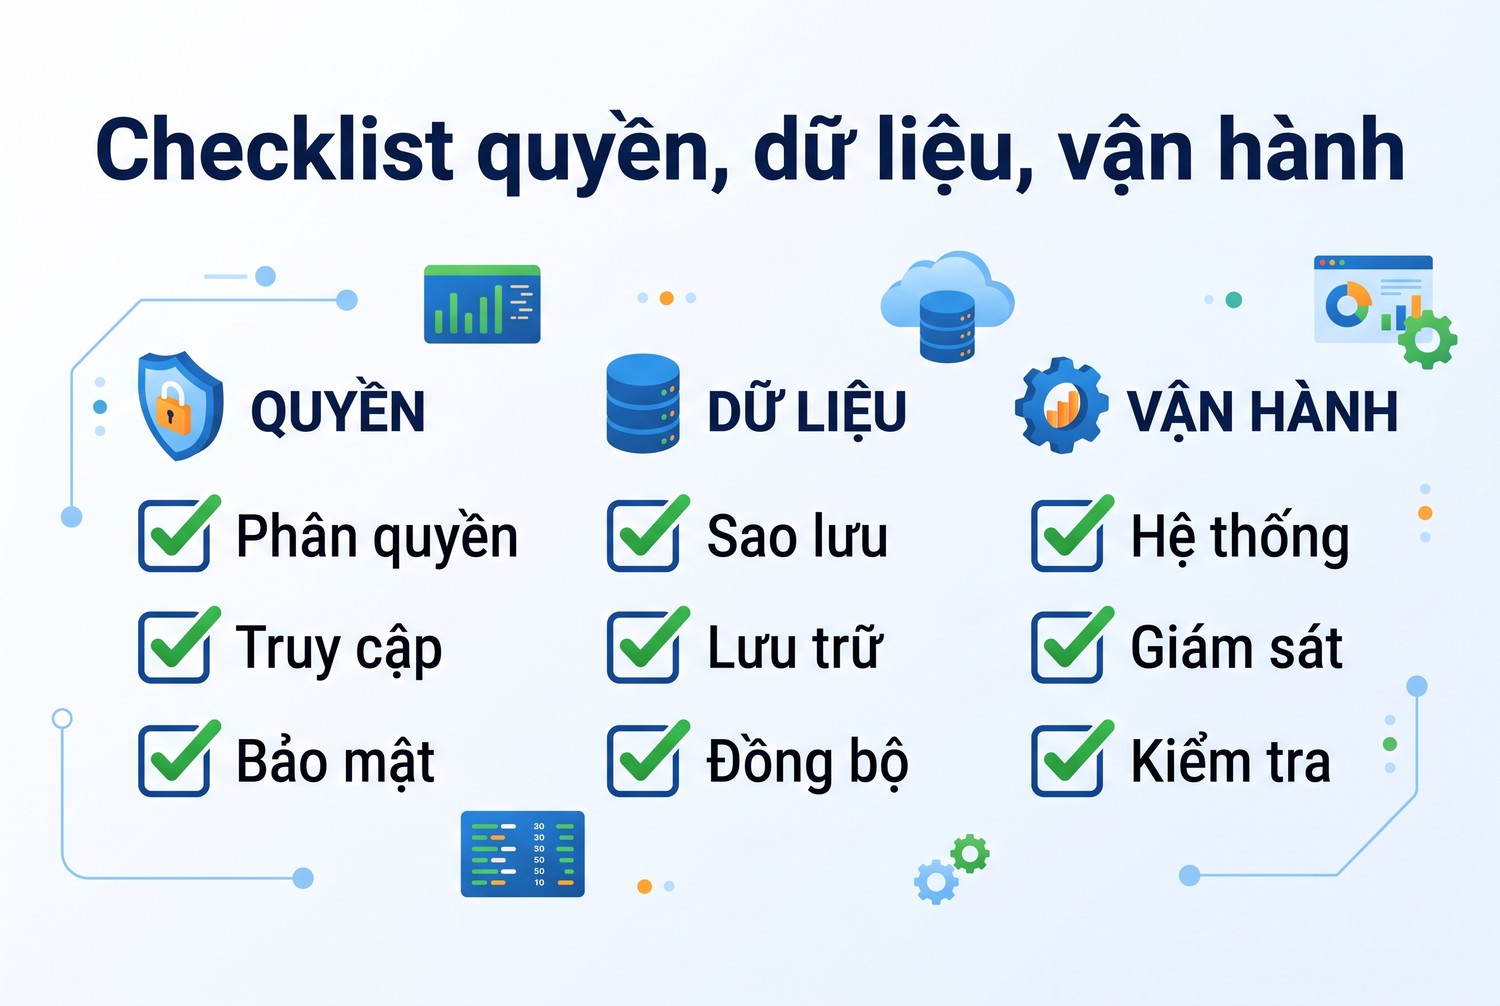
Danh sách dưới gom các bước trong bài thành việc cần kiểm tra trước khi để kịch bản chạy hằng ngày. Chia theo ba nhóm: quyền, dữ liệu và vận hành.
Checklist quyền, dữ liệu, vận hành
Nhóm quyền
Nhóm này quyết định dự án có được phép chạy. Rà lại khi điều khoản hoặc gói API thay đổi.
- Đã đọc điều khoản TripAdvisor và điều khoản Content API, ghi ngày đọc.
- Dùng khoá API đối tác, không đọc trang website hàng loạt.
- Không lưu tên người dùng, ảnh đại diện hay quê quán người viết.
- Báo cáo có đường dẫn về đánh giá gốc.
Nhóm dữ liệu
Nhóm này đảm bảo kho đánh giá đúng và không trùng. Mỗi mục tương ứng một khối code trong bài.
- Khoá chính là nguồn và review_id.
- Điểm gốc và điểm quy đổi cùng được lưu.
- Ngày đăng quy về UTC.
- Có bảng review_seen ghi lượt xuất hiện theo ngôn ngữ.
- Có truy vấn phát hiện nội dung trùng.
Nhóm vận hành
Nhóm cuối giúp kịch bản chạy đều mà không bỏ sót. Xem lại sau tháng đầu chạy thật.
- Khoảng gọi tính từ tốc độ đánh giá thật, có hệ số an toàn.
- Log che khoá API.
- Đánh giá lỗi vào bảng chờ, không làm dừng kịch bản.
Kết luận cho checklist: kho đánh giá tốt không cần nhiều dữ liệu nhất, mà cần đều đặn, sạch và luôn truy được về đánh giá gốc.
Crawl TripAdvisor bằng Python đúng cách là dùng Content API với khoá đối tác, chuẩn hoá đánh giá theo review_id và ngôn ngữ, loại thông tin người viết rồi tích luỹ đều mỗi ngày. Đọc điều khoản trước khi gọi. Cần IP tĩnh cho máy chủ, anh em nhắn Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam trước khi crawl TripAdvisor bằng Python.


