
Crawl Redfin bằng Python: listing ID, so sánh bản cập nhật
Crawl Redfin bằng Python thường được hỏi khi anh em cần theo dõi tin nhà đất Mỹ đổi qua từng tuần. Điều khoản của Redfin cấm thu thập tự động khi chưa có văn bản cho phép, nên bài toán thật nằm ở chỗ khác. Bài này, ProxyVN hướng dẫn chọn trường dữ liệu được phép, chuẩn hoá mã tin, so sánh hai bản chụp dữ liệu và lưu lịch sử thay đổi bằng SQLite.
Mục tiêu và phạm vi của crawl Redfin bằng Python
Khi nói tới dữ liệu Redfin, nhiều người hình dung một kịch bản đọc từng trang nhà rồi ghi ra bảng. Thực tế, giá trị của dữ liệu nằm ở việc biết cái gì đã đổi giữa hai lần xem: căn nào mới lên sàn, căn nào rút, căn nào đổi giá hay đổi trạng thái. Bài này tập trung vào phần so sánh đó, phần mà các hướng dẫn đọc trang thường bỏ qua.
Hai lớp dữ liệu
Lớp thứ nhất là dữ liệu thị trường tổng hợp, ví dụ giá bán trung vị theo vùng, số ngày rao trung vị, tỷ lệ giảm giá. Redfin công bố lớp này trong Data Center để mọi người tải về phân tích. Lớp thứ hai là dữ liệu từng tin rao, đến từ hệ thống niêm yết MLS và chịu ràng buộc cấp phép.
Ranh giới giữa hai lớp cũng là ranh giới pháp lý. Lớp tổng hợp không chứa thông tin nhận diện từng căn, nên điều kiện sử dụng thường thoáng hơn. Lớp từng tin gắn với địa chỉ cụ thể và hợp đồng cấp phép của MLS, nên mỗi cách dùng đều phải nằm trong phạm vi hợp đồng cho phép.
Hai lớp này phục vụ hai kiểu câu hỏi khác nhau. Lớp tổng hợp trả lời câu hỏi thị trường đang nóng hay nguội. Lớp từng tin trả lời câu hỏi căn cụ thể nào vừa đổi gì. Bài dành phần lớn dung lượng cho lớp thứ hai, vì đây là nơi kỹ thuật chuẩn hoá và so sánh thật sự cần thiết.
Phạm vi kỹ thuật trong bài
Bài xây ba khối: chuẩn hoá mã tin từ nhiều dạng ghi khác nhau, so sánh hai bản chụp dữ liệu ở mức từng trường, và lưu lịch sử theo kiểu mỗi phiên bản một dòng có thời điểm hiệu lực. Cả ba khối chạy được với dữ liệu mẫu đặt trong code, không gọi tới Redfin.
Bản chụp dữ liệu có thể đến từ nguồn cấp phép, từ hệ thống của chính văn phòng môi giới hoặc từ tệp xuất mà anh em được quyền dùng. Tóm lại, crawl Redfin bằng Python trong bài là bài toán so sánh và lưu lịch sử, không phải bài toán đọc trang.
Trường công khai được phép khi crawl Redfin bằng Python
Câu hỏi "được phép lấy trường nào" có hai tầng: tầng điều khoản của website và tầng dữ liệu cá nhân. Cả hai tầng cần trả lời trước khi viết code. Phần này đi qua từng tầng với văn bản gốc.
Điều khoản trước, dữ liệu sau
Điều khoản của Redfin
ProxyVN đọc điều khoản sử dụng của Redfin ngày 23/10/2026. Mục 2.3.5 có tiêu đề không cào hay quét dữ liệu, ghi rằng người dùng không được tự động crawl hay truy vấn dịch vụ cho bất kỳ mục đích nào, bao gồm quét màn hình, quét cơ sở dữ liệu, spider, robot và crawler, trừ khi có văn bản cho phép trước của công ty Redfin liên quan.
Một mục khác của điều khoản cấm hiển thị, phân phối hay bán lại thông tin từ dịch vụ, và nêu rõ việc cấm này bao gồm cả scraping và data mining. Hai mục cộng lại cho thấy đường đọc trang Redfin hàng loạt bằng kịch bản không phải lựa chọn hợp lệ khi chưa có thoả thuận.
Dữ liệu Redfin công bố để tải
Trang Data Center của Redfin liệt kê nhiều bộ dữ liệu tải về: Housing Market Tracker theo tuần và tháng, cán cân người mua người bán, thị trường nhà cao cấp, mức giảm giá, huỷ giao dịch, rút tin và rao lại, nhà đầu tư mua nhà, chỉ số giá nhà Redfin và nhiều bộ khác. Mỗi bộ ghi tần suất cập nhật, phần lớn là hàng tháng.
Các bộ như Price Drops hay Home Delistings & Relistings trả lời đúng loại câu hỏi mà nhiều người định cào từng tin để tính: tỷ lệ người bán giảm giá, tỷ lệ tin bị rút rồi rao lại. Trước khi xây hệ thống so sánh từng tin, anh em nên kiểm tra xem câu hỏi của mình đã có lời giải sẵn ở cấp tổng hợp chưa.
Khi dùng các tệp tải về, anh em mở dòng tiêu đề trước để biết tên cột và cấp vùng thật sự có trong tệp, thay vì đoán theo tên bộ dữ liệu. Lưu kèm ngày tải và tên tệp gốc, vì Redfin có thể điều chỉnh số liệu cũ ở lần công bố sau. Hai lần tải cùng một bộ dữ liệu cách nhau một tháng có thể cho con số khác nhau ở cùng một tháng quá khứ.
Trường từng tin và dữ liệu cá nhân
Với dữ liệu từng tin từ nguồn cấp phép, bài chỉ giữ các trường mô tả tài sản và giao dịch: mã tin, địa chỉ, mã ZIP, loại nhà, số phòng ngủ, phòng tắm, diện tích, giá rao, trạng thái và ngày niêm yết. Không lưu tên chủ nhà, số điện thoại, email hay ghi chú riêng của môi giới.
Bảng dưới tóm tắt các nguồn và phạm vi sử dụng. Anh em đối chiếu với điều khoản cụ thể của nguồn mình đang dùng trước khi triển khai.
Nguồn |
Cấp dữ liệu |
Điều kiện |
Dùng cho |
|---|---|---|---|
Trang Redfin |
Từng tin, hiển thị |
Cấm crawl nếu không có văn bản cho phép |
Xem thủ công |
Redfin Data Center |
Tổng hợp theo vùng |
Tải công khai, ghi nguồn khi công bố |
Câu hỏi thị trường |
Nguồn MLS cấp phép |
Từng tin |
Theo hợp đồng cấp phép |
So sánh từng tin |
Dữ liệu của văn phòng |
Từng tin của mình |
Theo quy định MLS và nội bộ |
Theo dõi danh mục riêng |
Kết lại, trường được phép là trường mô tả tài sản, lấy từ nguồn mà anh em có quyền dùng. Phần còn lại của bài xử lý những trường đó.
Chuẩn hoá listing ID khi crawl Redfin bằng Python
Một căn nhà có thể mang nhiều mã: mã tin trên MLS, mã tài sản trong đường dẫn của website và mã nội bộ của văn phòng. Khi gom dữ liệu từ nhiều lần xuất hay nhiều nguồn, mã ghi không đồng nhất là nguyên nhân hàng đầu của tin trùng và tin bị coi là mới trong khi thật ra đã có.
Các dạng mã thường gặp
Mã tin MLS là chuỗi do từng hệ thống MLS cấp, nên hai MLS khác nhau có thể có cùng số. Vì vậy mã tin chỉ duy nhất khi đi kèm tên nguồn MLS. Khi xuất ra bảng tính, mã này hay bị thêm khoảng trắng, chữ thường lẫn chữ hoa hoặc mất số không ở đầu nếu ô bị định dạng số.
Đường dẫn trang nhà trên Redfin thường có một đoạn /home/ theo sau là dãy số định danh tài sản. Khi người dùng dán đường dẫn vào bảng, đường dẫn có thể kèm tham số theo dõi hoặc dấu gạch chéo cuối. Lấy riêng dãy số giúp so khớp ổn định hơn so với so cả chuỗi URL.
Quy tắc chuẩn hoá
Quy tắc ProxyVN dùng trong lab gồm bốn bước. Bỏ khoảng trắng và ký tự không phải chữ số hay chữ cái. Đổi về chữ hoa. Ghép với mã nguồn MLS theo dạng NGUỒN:MÃ. Nếu chỉ có đường dẫn, lấy dãy số sau /home/ và ghép với tiền tố RF.
import re
import csv
import io
import json
import sqlite3
from urllib.parse import urlsplit

def norm_mls(source, number):
    src = re.sub(r"[^A-Za-z0-9]", "", str(source or "")).upper()
    num = re.sub(r"[^A-Za-z0-9]", "", str(number or "")).upper()
    return f"{src}:{num}" if src and num else ""

def redfin_home_id(url):
    path = urlsplit(str(url or "")).path.rstrip("/")
    m = re.search(r"/home/(\d+)$", path)
    return f"RF:{m.group(1)}" if m else ""

def listing_key(row):
    return norm_mls(row.get("mls_source"), row.get("mls_number")) or redfin_home_id(row.get("url"))

print(norm_mls("crmls", " oc26-123456 "))
print(redfin_home_id("https://www.redfin.com/CA/Irvine/1-Demo-Ct-92618/home/12345678?utm_source=x"))
Hàm redfin_home_id dùng urlsplit trong module urllib.parse để tách phần đường dẫn, nhờ vậy tham số theo dõi và dấu gạch chéo cuối không ảnh hưởng kết quả. Kết quả lab: mã MLS thành CRMLS:OC26123456, đường dẫn cho RF:12345678. Mã nguồn trong ví dụ là giả lập, anh em thay bằng tên nguồn thật trong hợp đồng cấp phép.
Khi một căn có hai khoá
Nếu bản chụp có cả mã MLS lẫn đường dẫn, hàm listing_key ưu tiên mã MLS vì đây là mã gốc của tin. Một bảng phụ nên ghi cặp ánh xạ giữa hai khoá để nối dữ liệu từ nguồn chỉ có đường dẫn. Khi cùng một căn được rao lại với mã MLS mới, khoá tin đổi nhưng địa chỉ chuẩn hoá vẫn giữ, giúp nối các lần rao với nhau.
Khoá tin ổn định là điều kiện để mọi phép so sánh phía sau có nghĩa. Tóm lại, chuẩn hoá listing ID gồm làm sạch ký tự, ghép nguồn và lấy định danh từ đường dẫn khi thiếu mã gốc.
Chuẩn bị môi trường cho crawl Redfin bằng Python
Toàn bộ code trong bài dùng thư viện chuẩn của Python: re, csv, sqlite3, urllib. Không cần Requests vì bài không gọi mạng. Nếu nguồn cấp phép của anh em có API, phần gọi API thêm vào sau theo tài liệu của nhà cung cấp.
Phiên bản và cấu trúc thư mục
Lab chạy trên Python 3.12.10. Thư mục dự án gồm ba phần: snapshots chứa các tệp xuất theo ngày, db chứa tệp SQLite và reports chứa báo cáo khác biệt. Đặt tên tệp chụp theo ngày dạng năm-tháng-ngày để sắp xếp đúng thứ tự.
python -m venv .venv
.\.venv\Scripts\Activate.ps1
New-Item -ItemType Directory -Force snapshots, db, reports
python --version
Không cài thêm gì cũng là một lợi thế khi đưa kịch bản lên máy chủ của văn phòng, nơi việc cài gói mới thường phải qua phê duyệt.
Định dạng bản chụp
Mỗi bản chụp là tệp CSV với tiêu đề cố định: mls_source, mls_number, url, address, zip, beds, baths, sqft, price, status, list_date. Nếu nguồn xuất có tên cột khác, viết một bước đổi tên cột trước khi đưa vào kịch bản. Giữ tiêu đề cố định giúp code so sánh không phải biết dữ liệu đến từ đâu.
Dữ liệu mẫu hai ngày
Lab dùng hai bản chụp giả lập, ngày 16 và 23/10/2026. Giữa hai ngày có đủ các tình huống: một tin giảm giá, một tin chuyển sang chờ giao dịch, một tin biến mất, một tin mới và một tin chỉ khác về cách ghi mã. Tình huống cuối là bẫy chính mà bước chuẩn hoá phải xử lý.
SNAP_1016 = """mls_source,mls_number,url,address,zip,beds,baths,sqft,price,status,list_date
crmls,OC26-1001,,1 Demo Ct,92618,3,2,1650,1250000,active,2026-09-30
crmls,OC26-1002,,2 Demo Ct,92618,4,3,2100,1590000,active,2026-10-02
crmls,OC26-1003,,3 Demo Ct,92618,2,2,1100,899000,active,2026-10-05
,,https://www.redfin.com/CA/Irvine/4-Demo-Ct-92618/home/5550004,4 Demo Ct,92618,3,2,1500,1150000,active,2026-10-08
"""

SNAP_1023 = """mls_source,mls_number,url,address,zip,beds,baths,sqft,price,status,list_date
CRMLS, oc26 1001 ,,1 Demo Ct,92618,3,2,1650,1199000,active,2026-09-30
crmls,OC26-1002,,2 Demo Ct,92618,4,3,2100.0,1590000,pending,2026-10-02
,,https://www.redfin.com/CA/Irvine/4-Demo-Ct-92618/home/5550004/,4 Demo Ct,92618,3,2,1500,1150000,active,2026-10-08
crmls,OC26-1005,,5 Demo Ct,92618,3,3,1800,1320000,active,2026-10-20
"""

def load_snapshot(text):
    return list(csv.DictReader(io.StringIO(text)))
Tin OC26-1001 ở bản chụp sau được ghi " oc26 1001 " với nguồn viết hoa, diện tích tin OC26-1002 ghi 2100.0 thay vì 2100. Cả hai là khác biệt về cách ghi, không phải thay đổi thật. Tóm lại, môi trường cho bài rất nhẹ, phần đáng đầu tư là bộ dữ liệu mẫu chứa đủ các tình huống khó.
So sánh bản cập nhật khi crawl Redfin bằng Python
Phần này là lõi của bài: so hai bản chụp và liệt kê chính xác cái gì đã đổi. Đây là ví dụ triển khai do ProxyVN viết, đã chạy với hai bản chụp mẫu ở trên. Kết quả là danh sách tin mới, tin biến mất và thay đổi ở mức từng trường.
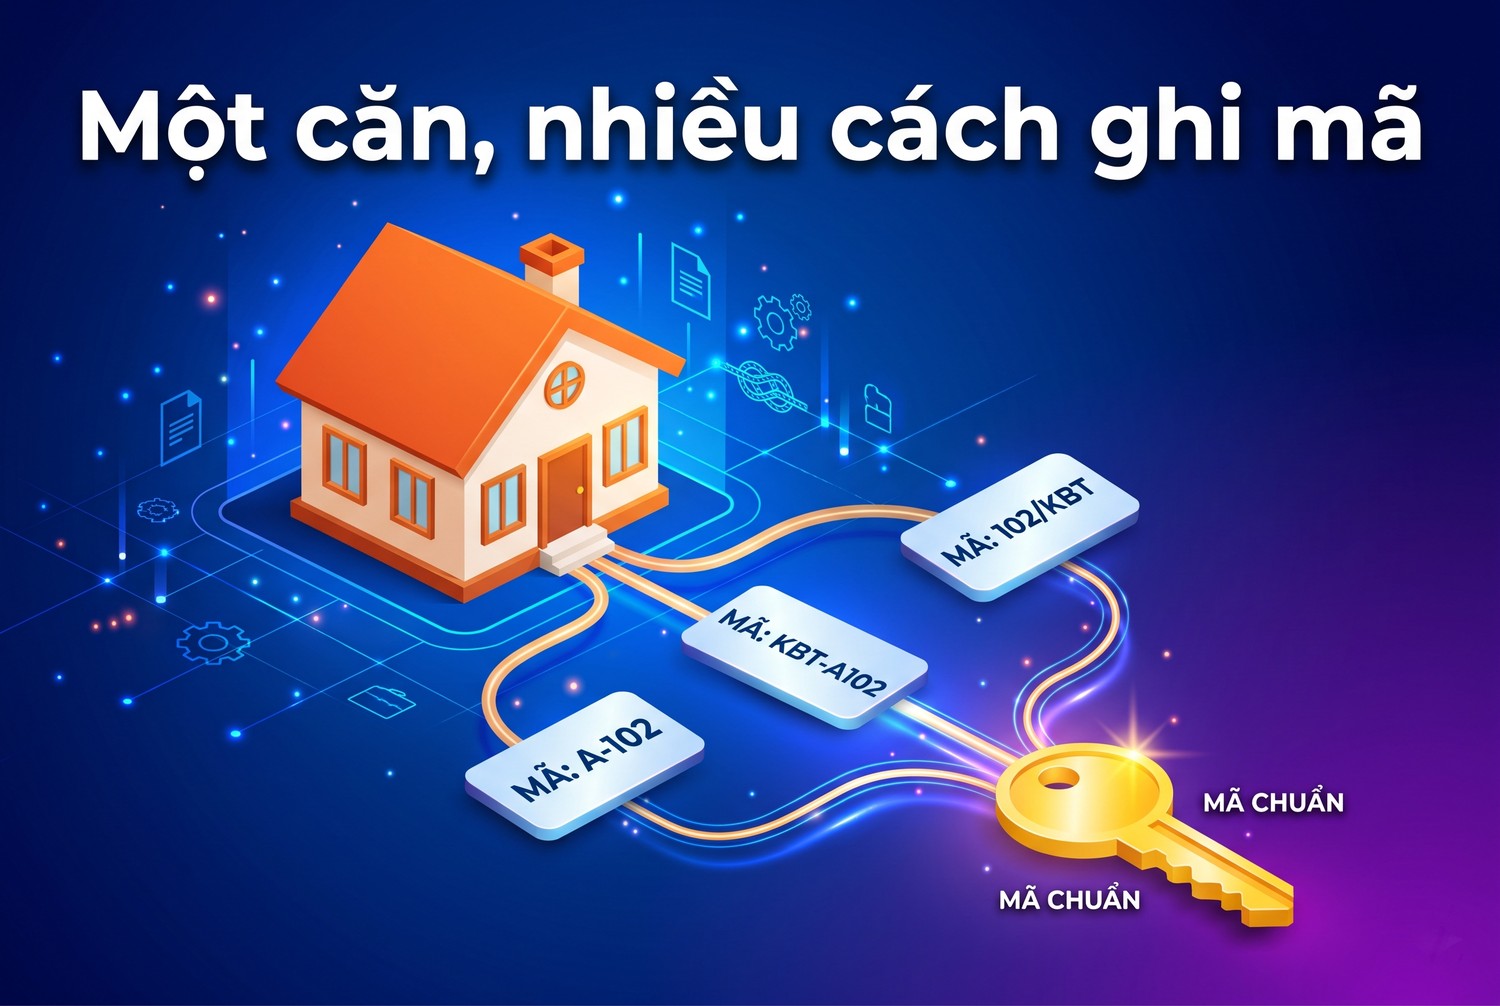
Một căn, nhiều cách ghi mã
Chuẩn hoá giá trị trước khi so
Trước khi so, mỗi giá trị được đưa về dạng chuẩn theo kiểu của trường. Số được đổi sang số thực rồi làm tròn, chuỗi được gộp khoảng trắng và đổi chữ thường với trường trạng thái. Không có bước này, 2100 và 2100.0 sẽ bị coi là hai giá trị khác nhau.
NUMERIC = {"beds": 0, "baths": 1, "sqft": 0, "price": 0}
COMPARE = ["address", "zip", "beds", "baths", "sqft", "price", "status"]

def norm_value(field, value):
    v = " ".join(str(value or "").split())
    if field in NUMERIC and v:
        return round(float(v), NUMERIC[field])
    if field == "status":
        return v.lower()
    if field == "zip":
        return v[:5]
    return v

def index_snapshot(rows):
    out = {}
    for r in rows:
        key = listing_key(r)
        if not key:
            continue
        out[key] = {f: norm_value(f, r.get(f)) for f in COMPARE}
    return out
Hàm index_snapshot trả về từ điển với khoá là listing_key đã chuẩn hoá. Dòng không tạo được khoá bị bỏ qua, và anh em nên đếm số dòng này để biết nguồn xuất có vấn đề hay không.
Hàm so sánh hai bản chụp
Hàm diff_snapshots trả về ba danh sách. Khoá chỉ có ở bản mới là tin mới. Khoá chỉ có ở bản cũ là tin biến mất. Khoá có ở cả hai được so từng trường, mỗi trường khác nhau sinh một dòng thay đổi.
def diff_snapshots(old_rows, new_rows):
    old, new = index_snapshot(old_rows), index_snapshot(new_rows)
    added = sorted(set(new) - set(old))
    removed = sorted(set(old) - set(new))
    changed = []
    for key in sorted(set(old) & set(new)):
        for f in COMPARE:
            if old[key][f] != new[key][f]:
                changed.append((key, f, old[key][f], new[key][f]))
    return added, removed, changed

added, removed, changed = diff_snapshots(load_snapshot(SNAP_1016), load_snapshot(SNAP_1023))
print("Mới:", added)
print("Biến mất:", removed)
for c in changed:
    print("Đổi:", c)
Kết quả lab: một tin mới CRMLS:OC261005, một tin biến mất CRMLS:OC261003, và hai thay đổi. Tin OC261001 đổi giá từ 1.250.000 xuống 1.199.000 USD, tin OC261002 đổi trạng thái từ active sang pending. Tin có đường dẫn với dấu gạch chéo cuối không bị coi là mới, diện tích 2100.0 không bị coi là thay đổi.
Tin biến mất không có nghĩa là đã bán
Một tin không còn trong bản chụp mới có thể đã bán, đã rút, đã hết hạn hoặc đơn giản là nằm ngoài bộ lọc xuất lần này. Kịch bản không nên tự gán trạng thái đã bán. Cách an toàn là đánh dấu "không thấy" kèm ngày, rồi đối chiếu với nguồn trạng thái chính thức nếu có.
Đây cũng là lý do bộ Home Delistings & Relistings của Redfin Data Center hữu ích. Nó cho tỷ lệ rút tin và rao lại ở cấp vùng, giúp anh em biết tỷ lệ tin biến mất trong dữ liệu của mình có bất thường hay không. Tóm lại, so sánh bản cập nhật cần chuẩn hoá giá trị trước, so theo khoá đã chuẩn hoá và cẩn thận khi diễn giải tin biến mất.
Lưu lịch sử khi crawl Redfin bằng Python
Báo cáo khác biệt cho biết thay đổi giữa hai ngày. Muốn trả lời câu hỏi "căn này trông thế nào vào ngày 10/10", anh em cần lưu lịch sử. Cách phổ biến trong kho dữ liệu là mỗi phiên bản của một tin là một dòng, kèm thời điểm bắt đầu và kết thúc hiệu lực.
Bảng phiên bản có thời điểm hiệu lực
Bảng listing_versions có các cột của tin cộng hai cột valid_from và valid_to. Phiên bản đang có hiệu lực có valid_to rỗng. Khi một tin đổi, phiên bản cũ được đóng bằng cách ghi valid_to, rồi chèn phiên bản mới. Khi một tin biến mất, phiên bản cuối được đóng mà không chèn gì thêm.
def open_history(path="redfin_history.db"):
    con = sqlite3.connect(path)
    con.execute("""CREATE TABLE IF NOT EXISTS listing_versions (
        listing_key TEXT, data TEXT, valid_from TEXT, valid_to TEXT)""")
    con.execute("CREATE INDEX IF NOT EXISTS ix_open ON listing_versions(listing_key, valid_to)")
    return con

def apply_snapshot(con, rows, day):
    current = index_snapshot(rows)
    open_rows = dict(con.execute(
        "SELECT listing_key, data FROM listing_versions WHERE valid_to IS NULL").fetchall())
    stats = {"new": 0, "changed": 0, "closed": 0, "same": 0}
    for key, values in current.items():
        blob = json.dumps(values, sort_keys=True)
        if key not in open_rows:
            stats["new"] += 1
        elif open_rows[key] != blob:
            con.execute("UPDATE listing_versions SET valid_to=? WHERE listing_key=? AND valid_to IS NULL",
                        (day, key))
            stats["changed"] += 1
        else:
            stats["same"] += 1
            continue
        con.execute("INSERT INTO listing_versions VALUES (?, ?, ?, NULL)", (key, blob, day))
    for key in set(open_rows) - set(current):
        con.execute("UPDATE listing_versions SET valid_to=? WHERE listing_key=? AND valid_to IS NULL",
                    (day, key))
        stats["closed"] += 1
    con.commit()
    return stats

con = open_history(":memory:")
print(apply_snapshot(con, load_snapshot(SNAP_1016), "2026-10-16"))
print(apply_snapshot(con, load_snapshot(SNAP_1023), "2026-10-23"))
Lần áp dụng đầu sinh bốn tin mới. Lần thứ hai cho một tin mới, hai tin đổi, một tin đóng và một tin giữ nguyên. Tổng số dòng trong bảng sau hai lần là bảy: bốn phiên bản gốc, hai phiên bản sau thay đổi và một tin mới.
Truy vấn trạng thái tại một ngày
Với bảng phiên bản, câu hỏi về một ngày bất kỳ trở thành điều kiện đơn giản trên valid_from và valid_to. Hàm dưới trả về giá của mọi tin đang hiệu lực tại ngày cho trước.
def as_of(con, day):
    q = """SELECT listing_key, json_extract(data, '$.price') FROM listing_versions
           WHERE valid_from <= ? AND (valid_to IS NULL OR valid_to > ?) ORDER BY listing_key"""
    return con.execute(q, (day, day)).fetchall()

print(as_of(con, "2026-10-20"))
print(as_of(con, "2026-10-23"))
Ngày 20/10 trả về bốn tin với giá cũ, gồm cả tin 1003 chưa biến mất. Ngày 23/10 trả về bốn tin với giá mới, có tin 1005 và không còn tin 1003. Hàm json_extract là hàm JSON có sẵn trong SQLite, được tài liệu JSON của SQLite mô tả chi tiết.
Vì sao lưu dạng JSON
Lưu các trường tin trong một cột JSON giúp so sánh phiên bản bằng một phép so chuỗi, với điều kiện khoá được sắp xếp cố định. Khi cần truy vấn theo trường, json_extract đủ dùng cho dữ liệu vài chục nghìn dòng. Với quy mô lớn hơn, anh em tách các trường hay truy vấn thành cột riêng.
Cột JSON còn có lợi khi nguồn thêm trường mới. Anh em chỉ cần thêm tên trường vào danh sách COMPARE, các phiên bản cũ vẫn đọc được bình thường vì trường mới chỉ vắng mặt chứ không làm hỏng cấu trúc bảng. Nhược điểm là lần đầu thêm trường, mọi tin đều bị coi là đổi vì chuỗi JSON khác đi. Cách xử lý là chạy một lần cập nhật riêng để đồng bộ trường mới trước khi chạy so sánh định kỳ.
Tóm lại, bảng phiên bản có thời điểm hiệu lực giữ được toàn bộ lịch sử mà vẫn trả lời nhanh câu hỏi tại một ngày bất kỳ.
Xử lý lỗi khi crawl Redfin bằng Python
Với hệ thống so sánh bản chụp, lỗi nguy hiểm nhất là lỗi làm số lượng thay đổi tăng vọt hoặc giảm về không. Cả hai trường hợp thường do dữ liệu đầu vào, không phải do code. Phần này liệt kê dấu hiệu và cách phòng.
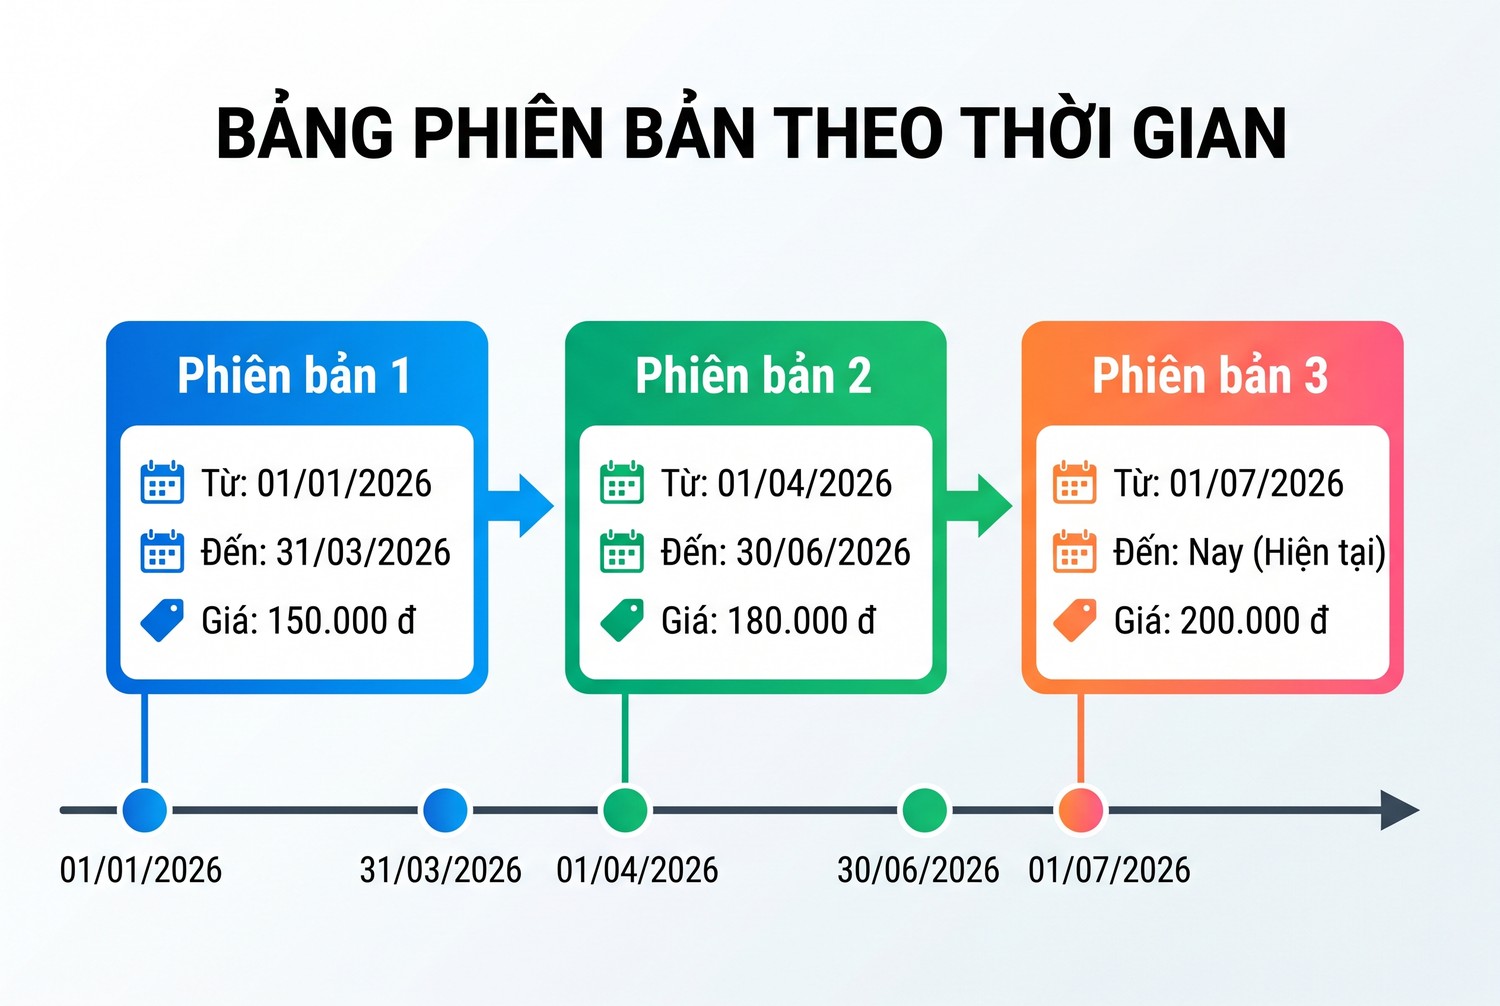
Bảng phiên bản theo thời gian
Dấu hiệu bản chụp có vấn đề
Danh sách dưới gom các dấu hiệu ProxyVN dùng để chặn một bản chụp trước khi áp dụng vào lịch sử. Mỗi dấu hiệu có ngưỡng mặc định, anh em chỉnh theo kích thước danh mục thật.
- Số dòng giảm hơn 30% so với bản trước: có thể xuất thiếu do bộ lọc.
- Tỷ lệ tin biến mất vượt 20%: kiểm tra lại phạm vi xuất.
- Số dòng không tạo được khoá lớn hơn 0: cột mã bị đổi tên hoặc trống.
- Hơn một nửa số tin đổi cùng một trường: có thể đổi đơn vị hoặc định dạng.
Chặn trước khi ghi
Hàm guard dưới chạy trước apply_snapshot. Nếu có cảnh báo, kịch bản dừng và ghi báo cáo thay vì cập nhật lịch sử. Một bản chụp lỗi được áp dụng sẽ đóng hàng loạt tin đang có hiệu lực, và sửa lại tốn công hơn nhiều so với chặn từ đầu.
def guard(old_rows, new_rows, max_drop=0.3, max_removed=0.2):
    alerts = []
    if old_rows and len(new_rows) < len(old_rows) * (1 - max_drop):
        alerts.append(f"số dòng giảm từ {len(old_rows)} xuống {len(new_rows)}")
    keyless = sum(1 for r in new_rows if not listing_key(r))
    if keyless:
        alerts.append(f"{keyless} dòng không có khoá")
    _, removed, changed = diff_snapshots(old_rows, new_rows)
    if old_rows and len(removed) > len(old_rows) * max_removed:
        alerts.append(f"{len(removed)} tin biến mất")
    return alerts

print(guard(load_snapshot(SNAP_1016), load_snapshot(SNAP_1023)))
print(guard(load_snapshot(SNAP_1016), load_snapshot(SNAP_1023)[:1]))
Với hai bản chụp mẫu, guard báo một cảnh báo vì một trên bốn tin biến mất, tức 25%, vượt ngưỡng 20%. Với danh mục mẫu nhỏ, ngưỡng này quá chặt, minh hoạ rằng ngưỡng phải chỉnh theo kích thước thật. Khi bản chụp mới chỉ còn một dòng, guard báo cả số dòng giảm mạnh lẫn số tin biến mất.
Lỗi ánh xạ trạng thái
Mỗi nguồn MLS có bộ mã trạng thái riêng. Một nguồn ghi Active Under Contract, nguồn khác ghi Pending, nguồn khác nữa dùng mã viết tắt. Anh em lập bảng ánh xạ về một tập trạng thái chung trước khi so sánh, nếu không mỗi lần nguồn đổi cách ghi sẽ sinh hàng loạt thay đổi giả.
Tập trạng thái chung nên nhỏ, ví dụ active, pending, sold, off_market và unknown. Mọi mã chưa có trong bảng ánh xạ rơi vào unknown và được đếm riêng trong báo cáo. Khi số tin unknown tăng đột ngột, đó là dấu hiệu nguồn vừa thêm mã trạng thái mới cần bổ sung vào bảng. Bảng ánh xạ nên lưu thành tệp cấu hình riêng để người phụ trách dữ liệu sửa mà không phải động vào code.
Một thay đổi giả lặp lại trên cả nghìn tin làm báo cáo vô dụng nhanh hơn bất kỳ lỗi mạng nào. Tóm lại, xử lý lỗi cho hệ thống so sánh nghĩa là kiểm tra bản chụp trước khi ghi và chuẩn hoá trạng thái theo bảng ánh xạ.
Khi nào cần proxy cho crawl Redfin bằng Python
Với cách tiếp cận trong bài, phần xử lý chạy trọn trên máy của anh em và không cần mạng. Proxy chỉ xuất hiện ở hai điểm: khi tải dữ liệu Data Center và khi gọi API của nguồn cấp phép. Cả hai thường chạy tốt mà không cần proxy.
Tình huống proxy có ích
Nhà cung cấp dữ liệu cấp phép đôi khi yêu cầu khai báo IP cố định được phép gọi API. Văn phòng dùng mạng gia đình hoặc mạng di động có IP thay đổi sẽ gặp khó. Một IP datacenter tĩnh đặt ở Mỹ hoặc Việt Nam giải quyết vấn đề này gọn gàng, và cấu hình trong Requests chỉ cần một dòng proxies.
Tình huống khác là mạng công ty bắt buộc đi qua proxy để ra Internet. Khi đó, khai báo proxy rõ ràng trong code giúp tránh lỗi khó đoán do biến môi trường. Cách khai báo proxy với thư viện Requests có trong bài cài đặt Python proxy từ thư viện Requests trên blog ProxyVN.
Tình huống không dùng proxy
Không dùng proxy để đọc trang Redfin hàng loạt. Điều khoản mục 2.3.5 đã nêu rõ, và việc đổi IP không thay đổi tính chất của hành vi. Nếu dự án thật sự cần dữ liệu từng tin của Redfin, con đường đúng là liên hệ Redfin để xin văn bản cho phép.
Với dữ liệu nhà đất, giá trị đến từ việc biết chính xác cái gì đã đổi. Một bản chụp hợp lệ mỗi tuần có ích hơn nghìn trang đọc được bằng cách lách điều khoản.
Gói phù hợp
Nếu cần IP cố định để khai báo với nhà cung cấp dữ liệu, anh em có thể mua proxy dạng datacenter US hoặc datacenter Việt Nam trên trang chủ ProxyVN, kiểm tra IP đi ra rồi gửi cho nhà cung cấp. Bài proxy dữ liệu bất động sản có thêm góc nhìn về nhu cầu mạng của ngành này.
Trước khi gửi IP cho nhà cung cấp, anh em chạy một request kiểm tra từ đúng máy chủ sẽ chạy kịch bản, qua đúng proxy sẽ dùng. Ghi lại IP nhận được cùng ngày kiểm tra vào tài liệu dự án. Khi đổi gói proxy hay đổi máy chủ, cập nhật lại khai báo với nhà cung cấp trước, rồi mới chuyển lưu lượng sang.
Tóm lại, proxy trong dự án Redfin chỉ là phần hạ tầng nhỏ phục vụ kết nối tới nguồn cấp phép, không phải công cụ lấy dữ liệu.
Checklist trước khi crawl Redfin bằng Python chạy thật
Danh sách dưới gom các bước đã nêu thành việc cần kiểm tra trước khi để hệ thống so sánh chạy theo lịch. Anh em rà lại mỗi khi thêm nguồn hoặc đổi định dạng xuất.
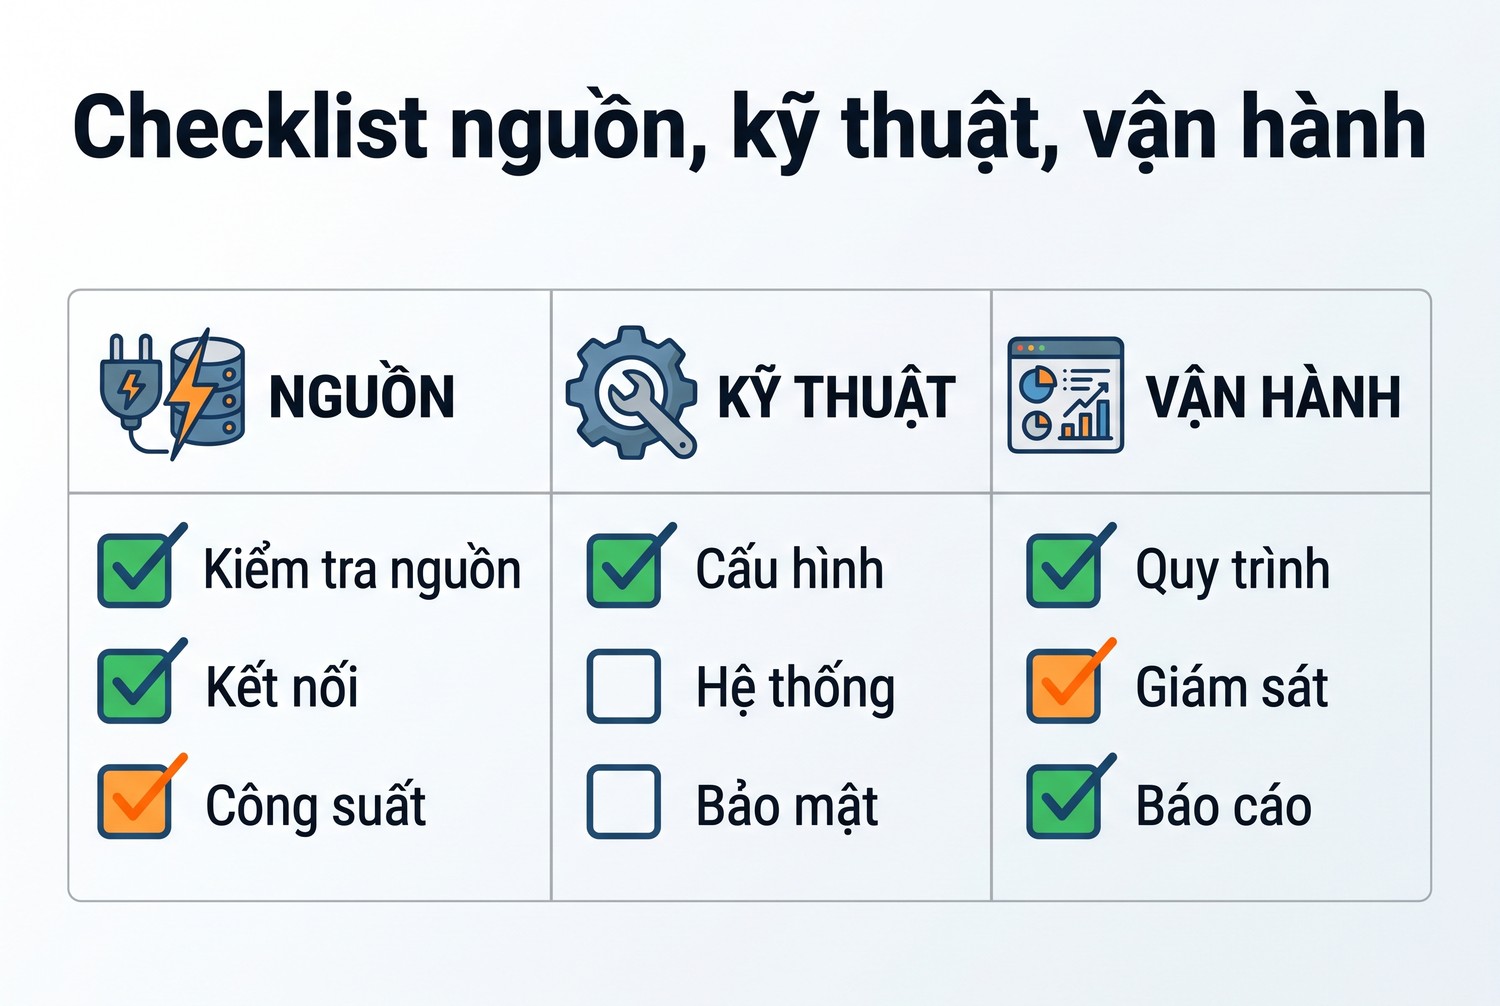
Checklist nguồn, kỹ thuật, vận hành
Nguồn và quyền
Nhóm này đảm bảo dữ liệu đầu vào hợp lệ. Thiếu một mục ở đây thì mọi phần kỹ thuật phía sau đều không còn ý nghĩa.
- Đã đọc điều khoản Redfin, không đọc trang hàng loạt khi chưa có văn bản cho phép.
- Câu hỏi thị trường đã kiểm tra với bộ dữ liệu Redfin Data Center.
- Bản chụp từng tin đến từ nguồn cấp phép hoặc dữ liệu của chính văn phòng.
- Không lưu tên chủ nhà hay thông tin liên hệ cá nhân.
Kỹ thuật
Nhóm này đảm bảo kết quả so sánh đúng. Mỗi mục tương ứng một khối code trong bài.
- listing_key ghép nguồn MLS và mã, hoặc lấy định danh từ đường dẫn.
- Giá trị số được làm tròn, trạng thái được chuẩn hoá trước khi so.
- Hàm guard chạy trước mỗi lần áp dụng bản chụp.
- Bảng phiên bản có valid_from và valid_to.
- Có bảng ánh xạ trạng thái cho từng nguồn MLS.
Vận hành
Nhóm cuối giúp hệ thống chạy đều mà không cần sửa tay. Lịch so sánh nên khớp với lịch xuất của nguồn.
- Tệp chụp đặt tên theo ngày, lưu lại ít nhất vài tháng.
- Báo cáo khác biệt lưu kèm mỗi lần chạy.
- Ghi nguồn và ngày khi công bố số liệu.
Kết luận cho checklist: hệ thống so sánh tốt là hệ thống mà mỗi dòng thay đổi trong báo cáo đều là thay đổi thật, truy được về bản chụp gốc.
Crawl Redfin bằng Python bền vững là dùng dữ liệu Data Center cho câu hỏi thị trường, nhận bản chụp từng tin từ nguồn được phép, chuẩn hoá listing ID rồi so sánh và lưu lịch sử theo phiên bản. Đọc điều khoản trước. Cần IP tĩnh cho nguồn cấp phép, anh em nhắn Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam trước khi crawl Redfin bằng Python.


