
Crawl Indeed bằng Python: nguồn được phép, schema và chống trùng
Crawl Indeed bằng Python nghe đơn giản, nhưng câu hỏi đầu tiên không phải viết bộ phân tích HTML ra sao mà là nguồn nào được phép lấy. Indeed có điều khoản riêng và kênh API dành cho đối tác. Bài này, ProxyVN đi qua cách đánh giá nguồn, dựng schema tin tuyển dụng theo chuẩn JobPosting, gộp tin trùng từ nhiều kênh và lưu vào SQLite.
Mục tiêu và phạm vi của crawl Indeed bằng Python
Người tìm cách lấy dữ liệu tuyển dụng thường có một trong ba mục tiêu: theo dõi mức lương theo vị trí, đếm nhu cầu tuyển theo kỹ năng hoặc gom tin của một nhóm công ty vào một bảng. Mỗi mục tiêu cần một tập trường khác nhau và một tần suất cập nhật khác nhau. Ghi rõ mục tiêu giúp loại bớt những trường không cần thu.
Dữ liệu tuyển dụng gồm những gì
Một tin tuyển dụng thường có chức danh, tên công ty, địa điểm, hình thức làm việc, mức lương nếu có, ngày đăng, hạn nộp và mô tả công việc. Đây là phần công khai, do nhà tuyển dụng đưa lên để người tìm việc đọc. Phần không công khai gồm hồ sơ ứng viên, tin nhắn và thông tin tài khoản, những thứ nằm ngoài phạm vi bài này.
Với phân tích thị trường, mô tả công việc đầy đủ thường không cần thiết. Chức danh, kỹ năng trích ra, địa điểm, lương và ngày đăng là đủ để vẽ bức tranh. Thu ít trường hơn đồng nghĩa với ít rủi ro bản quyền nội dung và ít dung lượng lưu trữ.
Kết quả mong muốn sau bài này
Sau bài, anh em có một kịch bản Python nhận tin từ nhiều nguồn được phép, chuẩn hoá về một schema, gộp tin trùng và lưu vào SQLite. Kịch bản chạy được ngay với bộ dữ liệu mẫu trong bài, không cần gọi website nào. Khi có nguồn thật được phép, anh em chỉ thay phần đầu vào.
Bài không hướng dẫn đăng nhập tự động, không vượt CAPTCHA và không dùng tài khoản ứng viên để xem thông tin ẩn. Mục tiêu là một bộ dữ liệu tuyển dụng sạch, có nguồn gốc rõ, chứ không phải lấy được càng nhiều càng tốt.
Tóm lại, crawl Indeed bằng Python bắt đầu bằng việc xác định đúng trường cần cho câu hỏi phân tích. Phần tiếp theo trả lời câu hỏi khó hơn: lấy các trường đó từ đâu cho hợp lệ.
Đánh giá nguồn được phép khi crawl Indeed bằng Python
Indeed là trang tổng hợp tin tuyển dụng, nhiều tin được lấy từ trang tuyển dụng của chính doanh nghiệp. Vì vậy, cùng một tin có thể tồn tại ở ba nơi: trang nghề nghiệp của công ty, hệ thống quản lý tuyển dụng mà công ty dùng và trang tổng hợp. Chọn nguồn gốc thay vì bản tổng hợp thường an toàn và sạch hơn.
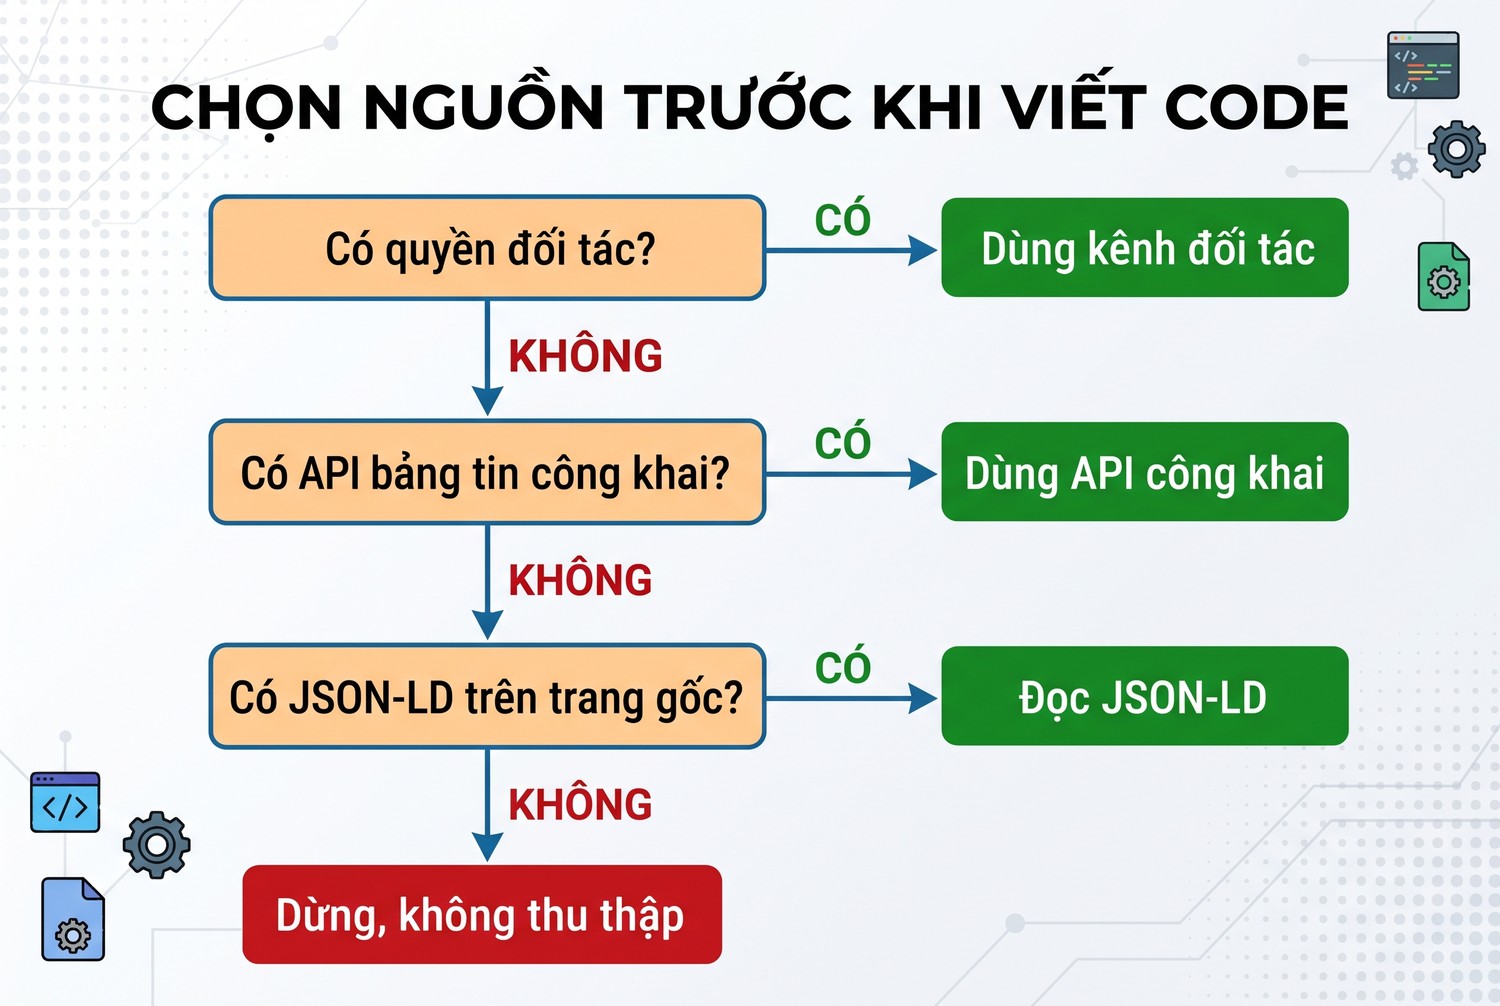
Chọn nguồn trước khi viết code
Điều khoản và kênh chính thức của Indeed
Trang tài liệu cho đối tác của Indeed mô tả các API quản lý tin đăng, ứng viên và nhà tuyển dụng, dùng GraphQL, với thông tin truy cập do Indeed cấp qua Partner Console. Đây là kênh dành cho hệ thống tuyển dụng và đối tác tích hợp, không phải API tìm kiếm mở cho mọi người. Muốn dùng, anh em phải đăng ký chương trình đối tác và được Indeed duyệt.
Điều khoản dịch vụ của Indeed mà ProxyVN đọc ngày 23/10/2026 có nhiều quy định về cách dùng site. Một ví dụ rõ: dùng automation, script hoặc bot để tự động hoá quy trình Indeed Apply ngoài công cụ chính thức là bị cấm. Indeed cũng có quyền giới hạn việc sử dụng để chống gian lận và thư rác.
Tệp robots.txt của Indeed cho phép nhiều đường dẫn nhưng chặn một số khu vực như trang ứng tuyển, khu vực cộng đồng và một số trang con của hồ sơ công ty. Cần nhớ robots.txt chỉ là chỉ dẫn cho bot, không phải giấy phép sử dụng dữ liệu. Điều khoản dịch vụ mới là văn bản quyết định, robots.txt không thay thế được.
Nguồn gốc: hệ thống tuyển dụng của doanh nghiệp
Nhiều công ty đăng tin qua các hệ thống quản lý tuyển dụng có API bảng tin công khai. Job Board API của Greenhouse ghi rõ dữ liệu bảng tin là công khai và các endpoint GET không cần xác thực. Endpoint liệt kê tin có dạng /v1/boards/{board_token}/jobs, trong đó board_token là mã bảng tin của từng công ty.
Postings API của Lever cũng cho phép đọc danh sách tin công khai theo tên site của công ty, với tham số skip và limit để phân trang và tham số mode=json để nhận JSON. Tài liệu Lever chỉ giới hạn tốc độ rõ ràng cho request nộp đơn, nhưng anh em vẫn nên gửi chậm khi đọc danh sách.
Ưu điểm của hai nguồn này là dữ liệu do chính doanh nghiệp đưa lên, có id ổn định và có thời điểm cập nhật. Nhược điểm là mỗi công ty một bảng tin, nên anh em cần danh sách công ty mục tiêu trước.
Nguồn gốc: dữ liệu có cấu trúc trên trang nghề nghiệp
Doanh nghiệp muốn tin của mình hiện trong Google thường gắn dữ liệu có cấu trúc kiểu JobPosting lên trang tin. Hướng dẫn dữ liệu có cấu trúc JobPosting của Google liệt kê các thuộc tính như title, datePosted, validThrough, hiringOrganization, jobLocation, baseSalary và employmentType. Đọc khối JSON-LD này dễ và ổn định hơn nhiều so với đọc giao diện.
Trước khi đọc trang nghề nghiệp của một công ty, anh em vẫn cần xem điều khoản của website đó và robots.txt. Nhiều doanh nghiệp vui lòng để tin của họ được lan toả, nhưng vẫn có công ty không muốn bị thu thập tự động. Bảng dưới tóm tắt các nguồn và điều kiện sử dụng.
Nguồn |
Cách truy cập |
Điều kiện |
Độ ổn định |
|---|---|---|---|
Indeed Partner API |
GraphQL, thông tin do Indeed cấp |
Phải là đối tác được duyệt |
Cao, có tài liệu |
Greenhouse Job Board API |
REST GET công khai |
Theo điều khoản Greenhouse và công ty |
Cao, có id tin |
Lever Postings API |
REST GET công khai |
Theo điều khoản Lever và công ty |
Cao, có id tin |
JSON-LD trên trang nghề nghiệp |
Tải trang, đọc khối script |
Xem điều khoản từng website |
Trung bình |
Giao diện tìm kiếm Indeed |
Tải HTML |
Đọc kỹ Terms, nhiều hạn chế |
Thấp, dễ gãy |
Như vậy, đường đi hợp lý nhất cho crawl Indeed bằng Python là xin quyền đối tác nếu cần dữ liệu từ Indeed, còn với phân tích thị trường thì đi thẳng tới nguồn gốc của tin. Phần còn lại của bài xây kịch bản theo hướng đó.
Schema tin tuyển dụng cho crawl Indeed bằng Python
Khi gom tin từ nhiều nguồn, mỗi nguồn đặt tên trường một kiểu. Greenhouse gọi chức danh là title, Lever gọi là text, JSON-LD dùng title nhưng lồng tên công ty trong hiringOrganization. Schema chung là lớp phiên dịch giúp mọi phần sau chỉ làm việc với một định dạng.
Các trường cốt lõi
Schema dưới đây bám theo các thuộc tính của chuẩn JobPosting, vì đây là chuẩn mà nhiều doanh nghiệp đã dùng sẵn. Mỗi trường có kiểu dữ liệu và quy tắc rõ ràng để hai lần chuẩn hoá cùng một tin cho ra cùng kết quả.
- job_key: mã băm dùng để gộp tin trùng, tính từ công ty, chức danh và thành phố đã chuẩn hoá.
- title, company: chuỗi đã gộp khoảng trắng, giữ nguyên chữ hoa để hiển thị.
- city, country: tách từ địa điểm, country theo mã hai chữ cái nếu có.
- remote: 1 nếu tin ghi làm từ xa, 0 nếu không, rỗng nếu không rõ.
- employment_type: FULL_TIME, PART_TIME, CONTRACTOR, INTERN hoặc rỗng.
- salary_min_year, salary_max_year, currency: lương quy về năm, kèm cờ ước tính.
- date_posted: ngày đăng dạng ISO, valid_through: hạn nộp nếu có.
Danh sách cố ý không có tên người tuyển dụng, email hay số điện thoại. Các thông tin này đôi khi xuất hiện trong mô tả công việc, nhưng không cần cho phân tích thị trường và kéo theo nghĩa vụ bảo vệ dữ liệu cá nhân.
Quy lương về một đơn vị
Định nghĩa JobPosting trên schema.org cho phép baseSalary là một MonetaryAmount với giá trị kèm unitText như HOUR, DAY, WEEK, MONTH hoặc YEAR. Muốn so sánh, anh em phải quy về một đơn vị chung. Bài chọn đơn vị năm và ghi rõ hệ số quy đổi.
Hệ số dùng trong bài là 2.080 giờ, 260 ngày, 52 tuần và 12 tháng mỗi năm. Đây là quy ước làm tròn cho công việc toàn thời gian, không đúng với mọi hợp đồng. Vì vậy, mỗi dòng có cột salary_estimated bằng 1 khi giá trị năm được suy ra từ đơn vị khác, để người đọc báo cáo biết con số nào là gốc.
Bảng nguồn tách riêng
Một tin sau khi gộp có thể đến từ hai hoặc ba nguồn. Bảng jobs giữ thông tin đã gộp, bảng job_sources giữ từng lần thấy tin ở từng nguồn, kèm id gốc, URL và thời điểm thu. Nhờ tách bảng, anh em luôn truy ngược được một dòng phân tích về đúng trang gốc.
Tóm lại, schema tốt cho tin tuyển dụng là schema bám chuẩn có sẵn, quy lương về một đơn vị có ghi chú và tách nguồn ra bảng riêng. Ba nguyên tắc này làm nền cho bước chống trùng.
Chuẩn bị môi trường cho crawl Indeed bằng Python
Lab dùng Python 3.12 với Requests để gọi API công khai, BeautifulSoup để đọc khối JSON-LD và sqlite3 có sẵn để lưu. Toàn bộ ví dụ chạy trên dữ liệu mẫu đặt ngay trong code, nên không có request nào rời khỏi máy khi thử.
Cài đặt và ghi phiên bản
Tạo môi trường ảo riêng cho dự án để không ảnh hưởng các công cụ khác. Khi ProxyVN chạy lab, phiên bản là Requests 2.34.2 và beautifulsoup4 4.15.0 trên Python 3.12.10.
python -m venv .venv
.\.venv\Scripts\Activate.ps1
python -m pip install requests beautifulsoup4
python -m pip freeze > requirements-lock.txt
Tệp khoá phiên bản giúp đồng nghiệp dựng lại đúng môi trường khi chạy lại phân tích sau vài tháng. Với dự án dữ liệu, tái lập được kết quả quan trọng không kém việc lấy được dữ liệu.
Bộ dữ liệu mẫu ba nguồn
Bộ mẫu gồm một trang nghề nghiệp có JSON-LD, một phản hồi kiểu Greenhouse và một phản hồi kiểu Lever. Ba nguồn cố ý chứa cùng một vị trí Data Engineer của cùng công ty, viết hơi khác nhau, để kiểm tra bước gộp. Tên công ty và tin là giả lập, không phải doanh nghiệp thật.
import json
import re
import hashlib
import sqlite3
from datetime import datetime, timezone
from bs4 import BeautifulSoup

CAREER_HTML = """<html><head><title>Data Engineer</title>
<script type="application/ld+json">
{"@context": "https://schema.org", "@type": "JobPosting",
 "title": "Data Engineer ", "datePosted": "2026-10-15", "validThrough": "2026-11-30T23:59",
 "employmentType": "FULL_TIME",
 "hiringOrganization": {"@type": "Organization", "name": "Acme Analytics, Inc."},
 "jobLocation": {"@type": "Place", "address": {"@type": "PostalAddress",
   "addressLocality": "Austin", "addressRegion": "TX", "addressCountry": "US"}},
 "baseSalary": {"@type": "MonetaryAmount", "currency": "USD",
   "value": {"@type": "QuantitativeValue", "minValue": 45, "maxValue": 60, "unitText": "HOUR"}}}
</script></head><body>...</body></html>"""

GREENHOUSE_JSON = {"jobs": [
    {"id": 4011, "title": "Data Engineer", "updated_at": "2026-10-16T09:00:00-05:00",
     "location": {"name": "Austin, TX"},
     "absolute_url": "https://boards.example.com/acme/jobs/4011"},
    {"id": 4012, "title": "Product Analyst", "updated_at": "2026-10-10T09:00:00-05:00",
     "location": {"name": "Remote"},
     "absolute_url": "https://boards.example.com/acme/jobs/4012"}]}

LEVER_JSON = [
    {"id": "b7c1-demo", "text": "Data  Engineer", "hostedUrl": "https://jobs.example.com/acme/b7c1-demo",
     "createdAt": 1760600000000, "workplaceType": "on-site",
     "categories": {"location": "Austin, TX", "commitment": "Full-time", "team": "Data"}}]
Ba nguồn có ba cách ghi thời gian khác nhau: ngày thuần, ISO có múi giờ và số mili giây epoch. Đây là chuyện thường gặp khi gom dữ liệu thật, và là lý do bước chuẩn hoá cần hàm riêng cho từng nguồn.
Hàm gọi API thật để dành cho sau
Hai hàm dưới chỉ được định nghĩa, không chạy trong lab. Khi anh em đã có danh sách board_token hoặc tên site của công ty mục tiêu, và đã xem điều khoản của họ, mới gọi các hàm này với khoảng nghỉ giữa các công ty.
import time
import requests

UA = {"User-Agent": "job-market-lab/0.1 (contact: you@example.com)"}

def fetch_greenhouse(board_token, session=None):
    s = session or requests.Session()
    r = s.get(f"https://boards-api.greenhouse.io/v1/boards/{board_token}/jobs",
              headers=UA, timeout=(10, 30))
    r.raise_for_status()
    return r.json()

def fetch_lever(site, session=None, page_size=100):
    s = session or requests.Session()
    out, skip = [], 0
    while True:
        r = s.get(f"https://api.lever.co/v0/postings/{site}",
                  params={"mode": "json", "skip": skip, "limit": page_size},
                  headers=UA, timeout=(10, 30))
        r.raise_for_status()
        batch = r.json()
        out.extend(batch)
        if len(batch) < page_size:
            return out
        skip += page_size
        time.sleep(1)
Hàm Lever dừng khi một trang trả ít hơn page_size mục, dấu hiệu đã tới trang cuối. User-Agent ghi tên dự án và địa chỉ liên hệ để bên vận hành API biết ai đang gọi. Tóm lại, môi trường lab gồm thư viện có ghi phiên bản, dữ liệu mẫu ba nguồn và hàm gọi thật tách riêng.
Chuẩn hoá ba nguồn khi crawl Indeed bằng Python
Bước chuẩn hoá biến ba định dạng thành một. Mỗi nguồn có một hàm riêng, cùng trả về dict theo schema chung. Phần này là ví dụ triển khai do ProxyVN viết, đã chạy với bộ dữ liệu mẫu ở trên.
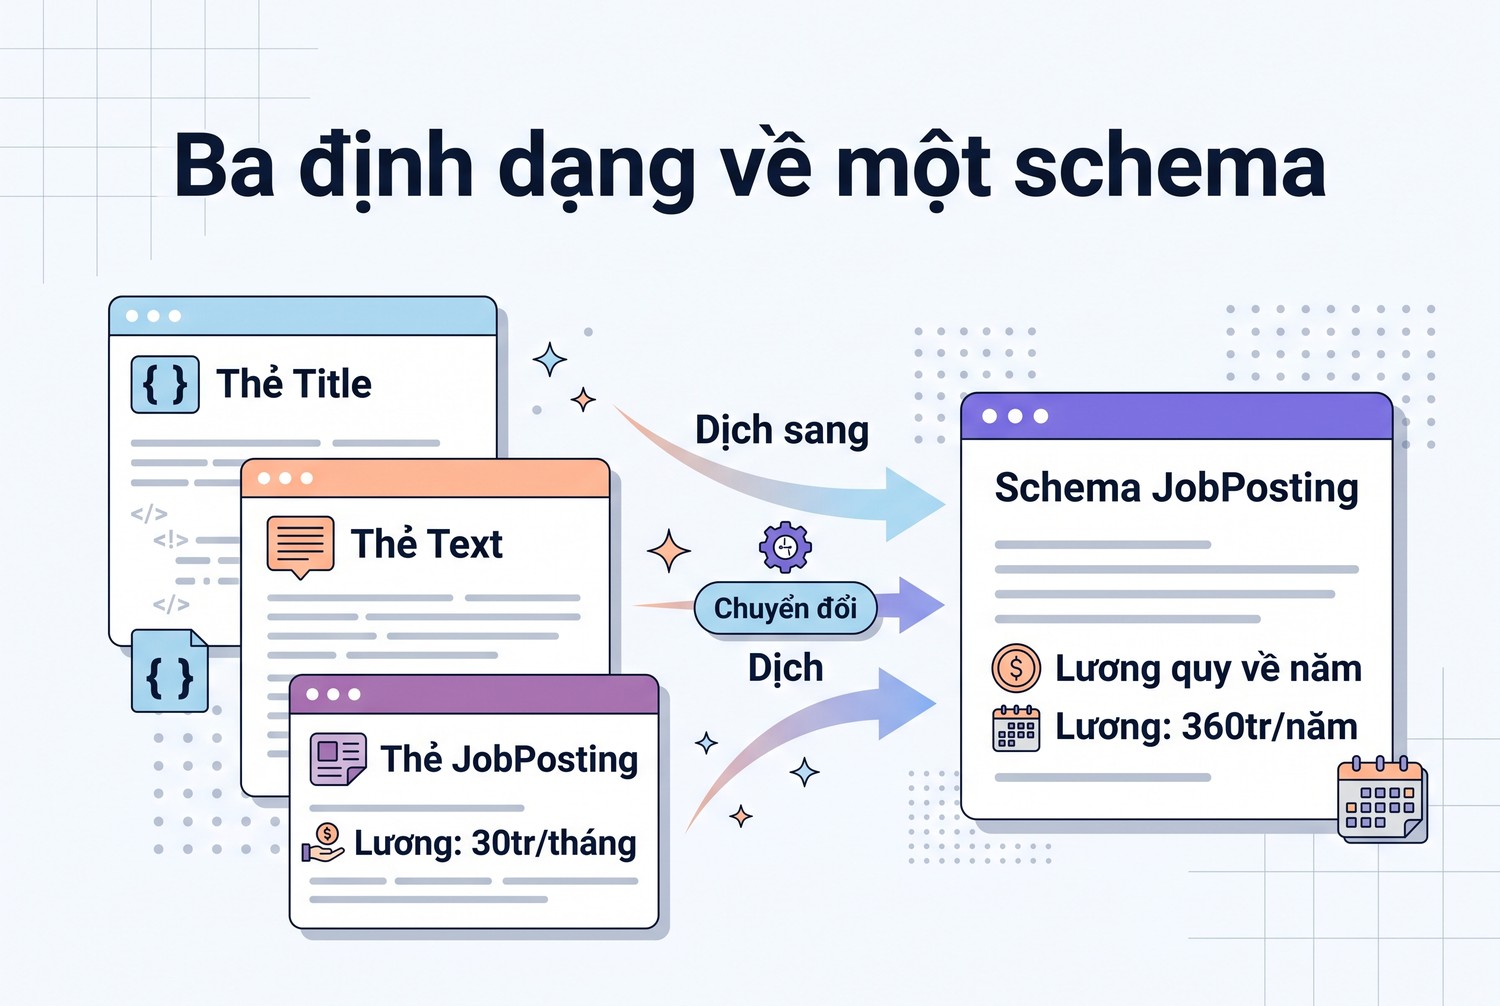
Ba định dạng về một schema
Hàm dùng chung cho chuỗi, địa điểm và lương
Các hàm nhỏ dưới xử lý những việc lặp lại: gộp khoảng trắng, tách thành phố, nhận diện làm từ xa và quy lương về năm. Tách thành hàm riêng giúp sửa một chỗ là áp dụng cho mọi nguồn.
PER_YEAR = {"HOUR": 2080, "DAY": 260, "WEEK": 52, "MONTH": 12, "YEAR": 1}
COMPANY_SUFFIX = re.compile(r"[,\s]+(inc|llc|ltd|co|corp|corporation|gmbh)\.?$", re.I)

def clean(s):
    return " ".join(str(s or "").split())

def split_location(text):
    text = clean(text)
    if not text or text.lower() in ("remote", "anywhere"):
        return "", "", 1 if text else None
    parts = [p.strip() for p in text.split(",")]
    return parts[0], (parts[2] if len(parts) > 2 else ""), 0

def yearly(amount, unit):
    if amount is None:
        return None, 0
    factor = PER_YEAR.get((unit or "YEAR").upper(), 1)
    return round(float(amount) * factor), int(factor != 1)

def job_key(company, title, city):
    c = COMPANY_SUFFIX.sub("", clean(company).lower())
    t = re.sub(r"[^a-z0-9 ]", "", clean(title).lower())
    raw = f"{c}|{t}|{clean(city).lower()}"
    return hashlib.sha1(raw.encode("utf-8")).hexdigest()[:16]
Hàm job_key bỏ hậu tố pháp lý như Inc hay LLC, bỏ dấu câu trong chức danh và đưa về chữ thường. Nhờ vậy, "Acme Analytics, Inc." và "Acme Analytics" cho cùng một khoá, còn "Data Engineer " và "Data Engineer" cũng không bị coi là hai tin.
Ba hàm đọc ba nguồn
Mỗi hàm nhận dữ liệu thô của một nguồn và trả danh sách bản ghi chuẩn. Hàm đọc JSON-LD tìm mọi khối script có kiểu application/ld+json rồi lọc ra đối tượng JobPosting.
def from_jsonld(html, url, company_hint=""):
    soup = BeautifulSoup(html, "html.parser")
    out = []
    for tag in soup.find_all("script", type="application/ld+json"):
        try:
            data = json.loads(tag.string or "")
        except json.JSONDecodeError:
            continue
        for d in data if isinstance(data, list) else [data]:
            if d.get("@type") != "JobPosting":
                continue
            addr = ((d.get("jobLocation") or {}).get("address") or {})
            val = ((d.get("baseSalary") or {}).get("value") or {})
            lo, est = yearly(val.get("minValue"), val.get("unitText"))
            hi, _ = yearly(val.get("maxValue"), val.get("unitText"))
            company = (d.get("hiringOrganization") or {}).get("name") or company_hint
            out.append({"source": "jsonld", "source_id": url, "url": url,
                        "title": clean(d.get("title")), "company": clean(company),
                        "city": clean(addr.get("addressLocality")),
                        "country": clean(addr.get("addressCountry")),
                        "remote": 1 if d.get("jobLocationType") == "TELECOMMUTE" else 0,
                        "employment_type": clean(d.get("employmentType")),
                        "salary_min_year": lo, "salary_max_year": hi,
                        "currency": (d.get("baseSalary") or {}).get("currency", ""),
                        "salary_estimated": est,
                        "date_posted": clean(d.get("datePosted"))[:10],
                        "valid_through": clean(d.get("validThrough"))[:10]})
    return out

def from_greenhouse(payload, company):
    out = []
    for j in payload.get("jobs", []):
        city, country, remote = split_location((j.get("location") or {}).get("name"))
        out.append({"source": "greenhouse", "source_id": str(j["id"]), "url": j["absolute_url"],
                    "title": clean(j["title"]), "company": company, "city": city,
                    "country": country, "remote": remote, "employment_type": "",
                    "salary_min_year": None, "salary_max_year": None, "currency": "",
                    "salary_estimated": 0, "date_posted": j.get("updated_at", "")[:10],
                    "valid_through": ""})
    return out

COMMITMENT = {"full-time": "FULL_TIME", "part-time": "PART_TIME",
              "contract": "CONTRACTOR", "intern": "INTERN"}

def from_lever(postings, company):
    out = []
    for p in postings:
        cat = p.get("categories") or {}
        city, country, remote = split_location(cat.get("location"))
        if p.get("workplaceType") == "remote":
            remote = 1
        posted = datetime.fromtimestamp(p["createdAt"] / 1000, tz=timezone.utc).date().isoformat()
        out.append({"source": "lever", "source_id": p["id"], "url": p["hostedUrl"],
                    "title": clean(p["text"]), "company": company, "city": city,
                    "country": country, "remote": remote,
                    "employment_type": COMMITMENT.get(clean(cat.get("commitment")).lower(), ""),
                    "salary_min_year": None, "salary_max_year": None, "currency": "",
                    "salary_estimated": 0, "date_posted": posted, "valid_through": ""})
    return out
Với Greenhouse, ngày đăng trong bài tạm lấy từ updated_at vì danh sách cơ bản không có trường ngày đăng riêng. Đây là một giả định cần ghi trong tài liệu dự án, vì ngày cập nhật có thể muộn hơn ngày đăng thật. Với Lever, createdAt là mili giây epoch nên phải chia 1.000 trước khi đổi sang ngày.
Vì sao không gộp ngay trong hàm đọc
Mỗi hàm đọc chỉ làm một việc là phiên dịch. Bước gộp tin trùng nằm ở tầng riêng phía sau, nhận đầu vào từ mọi nguồn. Thiết kế này giúp thêm nguồn thứ tư mà không phải sửa logic gộp, chỉ cần viết thêm một hàm đọc.
Tóm lại, chuẩn hoá tốt là chuẩn hoá có hàm riêng cho từng nguồn và hàm dùng chung cho các phép biến đổi lặp lại. Mỗi giả định như ngày đăng của Greenhouse cần được ghi lại thành văn bản.
Chống trùng và lưu trữ khi crawl Indeed bằng Python
Cùng một vị trí xuất hiện ở trang nghề nghiệp, Greenhouse và Lever là chuyện bình thường. Nếu không gộp, báo cáo sẽ đếm một vị trí thành ba và thổi phồng nhu cầu tuyển dụng. Bước này giải quyết vấn đề bằng job_key và hai bảng SQLite.
Logic gộp theo job_key
Mọi bản ghi được tính job_key. Bản ghi đầu tiên của mỗi khoá tạo dòng mới trong bảng jobs. Các bản ghi sau cùng khoá chỉ bổ sung trường còn trống, ví dụ lương lấy từ JSON-LD khi nguồn ATS không có, và luôn được thêm vào bảng job_sources.
JOB_COLS = ["job_key", "title", "company", "city", "country", "remote", "employment_type",
            "salary_min_year", "salary_max_year", "currency", "salary_estimated",
            "date_posted", "valid_through", "first_seen", "last_seen"]

def open_jobs_db(path="jobs.db"):
    con = sqlite3.connect(path)
    con.execute(f"CREATE TABLE IF NOT EXISTS jobs ({', '.join(JOB_COLS)}, PRIMARY KEY (job_key))")
    con.execute("""CREATE TABLE IF NOT EXISTS job_sources (
        job_key TEXT, source TEXT, source_id TEXT, url TEXT, seen_at TEXT,
        PRIMARY KEY (source, source_id))""")
    return con

def merge_records(con, records, seen_at):
    for r in records:
        key = job_key(r["company"], r["title"], r["city"])
        row = con.execute("SELECT * FROM jobs WHERE job_key=?", (key,)).fetchone()
        if row is None:
            vals = {**r, "job_key": key, "first_seen": seen_at, "last_seen": seen_at}
            con.execute(f"INSERT INTO jobs VALUES ({', '.join('?' for _ in JOB_COLS)})",
                        [vals.get(c) for c in JOB_COLS])
        else:
            cur = dict(zip(JOB_COLS, row))
            for c in JOB_COLS[1:13]:
                if cur[c] in (None, "") and r.get(c) not in (None, ""):
                    con.execute(f"UPDATE jobs SET {c}=? WHERE job_key=?", (r[c], key))
            con.execute("UPDATE jobs SET last_seen=? WHERE job_key=?", (seen_at, key))
        con.execute("INSERT OR REPLACE INTO job_sources VALUES (?, ?, ?, ?, ?)",
                    (key, r["source"], r["source_id"], r["url"], seen_at))
    con.commit()
Khoá chính của job_sources là cặp nguồn và id gốc. Chạy lại kịch bản với cùng dữ liệu không sinh dòng mới, chỉ cập nhật thời điểm thấy gần nhất.
Chạy với bộ mẫu và đọc kết quả
Đoạn dưới đưa cả ba nguồn qua chuẩn hoá và gộp, sau đó in số tin, số dòng nguồn và thông tin lương đã gộp của vị trí Data Engineer.
now = datetime.now(timezone.utc).isoformat(timespec="seconds")
records = (from_jsonld(CAREER_HTML, "https://careers.example.com/data-engineer")
           + from_greenhouse(GREENHOUSE_JSON, "Acme Analytics")
           + from_lever(LEVER_JSON, "Acme Analytics"))
con = open_jobs_db(":memory:")
merge_records(con, records, now)
print("Bản ghi đầu vào:", len(records))
print("Tin sau gộp:", con.execute("SELECT COUNT(*) FROM jobs").fetchone()[0])
print("Dòng nguồn:", con.execute("SELECT COUNT(*) FROM job_sources").fetchone()[0])
print(con.execute("""SELECT title, city, salary_min_year, salary_max_year, salary_estimated,
                     employment_type FROM jobs WHERE title LIKE 'Data%'""").fetchone())
Trong lab của ProxyVN, bốn bản ghi đầu vào gộp thành hai tin: Data Engineer tại Austin và Product Analyst làm từ xa. Bảng nguồn có bốn dòng. Vị trí Data Engineer mang lương năm từ 93.600 tới 124.800 USD, cờ ước tính bằng 1 vì giá trị gốc tính theo giờ, và loại hình FULL_TIME lấy từ JSON-LD.
Khi nào hai tin giống mà không phải một
Khoá dựa trên công ty, chức danh và thành phố có điểm yếu: một công ty tuyển hai người cùng vị trí ở cùng thành phố bằng hai tin riêng sẽ bị gộp làm một. Với phân tích xu hướng, sai số này thường chấp nhận được. Với đếm chính xác số chỗ trống, anh em nên thêm id gốc vào khoá khi hai tin cùng đến từ một nguồn.
Gộp quá tay làm mất tin thật, gộp quá ít làm thổi phồng nhu cầu. Hãy chọn mức gộp theo câu hỏi phân tích, và ghi lại lựa chọn đó.
Kết luận của phần này: job_key giải quyết phần lớn trường hợp trùng giữa các nguồn, còn bảng job_sources giữ lại toàn bộ dấu vết để kiểm tra khi nghi ngờ.
Kiểm tra robots.txt và lịch cập nhật khi crawl Indeed bằng Python
Ngay cả với nguồn công khai như trang nghề nghiệp của doanh nghiệp, kịch bản nên tự kiểm tra robots.txt trước khi tải. Đây là phép lịch sự tối thiểu và giúp tránh tải nhầm khu vực mà chủ website không muốn bot vào. Phần này cũng bàn về tần suất làm mới dữ liệu tin tuyển dụng.
Đọc robots.txt bằng thư viện chuẩn
Module urllib.robotparser của Python đọc nội dung robots.txt và trả lời một URL có được phép với một User-Agent hay không. Ví dụ dưới nạp nội dung robots.txt từ chuỗi để chạy offline. Khi chạy thật, anh em tải tệp một lần cho mỗi tên miền rồi lưu lại.
from urllib.robotparser import RobotFileParser

ROBOTS_SAMPLE = """User-agent: *
Disallow: /applystart
Disallow: /cmp/*/people
Allow: /
Crawl-delay: 5
"""

def robots_for(text):
    rp = RobotFileParser()
    rp.parse(text.splitlines())
    return rp

rp = robots_for(ROBOTS_SAMPLE)
for path in ["/jobs/data-engineer", "/applystart?jk=1"]:
    print(path, rp.can_fetch("job-market-lab", "https://example.com" + path))
print("crawl-delay:", rp.crawl_delay("job-market-lab"))
Kết quả lab: đường dẫn tin được phép, đường dẫn ứng tuyển bị chặn, độ trễ yêu cầu là 5 giây. Có một chi tiết ProxyVN gặp khi dựng lab: module chuẩn áp dụng quy tắc khớp đầu tiên theo thứ tự trong tệp. Khi dòng Allow: / đứng trước các dòng Disallow, như cách nhiều website viết, module trả về được phép cho mọi đường dẫn.
Chuẩn RFC 9309 về robots.txt quy định chọn quy tắc khớp dài nhất, không phụ thuộc thứ tự. Module chuẩn cũng không hiểu dấu sao ở giữa đường dẫn. Vì vậy, với tệp robots.txt thật, anh em đọc thêm bằng mắt hoặc dùng thư viện phân tích theo đúng RFC trước khi tin vào kết quả.
Tần suất làm mới hợp lý
Tin tuyển dụng thay đổi chậm. Phần lớn tin tồn tại vài tuần, lương và chức danh ít khi sửa sau khi đăng. Làm mới mỗi ngày một lần là đủ cho phân tích thị trường, và nhiều nguồn chỉ cần mỗi tuần.
Trường last_seen trong bảng jobs cho biết lần cuối thấy tin còn hiển thị. Tin không xuất hiện sau hai hoặc ba lần làm mới có thể đánh dấu đã đóng thay vì xoá. Cách này giữ được dữ liệu lịch sử để tính thời gian một vị trí mở trung bình.
Ghi nhận thời điểm và nguồn
Mỗi dòng trong job_sources đã có thời điểm thấy. Khi công bố số liệu, anh em ghi rõ khoảng thời gian thu thập và danh sách nguồn. Người đọc báo cáo cần biết số liệu phản ánh thị trường lúc nào, từ những công ty nào.
Tóm lại, robots.txt là bước kiểm tra kỹ thuật, điều khoản là bước kiểm tra pháp lý, và lịch làm mới hằng ngày hoặc hằng tuần là đủ cho dữ liệu tuyển dụng.
Xử lý lỗi khi crawl Indeed bằng Python
Lỗi trong dự án gom tin tuyển dụng thường không nằm ở kết nối mà ở dữ liệu. Một nguồn đổi định dạng ngày, một trang thiếu khối JSON-LD, một công ty đổi board_token. Bắt được các lỗi này sớm giúp bảng dữ liệu không bị thủng mà không ai hay.
Lỗi mạng và mã trạng thái
Nhóm này dễ nhận diện vì có mã HTTP rõ ràng. Danh sách dưới ghi dấu hiệu và cách xử lý cho từng mã thường gặp với API bảng tin công khai.
- 404 từ API bảng tin: board_token hoặc tên site sai, hoặc công ty đã đổi nhà cung cấp hệ thống tuyển dụng.
- 429: gửi quá nhanh; tăng khoảng nghỉ và đọc header Retry-After nếu có.
- 403 từ trang nghề nghiệp: website không cho phép truy cập tự động; bỏ nguồn đó khỏi danh sách.
- Timeout: kiểm tra mạng của máy chạy trước khi nghi ngờ nguồn dữ liệu.
Tài liệu MDN về mã 429 giải thích header Retry-After cho biết thời gian nên chờ. Khi gặp 403 hoặc CAPTCHA, ProxyVN khuyên dừng nguồn đó thay vì tìm cách vượt qua.
Lỗi dữ liệu âm thầm
Nguy hiểm hơn là lỗi không làm kịch bản dừng. Trang vẫn tải được nhưng khối JSON-LD bị bỏ, hàm from_jsonld trả danh sách rỗng và kịch bản báo thành công. Sau một tháng, anh em mới thấy một công ty biến mất khỏi báo cáo.
Cách phòng là ghi số bản ghi theo từng nguồn sau mỗi lần chạy và so với lần trước. Nguồn nào giảm từ vài chục xuống không, cần cảnh báo ngay.
def source_counts(con):
    return dict(con.execute(
        "SELECT source, COUNT(*) FROM job_sources GROUP BY source").fetchall())

def compare_counts(prev, cur, drop_ratio=0.5):
    alerts = []
    for src, n_prev in prev.items():
        n_cur = cur.get(src, 0)
        if n_prev and n_cur < n_prev * drop_ratio:
            alerts.append(f"{src}: {n_prev} -> {n_cur}")
    return alerts

print(compare_counts({"jsonld": 10, "greenhouse": 2, "lever": 1}, source_counts(con)))
Lab in ra cảnh báo cho nguồn jsonld vì số bản ghi giảm từ 10 xuống 1 trong dữ liệu so sánh giả lập. Ngưỡng một nửa là điểm khởi đầu, anh em chỉnh theo độ dao động thật của từng nguồn.
Kiểm tra trường bắt buộc
Mỗi tin cần ít nhất chức danh, công ty và ngày đăng. Tin thiếu một trong ba nên đưa vào bảng chờ xem xét thay vì bảng chính. Một bảng ít dòng nhưng đúng có giá trị hơn một bảng nhiều dòng mà phải nghi ngờ từng con số.
Tóm lại, xử lý lỗi cho dữ liệu tuyển dụng tập trung vào lỗi âm thầm: đếm theo nguồn, so với lần trước và tách bản ghi thiếu trường bắt buộc.
Khi nào cần proxy cho crawl Indeed bằng Python
Với API bảng tin công khai và dữ liệu JSON-LD từ vài chục công ty, phần lớn dự án chạy tốt từ một IP cố định với tốc độ chậm. Proxy không phải điều kiện bắt buộc. Nó có ích trong vài tình huống cụ thể về mạng và khu vực.
Proxy theo khu vực, không để vượt chặn
Tình huống proxy có ích
Tình huống thứ nhất là cần xem trang nghề nghiệp hiển thị theo khu vực. Một số doanh nghiệp đa quốc gia hiển thị danh sách tin khác nhau tuỳ quốc gia của người truy cập. Proxy đặt tại đúng khu vực giúp thấy đúng phiên bản mà người tìm việc ở đó thấy. Bài proxy nghiên cứu thị trường trên blog ProxyVN bàn sâu hơn về thu thập dữ liệu theo khu vực.
Tình huống thứ hai là tách lưu lượng thu thập khỏi IP văn phòng. Nếu một nguồn chặn IP do lỗi cấu hình tốc độ, mạng nội bộ của công ty không bị ảnh hưởng. Tình huống thứ ba là mạng doanh nghiệp bắt buộc đi qua proxy, khi đó Session của Requests cần khai báo proxy rõ ràng.
Tình huống không dùng proxy
Proxy không được dùng để vượt đăng nhập, vượt CAPTCHA hay lách giới hạn mà một website đặt ra. Nếu Indeed hoặc một trang nghề nghiệp từ chối truy cập tự động, đó là tín hiệu dừng, không phải tín hiệu đổi IP. Với kênh dữ liệu từ Indeed, đường hợp lệ là chương trình đối tác.
Cấu hình và kiểm tra
Khai báo proxy trong Session riêng cho phần tải trang, giữ trust_env bằng False để không lẫn với biến hệ thống. User-Agent có tên dự án và địa chỉ liên hệ, như hướng dẫn trong bài User-Agent là gì. Trước khi chạy, gửi một request tới trang trả IP công khai để xác nhận tuyến mạng.
Khi cần IP cố định cho tác vụ này, anh em có thể mua proxy uy tín tại trang chủ ProxyVN với các gói datacenter Việt Nam, datacenter US hoặc dân cư tĩnh, rồi chạy thử với vài nguồn trước khi mở rộng danh sách. Tóm lại, proxy trong dự án tuyển dụng giải bài toán khu vực và tách mạng, không giải bài toán quyền truy cập.
Checklist trước khi crawl Indeed bằng Python chạy thật
Danh sách dưới gom các bước đã nêu thành việc cần làm trước khi kịch bản chạy định kỳ. Anh em in ra và đánh dấu từng mục cho mỗi nguồn mới thêm vào.
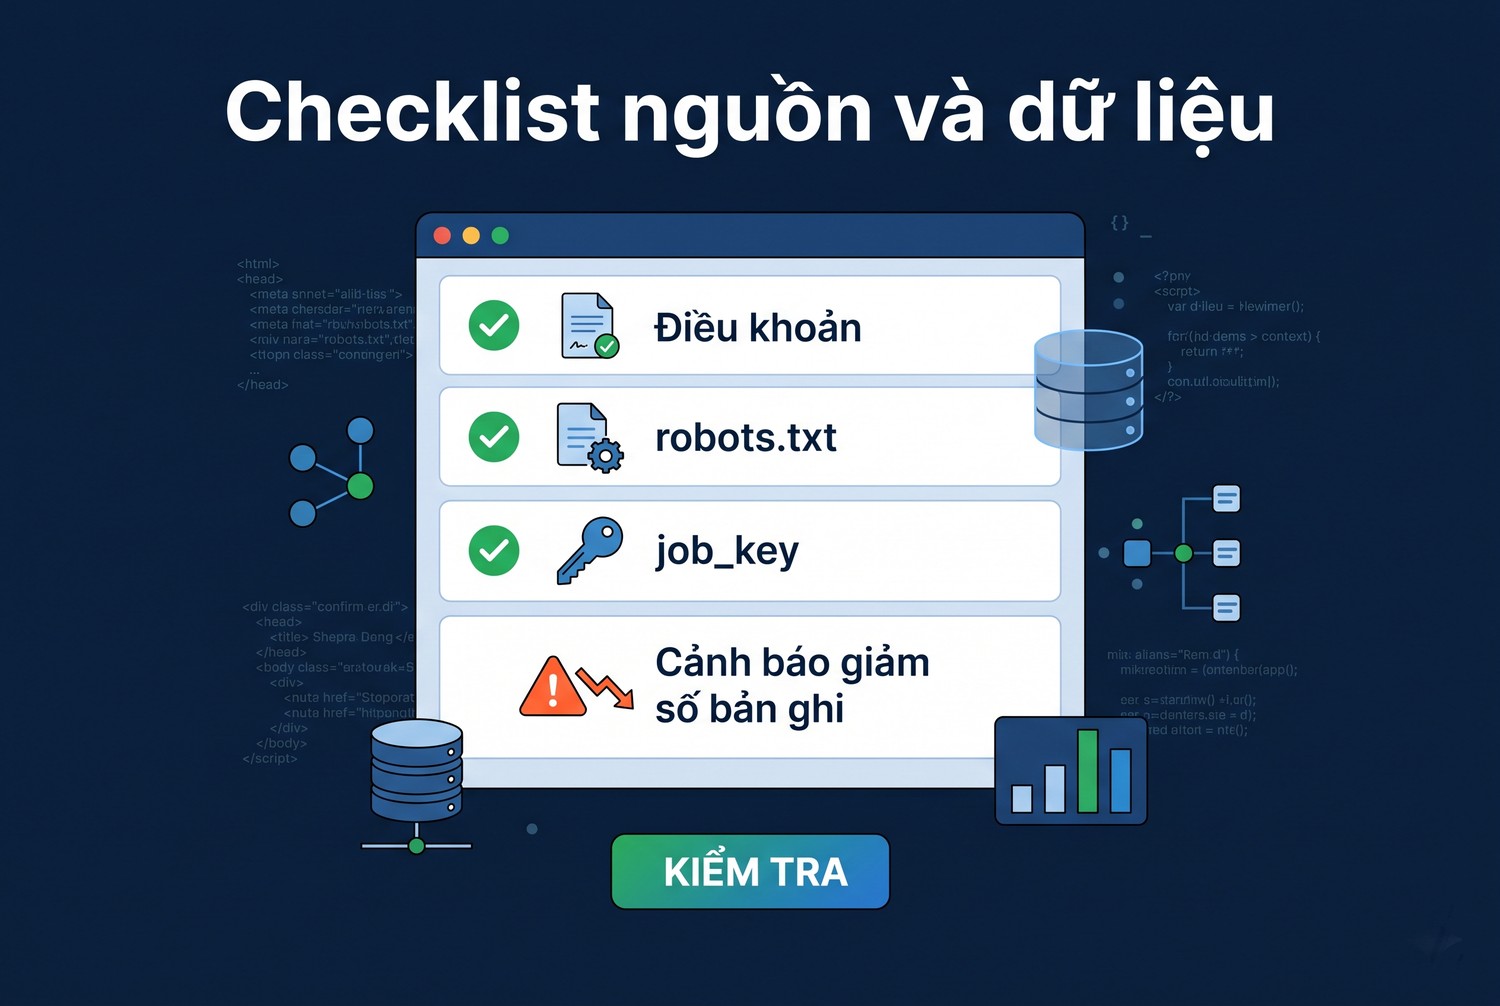
Checklist nguồn và dữ liệu
Về nguồn và quyền
Phần này trả lời câu hỏi được phép hay không. Mọi nguồn phải qua đủ các mục trước khi vào danh sách chạy.
- Đã đọc điều khoản của nguồn và ghi ngày đọc.
- Dữ liệu từ Indeed chỉ lấy qua kênh đối tác được duyệt.
- Đã kiểm tra robots.txt và độ trễ yêu cầu nếu có.
- Không thu tên người tuyển dụng, email, số điện thoại.
- Không dùng tài khoản ứng viên hay nhà tuyển dụng để xem dữ liệu ẩn.
Về kỹ thuật và dữ liệu
Phần này đảm bảo dữ liệu đúng và kịch bản chạy bền. Rà lại mỗi khi thêm nguồn hoặc đổi schema.
- Mỗi nguồn có hàm đọc riêng, trả về schema chung.
- Lương quy về năm có cờ ước tính.
- job_key đã kiểm tra với bộ mẫu có tin trùng.
- Có đếm số bản ghi theo nguồn và cảnh báo khi giảm mạnh.
- Có khoảng nghỉ giữa các request và giữa các công ty.
Về báo cáo
Khi đưa số liệu cho người khác, ghi kèm khoảng thời gian thu thập, danh sách nguồn và các giả định như hệ số quy lương. Người đọc báo cáo cần biết con số đến từ đâu để tin hoặc đặt câu hỏi đúng chỗ. Đây là phần nhiều dự án bỏ qua, và cũng là phần làm nên độ tin cậy.
Kết luận cho phần checklist: kịch bản tuyển dụng tốt có danh sách nguồn được duyệt, schema bám chuẩn JobPosting và báo cáo ghi rõ giả định.
Crawl Indeed bằng Python đúng cách bắt đầu từ việc chọn nguồn được phép: kênh đối tác của Indeed hoặc dữ liệu gốc từ hệ thống tuyển dụng và trang nghề nghiệp. Chuẩn hoá theo JobPosting, gộp bằng job_key rồi mới phân tích. Cần trao đổi về hạ tầng mạng, anh em nhắn Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam trước khi crawl Indeed bằng Python.


