
Apache Nutch proxy theo plugin và chu kỳ crawl
Apache Nutch proxy cần được cấu hình theo release và protocol plugin thực dùng, không chỉ một biến môi trường chung. Bản này thiết kế lab giới hạn một site với seed, segment và đầu ra đối soát. Phần chạy Nutch còn chờ môi trường Java 17 phù hợp, nên chưa có kết quả nghiệm thu runtime. ProxyVN hướng dẫn cách kiểm trên dữ liệu mẫu.
Apache Nutch proxy trong phạm vi bản hướng dẫn chờ lab
Bản nháp này cung cấp cấu hình minh họa và kế hoạch kiểm cho Nutch 1.23, chưa nhận là một triển khai đã chạy. Máy soạn có Java 8, còn release mục tiêu yêu cầu Java 17. Vì vậy các lệnh dưới phải được chạy trong môi trường lab phù hợp trước khi dùng làm hướng dẫn đã nghiệm thu.
Thông báo Nutch 1.23 xác nhận yêu cầu runtime của release. Không nên hạ về một bản cũ tùy tiện chỉ để khớp Java đang có rồi giữ nguyên claim của bản mới. Version là một phần của bằng chứng kỹ thuật cần giữ.
Đầu ra riêng của lab là danh sách URL được fetch, trạng thái parse và dấu vết proxy theo cùng một crawl segment. Mục tiêu không phải viết lại tổng quan web scraping hoặc hướng dẫn cấu hình proxy cho một thư viện HTTP đơn. Cần chứng minh crawler thực dùng tuyến đã chọn.
Crawler theo batch khác một request lẻ
Nutch duy trì trạng thái URL và chia công việc thành các bước. Một seed được đưa vào cơ sở crawl chưa có nghĩa nội dung đã được tải. Một segment được tạo chưa có nghĩa parse đã thành công. Báo cáo cần phản ánh đúng bước thay vì gom mọi thư mục xuất hiện thành kết quả crawl.
Proxy chỉ ảnh hưởng một phần đường fetch theo plugin và cấu hình. Nó không quyết định seed nào được phép, parser giữ nội dung ra sao hay dữ liệu đã được export đúng schema chưa. Thiết kế lab cần tách các điều kiện này để lỗi có thể định vị.
Nếu mục tiêu chỉ kiểm một endpoint, dùng client nhỏ có thể đơn giản hơn. Nhưng khi cần nghiệm thu Nutch, phép thử cuối phải chạy Nutch theo đúng plugin. Một request Python qua cùng proxy không thay thế được bằng chứng runtime crawler đã đọc cấu hình.
Apache Nutch proxy với release và protocol plugin
File cấu hình có thể chứa thuộc tính mà một plugin không sử dụng theo cùng cách. Trước khi viết giá trị, xác định plugin HTTP thực được nạp. Không suy khả năng xác thực hoặc HTTP/2 từ việc một tên thuộc tính xuất hiện trong tệp mặc định.
Release protocol plugin và proxy
Dùng tài liệu của bản đã khóa
nutch-default.xml của release 1.23 là nguồn đối chiếu phù hợp hơn nhánh master đang phát triển. Lưu bản tham chiếu hoặc hash tài liệu trong hồ sơ lab. Nếu chuyển release, đọc lại các ghi chú plugin trước khi tái dùng cấu hình.
Nhánh master có thể chứa tên, mặc định hoặc hành vi chưa thuộc bản triển khai. Chép một thuộc tính mới vào bản cũ có thể không tạo lỗi rõ mà chỉ không có tác dụng. Bằng chứng tốt là cấu hình có hiệu lực cùng log fetch, không chỉ file XML nhìn đúng.
Trong lab đầu, chọn một plugin theo tài liệu release và giữ nguyên trong cả ca direct lẫn qua proxy. Sau khi ca đó đạt, nếu cần plugin khác thì tạo nhóm kiểm mới. Đổi plugin và proxy cùng lúc sẽ làm mất đối chứng về nguyên nhân thay đổi.
Chỉ override phần cần thiết
Giữ tệp mặc định để tham khảo và đặt override trong nutch-site.xml theo cách dự án hỗ trợ. Đừng chép toàn bộ file mặc định vào cấu hình riêng rồi quên version. Một bộ override nhỏ dễ kiểm khác biệt khi nâng cấp hơn.
Ví dụ dưới chỉ minh họa agent và địa chỉ proxy lab không có xác thực. Nó không phải toàn bộ cấu hình đủ chạy mọi job. plugin.includes, filter và những phần còn lại cần được kiểm cùng release trước khi launch.
<configuration>
  <property>
    <name>http.agent.name</name><value>ProxyVN-Lab</value>
  </property>
  <property>
    <name>http.proxy.host</name><value>127.0.0.1</value>
  </property>
  <property>
    <name>http.proxy.port</name><value>8894</value>
  </property>
</configuration>
Hostname và port là hai giá trị theo cấu trúc cấu hình, không phải một URL credentials được ghép vào mọi field. Nếu cần xác thực, dùng các thuộc tính đúng với plugin hỗ trợ và giữ bí mật ngoài bản chia sẻ. Không nhận ca không xác thực là bằng chứng user/password đã tương thích.
Apache Nutch proxy với site lab và scope cố định
Site lab cần đủ đường dẫn để kiểm cả chấp nhận và từ chối. Chỉ có một trang thành công không thể chứng minh crawler tôn trọng scope. Tạo nội dung tự biết nhãn giúp đối chiếu fetch và parse mà không tải website ngoài nhiệm vụ.
Bộ đường dẫn có kỳ vọng trước
Seed là trang gốc có liên kết đến hai trang nội dung a và b. Thêm một đường private bị robots của site lab loại, một liên kết ra host ngoài scope và một response lỗi có chủ đích. Ghi expected set trước khi chạy để không lấy kết quả thực làm nhãn đúng.
Hai trang nội dung nên có marker khác nhau như nutch-lab-a và nutch-lab-b. Nếu output export đều chứa cùng marker, có thể crawler nhận nhầm body hoặc bước xuất ghép sai URL. Một đoạn chữ chung ở mọi trang không giúp phát hiện lỗi này.
Origin lab cần ghi đường dẫn, thời điểm và agent của request. Proxy lab ghi target và trạng thái chuyển tiếp. Không cần credentials thật hoặc nội dung khách hàng cho ca này. Các log đủ để nối một URL với lần fetch qua tuyến dự kiến.
Filter không chỉ là seed list
Seed chỉ là điểm bắt đầu; liên kết khám phá có thể dẫn ra ngoài nếu filter cho phép. Thiết kế allowlist theo host, port và đường dẫn của site thử. Không giữ một dòng chấp nhận mọi URL phía sau rồi cho rằng dòng cho phép domain đã giới hạn đủ.
Ví dụ regex cần được kiểm trên URL tốt, URL gần giống và URL ngoài host. Trong môi trường lab có cổng riêng, port phải được xét theo mục tiêu. Không dùng phép contains tên domain vì nó có thể nhận một hostname khác có cùng chuỗi con.
Tutorial chính thức của Nutch mô tả seed và filter theo chu kỳ crawl. Khi áp dụng, giữ các bước chuẩn và kiểm cấu hình có hiệu lực của release. Bài không đề xuất tắt robots hoặc mở rộng scope để làm số trang fetch tăng.
Apache Nutch proxy qua inject generate fetch parse
Chu kỳ cần được chạy từng bước ở lần nghiệm thu đầu để biết lỗi xảy ra ở đâu. Một script gộp có thể thuận tiện sau khi bộ nhỏ đã đúng. Trước đó, giữ output và mã thoát của từng lệnh để không bỏ qua một bước thất bại.
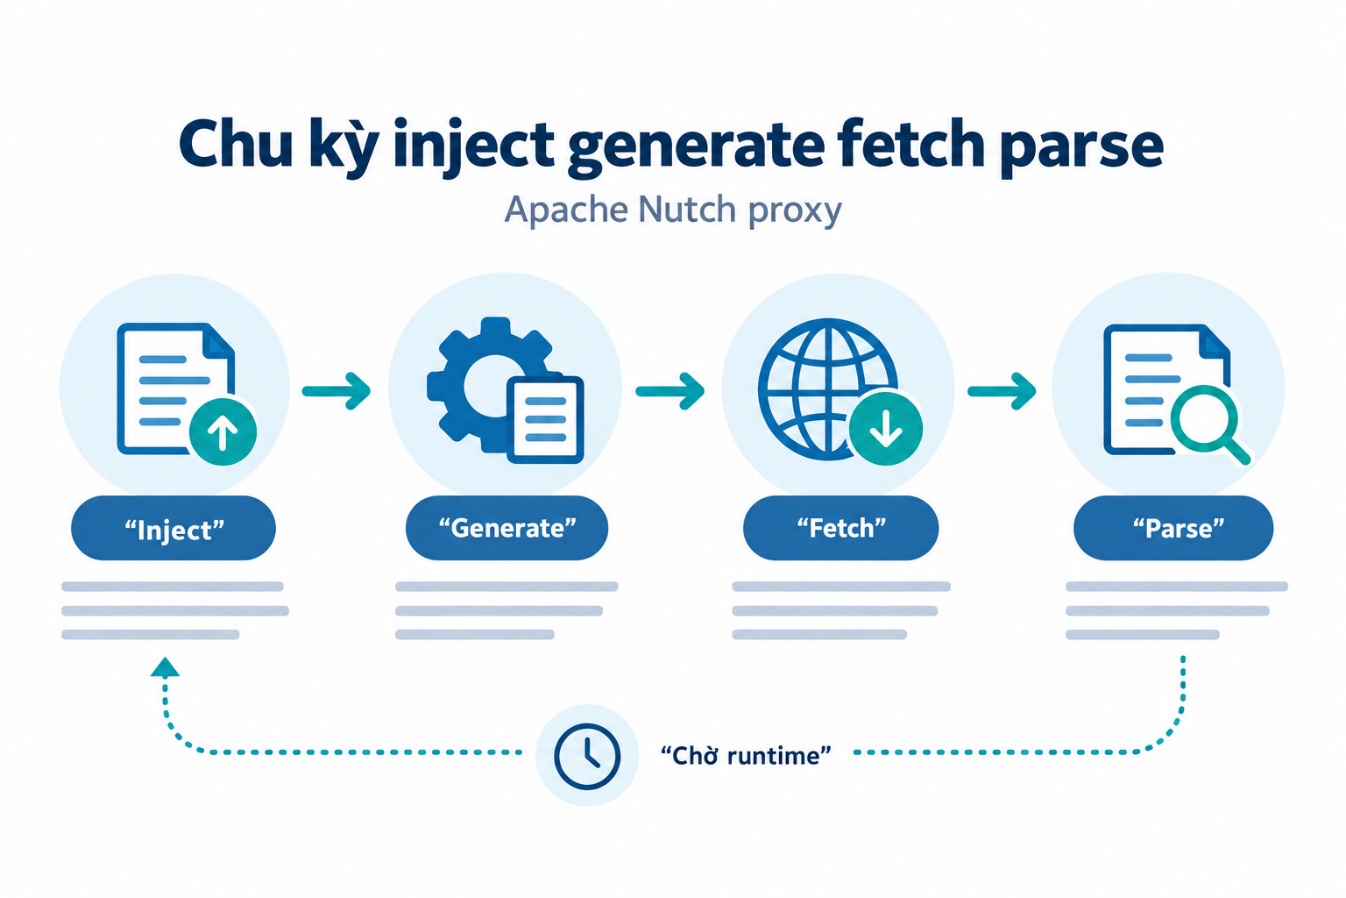
Chu kỳ inject generate fetch parse
Đưa seed vào cơ sở crawl và tạo segment
Trong môi trường Unix hoặc môi trường tương thích được release hỗ trợ, tạo thư mục seed riêng chỉ chứa site lab. Chạy inject rồi generate với quy mô nhỏ. Các đường dẫn trong ví dụ thuộc workspace lab mới, không trỏ vào một CrawlDb production đang có.
bin/nutch inject crawl/crawldb urls
bin/nutch generate crawl/crawldb crawl/segments -topN 5
Giá trị năm là giới hạn tự chọn cho bộ thử nhỏ, không phải mặc định hoặc khuyến nghị tải thật. Sau generate, đọc tên segment vừa được công cụ tạo và ghi nó vào biên bản. Không chọn segment bằng một giả định ngày hoặc một đường dẫn từ lần chạy trước.
Nếu generate không có URL cần fetch, kiểm seed, lịch trạng thái và filter trước khi đổi proxy. Chưa có fetch thì chưa có bằng chứng tuyến mạng. Một job kết thúc nhanh không tự có nghĩa proxy hoạt động tốt.
Fetch và parse theo cùng segment đã ghi
Thay SEGMENT_ID dưới đây bằng tên segment thực từ ca lab, không chạy nguyên placeholder. Giữ ít thread cho lượt nhỏ để dễ đọc log. Sau mỗi lệnh, kiểm kết quả trước khi chạy bước tiếp theo.
bin/nutch fetch crawl/segments/SEGMENT_ID -threads 1
bin/nutch parse crawl/segments/SEGMENT_ID
bin/nutch updatedb crawl/crawldb crawl/segments/SEGMENT_ID
Fetch cần được đối chiếu với log origin và proxy. Parse cần được đối chiếu với marker trong nội dung đã thu. Updatedb cập nhật trạng thái theo chu kỳ, nhưng không thay thế việc kiểm body và text của segment cụ thể.
Không suy rằng số URL trong CrawlDb bằng số trang thành công. Cơ sở này còn có thể biết URL chưa fetch hoặc trạng thái khác. Báo riêng tập đã biết, tập được lên lịch, tập fetch và tập parse đạt theo tiêu chí lab.
Apache Nutch proxy với bằng chứng tuyến thực
Một cấu hình trỏ proxy chưa chứng minh request đã đi qua đó. Bypass, plugin khác hoặc đường cấu hình không được nạp có thể làm crawler đi thẳng. Ma trận direct và qua relay cần có cách nhận diện riêng trong log.
Đối chứng trước và sau bật proxy
Lượt direct dùng workspace lab hoặc trạng thái được đặt lại có kiểm soát, ghi request tại origin. Lượt qua proxy dùng cùng tập seed và nội dung, có log relay tương ứng. Không dùng kết quả của một CrawlDb đã lưu trạng thái khác rồi so như hai đầu vào giống nhau.
Một proxy lab bị dừng có chủ đích có thể giúp kiểm cấu hình có thực được dùng. Khi đó request cần thất bại ở chặng phù hợp thay vì âm thầm đi thẳng nếu hợp đồng không cho fallback. Chỉ dừng relay do bài thử tạo, không dừng dịch vụ đang dùng chung.
Không lấy header IP từ một endpoint khác làm bằng chứng tuyến của toàn bộ segment. Crawl có thể fetch nhiều URL, và một số nhánh có bypass khác nhau. Nối log theo target của từng URL mục tiêu sẽ đáng tin hơn một ảnh kiểm IP riêng lẻ.
DNS và HTTPS cần ca riêng
Với HTTPS, proxy và plugin có thể dùng cơ chế tunnel hoặc thư viện nền theo triển khai. Kiểm hostname, trust và lỗi chứng chỉ bằng endpoint lab phù hợp. Không tắt kiểm chứng chỉ để làm một ca xanh rồi nhận đó là cấu hình TLS đã nghiệm thu.
DNS có thể được xử lý ở các ranh giới khác theo stack. Ghi điều quan sát được thay vì khẳng định mọi tên đều được giải ở proxy. Nếu cần chính sách không đi thẳng, kiểm cả kết nối không mong muốn bằng công cụ được phép ở môi trường lab.
Trước khi mua proxy cho Nutch, mô tả plugin, giao thức và cách xác thực cần dùng. Không tuyên bố tương thích ProxyVN chỉ từ việc file cấu hình có http.proxy.host. Bản này chưa chạy gateway thương mại hoặc runtime Nutch.
Apache Nutch proxy với segment và export dữ liệu
Đầu ra cần giữ được URL, trạng thái và nội dung tương ứng. Segment là một đơn vị xử lý theo crawler, không phải một tệp CSV sẵn cho mọi tác vụ. Cách export cần được chọn và kiểm theo version cùng schema downstream.
Segment raw content và text
Phần đối soát |
Kỳ vọng lab |
Điều chưa thể suy |
|---|---|---|
Seed |
Chỉ có site thử |
Mọi outlink đều trong scope |
Fetch |
URL được phép có log |
Parser đã giữ text đúng |
Parse |
Marker đúng theo URL |
Index tìm kiếm đã cập nhật |
Export |
Record có nguồn và trạng thái |
Toàn bộ website đã được thu |
Phân biệt content với parsed text
Raw content giúp kiểm response đã nhận, còn parsed text là sản phẩm của parser. Nếu marker có ở content nhưng không có ở text, điều tra plugin parse. Nếu content đã là trang lỗi hoặc đăng nhập, sửa bước thu trước thay vì tối ưu selector.
Giữ MIME type và trạng thái tệp bị cắt nếu công cụ có thông tin đó. Một tài liệu lớn bị giới hạn byte có thể tạo parsed text một phần. Không đưa vào bảng “đầy đủ” chỉ vì parser tạo ra một chuỗi không rỗng.
Nếu downstream cần cấu trúc sản phẩm hoặc bảng, parse text chung chưa đáp ứng toàn bộ. Cần bước trích riêng với schema và expected output. Nutch quản lý chu kỳ thu không thay cho mọi logic chuẩn hóa dữ liệu nghiệp vụ.
Export cần một mẫu đọc lại
Chọn công cụ đọc segment hoặc bước xuất được release hỗ trợ, kiểm help trước khi chạy. Lưu mẫu nhỏ có URL và marker để xác nhận mapping. Bản nháp không đưa một lệnh export chưa chạy thành kết quả đã được xác nhận.
Sau xuất, đọc lại bằng đúng công cụ downstream và so số record, khóa nguồn cùng nội dung marker. Nếu số lượng thay đổi, giải thích qua tập trạng thái hoặc quy tắc loại. Đừng bỏ record lỗi rồi chỉ báo số cuối mà không có đối soát.
Không ghi đè kho production để thử schema. Dùng thư mục output lab mới và giữ manifest liên kết segment. Khi nâng version hoặc đổi parser, có thể tái tạo output từ cùng input để xem thay đổi xuất phát ở đâu.
Apache Nutch proxy và ma trận lỗi cần chạy
Một lab có giá trị phải phát hiện được cấu hình sai, không chỉ thành công ở một đường dẫn. Những ca dưới là kế hoạch nghiệm thu, chưa được chạy trên máy soạn. Trước xuất bản, cần bổ sung output thật của runtime mục tiêu.
Ma trận chờ nghiệm thu runtime
Scope và chính sách thu
Ca host ngoài scope phải không được fetch theo filter đã đặt. Ca đường private phải được xử lý theo robots của site lab và chính sách công cụ. Ca redirect ra ngoài cần giữ chuỗi quyết định để biết crawler có vượt phạm vi hay dừng đúng.
Nếu một ca bị loại, log cần cho biết ở bước nào: filter, robots, generate hay fetch. Một URL không có trong output không tự chứng minh chính sách đúng; nó cũng có thể chưa được khám phá hoặc job đã dừng sớm. Expected set cùng log là bằng chứng cần kết hợp.
Tuyến và lỗi truyền tải
Ca proxy đúng cần có request relay và nội dung marker đúng. Ca proxy không nghe cổng cần lỗi chặng kết nối phù hợp. Nếu dùng xác thực, thêm credentials đúng và sai trong môi trường lab riêng, che bí mật khỏi log bàn giao.
Ca origin trả lỗi cần giữ status và không được nhầm thành nội dung thành công. Ca body chậm hoặc quá giới hạn cần trạng thái riêng theo cấu hình đã chọn. Không dùng retry vô hạn để làm mọi lỗi cuối cùng biến mất khỏi thống kê.
Parse và dữ liệu cuối
Ca HTML có marker phải giữ marker sau parse theo yêu cầu. Ca tài liệu ngoài loại hỗ trợ cần được ghi rõ. Ca source đổi nội dung giữa hai lượt cần tạo kết quả có thể truy vết về đúng segment, không ghép text mới với URL hoặc trạng thái cũ.
Nếu muốn đánh giá hiệu suất, làm sau khi những ca chức năng đạt. Giữ tập URL và nội dung ổn định để so. Bài không có benchmark Nutch, số trang mỗi giây hoặc kết quả khách hàng để công bố.
Apache Nutch proxy trước khi bàn giao triển khai
Hồ sơ bàn giao cần tách tài liệu đã đối chiếu với runtime đã kiểm. Trong bản hiện tại, release và thuộc tính được nghiên cứu theo nguồn chính thức, còn chu kỳ crawl chưa chạy. Trạng thái chờ lab phải giữ trong ghi chú đến khi có bằng chứng thay thế.
Những tệp cần giữ cùng kết quả
Giữ release, checksum gói, Java version, danh sách plugin, override, seed và filter. Thêm log từng bước cùng mã segment và báo cáo export. Các tệp này cho phép người nhận biết chính xác cấu hình nào tạo output, không phụ thuộc một ảnh terminal thành công.
Javadoc Nutch hỗ trợ đối chiếu công cụ và API theo release. Nếu dùng mã hoặc plugin tự phát triển, khóa revision riêng. Không gộp thay đổi plugin vào nhãn Nutch 1.23 rồi làm người khác tưởng đó là hành vi bản phát hành gốc.
Điều kiện chuyển từ bản nháp sang đã kiểm
Chỉ bỏ nhãn chờ khi runtime phù hợp chạy đủ direct, proxy, scope âm và đối soát output. Mỗi ca phải có expected output và kết quả thực. Nếu một phần chưa có quyền quan sát, ghi giới hạn thay vì xác nhận cả chu kỳ.
Giữ một workspace lab nhỏ để kiểm lại khi nâng Java hoặc Nutch. Không tái dùng CrawlDb cũ tùy tiện qua version khi release có thay đổi tương thích cần lưu ý. Một bản backup theo chính sách dự án giúp việc thử nâng cấp có thể phục hồi.
Apache Nutch proxy với hợp đồng đối soát từng bước
Một bảng nghiệm thu nên nối URL từ seed đến record cuối. Với site mẫu, trang gốc, a và b là ba nội dung mục tiêu; private, host ngoài scope và response lỗi có nhãn riêng. Danh sách này là thiết kế expected output, chưa phải kết quả Nutch đã tạo.
Kiểm cấu hình đang được runtime đọc
Nếu chạy từ binary distribution, đường dẫn conf thuộc bộ runtime đó. Nếu build từ source, thư mục runtime được tạo có thể có bản conf riêng. Sửa một file trong cây source rồi chạy một runtime khác có thể khiến thay đổi không được đọc, dù XML đã đúng cú pháp.
Biên bản cần ghi thư mục làm việc và đường dẫn cấu hình thực của tiến trình. Nếu có tham số ghi đè theo lệnh, giữ chúng bên cạnh file override. Không kết luận từ nội dung một nutch-site.xml bất kỳ trên máy vì có thể tồn tại nhiều bản phục vụ các job khác nhau.
plugin.includes cũng cần được giữ đủ các thành phần mà job sử dụng. Thay cả danh sách bằng tên protocol duy nhất có thể làm thiếu parser hoặc chức năng khác. Đối chiếu cấu hình release và thay có kiểm, thay vì xóa mọi plugin để đơn giản hóa một lỗi proxy chưa định vị.
Phân biệt số request với số trang mục tiêu
Crawler có thể cần request robots hoặc thực hiện chuyển hướng theo chính sách. Proxy log nhiều hơn ba dòng không tự chứng minh đã crawl ra ngoài, và ít hơn ba dòng cũng chưa đủ chứng minh thiếu trang. Phân loại request theo vai trò rồi đối chiếu tập URL mục tiêu.
Với private bị robots lab loại, cần biết crawler đã đọc robots và áp quyết định phù hợp. Nếu không thấy private chỉ vì trang gốc chưa được parse, ca scope chưa được chứng minh. Đây là lý do cần marker và log của cả bước phát hiện liên kết.
Redirect có thể tạo thêm một request đến đích được phép hoặc một quyết định dừng ở ranh giới. Ghi đường dẫn ban đầu và đích cùng status. Không chỉ giữ URL cuối vì sẽ mất bằng chứng về việc scope đã được áp tại bước chuyển hướng.
Chạy hai lượt không dùng nhầm trạng thái
Lượt direct và lượt qua proxy cần đầu vào trạng thái tương đương. Một CrawlDb sau khi đã fetch có lịch mới có thể không phát cùng danh sách ở lượt tiếp. Nếu so số request hai lượt mà bỏ qua lịch trạng thái, kết luận về proxy sẽ bị nhiễu.
Trong lab nhỏ, dùng hai workspace mới với cùng seed và cấu hình ngoài proxy là một cách tổ chức có thể kiểm. Hoặc dùng một quy trình snapshot trạng thái đã được xác định. Không xóa cơ sở crawl thật để tạo lại trạng thái chỉ vì ví dụ cần lượt sạch.
Sau khi kiểm tuyến, có thể thêm một ca crawl tiếp trên cùng cơ sở để đánh giá cập nhật theo thiết kế. Ca đó có mục tiêu khác với so direct và proxy. Tên ca và expected set phải phản ánh việc trạng thái đầu vào đã thay.
Schema xuất tối thiểu cho bộ marker
Record mẫu nên có URL mục tiêu, status fetch, segment_id và marker text cần thấy. Thêm hash content cùng thời điểm thu nếu bước export giữ được dữ liệu đó. Nếu một trường chưa được công cụ cung cấp, ghi thiếu thay vì tạo giá trị suy đoán từ tên thư mục.
Trang a phải nối với nutch-lab-a và trang b nối với nutch-lab-b. Một bảng có đủ hai marker nhưng gán chéo URL vẫn phải thất bại. Assertion cần kiểm từng cặp khóa và giá trị, không chỉ kiểm tổng số dòng hoặc tập từ xuất hiện đâu đó trong tệp.
Với response lỗi, giữ status và trạng thái nội dung theo schema. Không đưa trang lỗi vào cùng tập thành công chỉ vì có text. Nếu output cuối chỉ nhận trang đạt, báo riêng số record bị loại và lý do để tổng có thể đối soát.
Chọn điểm dừng để lab không thành một crawl lớn
Lab nên có giới hạn số URL, số vòng và thời gian theo thiết kế nhỏ. Những giới hạn đó là chính sách test, không phải cấu hình năng lực tối đa của Nutch. Khi đạt tập mục tiêu, dừng theo quy trình công cụ và giữ log để kiểm.
Nếu kết quả phát hiện nhiều URL ngoài dự kiến, xem filter và chuẩn hóa URL trước khi tăng giới hạn. Một trang có query sinh liên kết có thể làm số URL phình lên dù chỉ trong một host. Phạm vi host không tự bảo đảm tập đường dẫn hữu hạn.
Không dùng vòng crawl tự động nhiều ngày cho ca nghiệm thu đầu tiên. Tách một vòng đủ nhìn chu kỳ, kiểm output rồi mới thêm vòng cập nhật. Cách chia nhỏ giúp lỗi cấu hình được phát hiện khi dữ liệu và log còn dễ đọc.
Hoàn nguyên và ghi phần chưa đạt
Khi lab dừng, đóng origin và proxy do công việc tạo, giữ config cùng report trong thư mục riêng. Nếu đã đặt biến môi trường chỉ cho shell lab, kết thúc shell hoặc phục hồi đúng tên đã thay. Không sửa proxy toàn máy hoặc dừng dịch vụ không thuộc bộ thử.
Một ca chưa chạy phải giữ trạng thái pending, khác failed và passed. Với máy soạn hiện tại, thiếu runtime mục tiêu là lý do chưa có output crawler. Các phép kiểm XML hoặc regex, nếu được thêm, chỉ xác nhận cấu trúc input chứ không được nâng thành kết quả fetch.
File proxy đúng cú pháp chưa chứng minh crawler đi đúng tuyến; cần log fetch và output của cùng một segment.
Anh em hãy lưu dữ liệu mẫu cùng cấu hình và kết quả đối chiếu để lần cập nhật sau có cơ sở kiểm lại. Tham khảo thêm tại Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam. Bắt đầu từ phạm vi nhỏ và tiêu chí rõ ràng khi triển khai Apache Nutch proxy.


